Yuan2.0-M32 FastApi 部署调用
环境准备
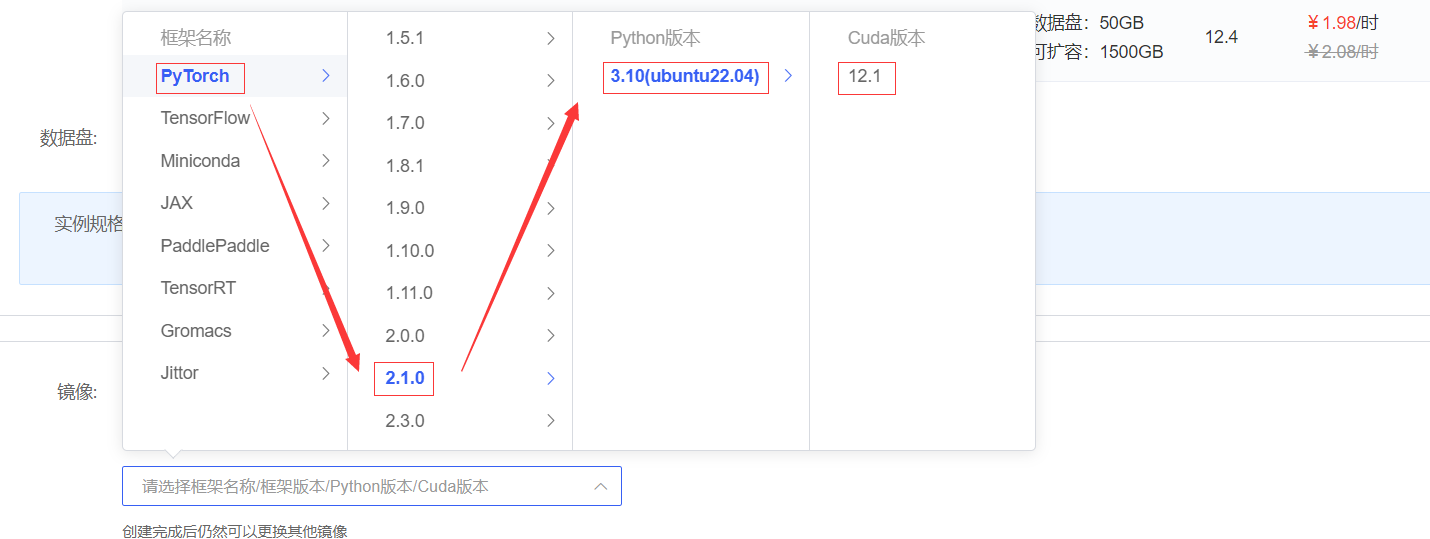
在 Autodl 平台中租赁一个 RTX 3090/24G 显存的显卡机器。如下图所示,镜像选择 PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1。
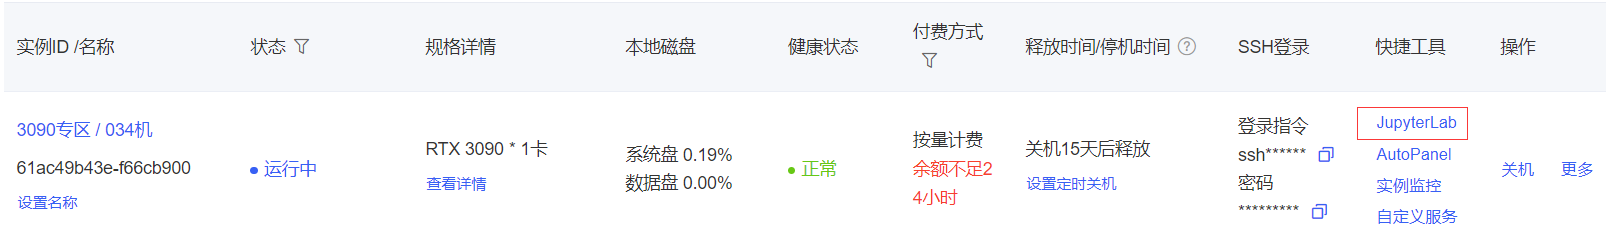
接下来,我们打开刚刚租用服务器的 JupyterLab,如下图所示。
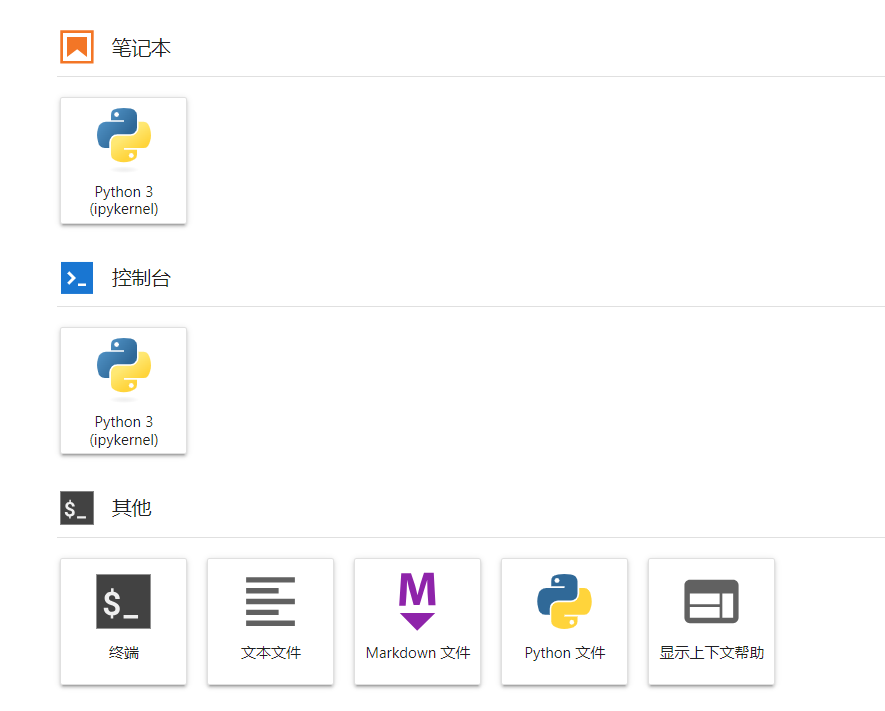
然后打开其中的终端,开始环境配置、模型下载和运行演示。
环境配置
Yuan2-M32-HF-INT4是由原始的Yuan2-M32-HF经过auto-gptq量化而来的模型。
通过模型量化,部署Yuan2-M32-HF-INT4对显存和硬盘的要求都会显著减低。
注:由于pip版本的auto-gptq目前还不支持Yuan2.0 M32,因此需要编译安装
# 升级pip
python -m pip install --upgrade pip

# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

# 拉取Yuan2.0-M32项目
git clone https://github.com/IEIT-Yuan/Yuan2.0-M32.git

# 进入AutoGPTQ
cd  Yuan2.0-M32/3rd_party/AutoGPTQ

# 安装autogptq
pip install --no-build-isolation -e .

# 安装 einops fastapi modelscope
pip install einops fastapi modelscope考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Yuan2.0-M32的镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Yuan2.0-M32
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
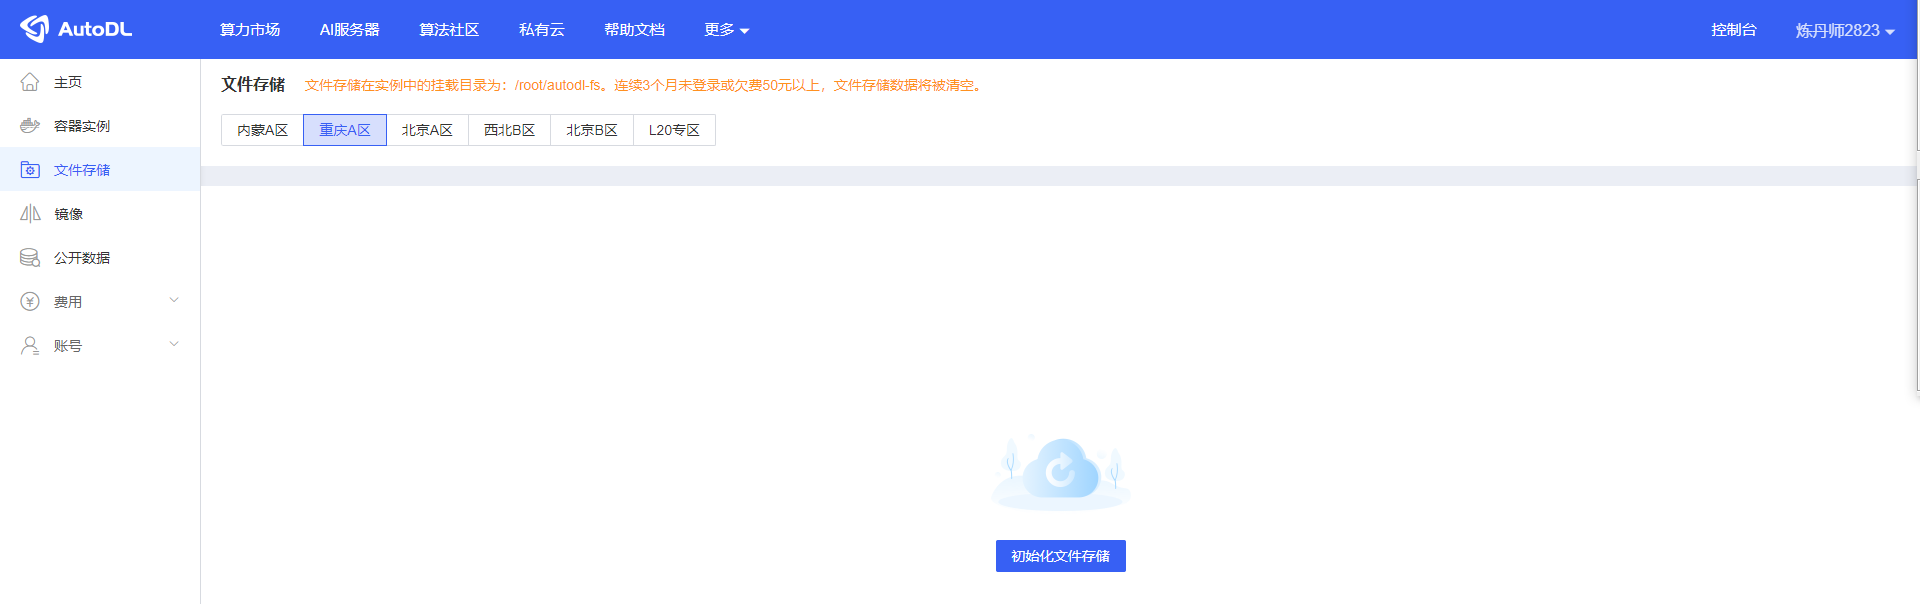
这里可以先进入autodl平台,初始化机器对应区域的的文件存储,文件存储路径为'/root/autodl-fs'。 该存储中的文件不会随着机器的关闭而丢失,这样可以避免模型二次下载。
然后运行下面代码,执行模型下载。
from modelscope import snapshot_download
model_dir = snapshot_download('YuanLLM/Yuan2-M32-HF-INT4', cache_dir='/root/autodl-fs')模型合并
下载后的模型为多个文件,需要将其进行合并。
cat /root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4/gptq_model-4bit-128g.safetensors* > /root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4/gptq_model-4bit-128g.safetensors代码准备
点击自定义服务,开启AutoDL开放端口。

有些区域的机器需要配置AutoDL开放端口,配置方法写在本项目中General-Setting目录,首次使用请参考该文档。
配置方法如下图所示。
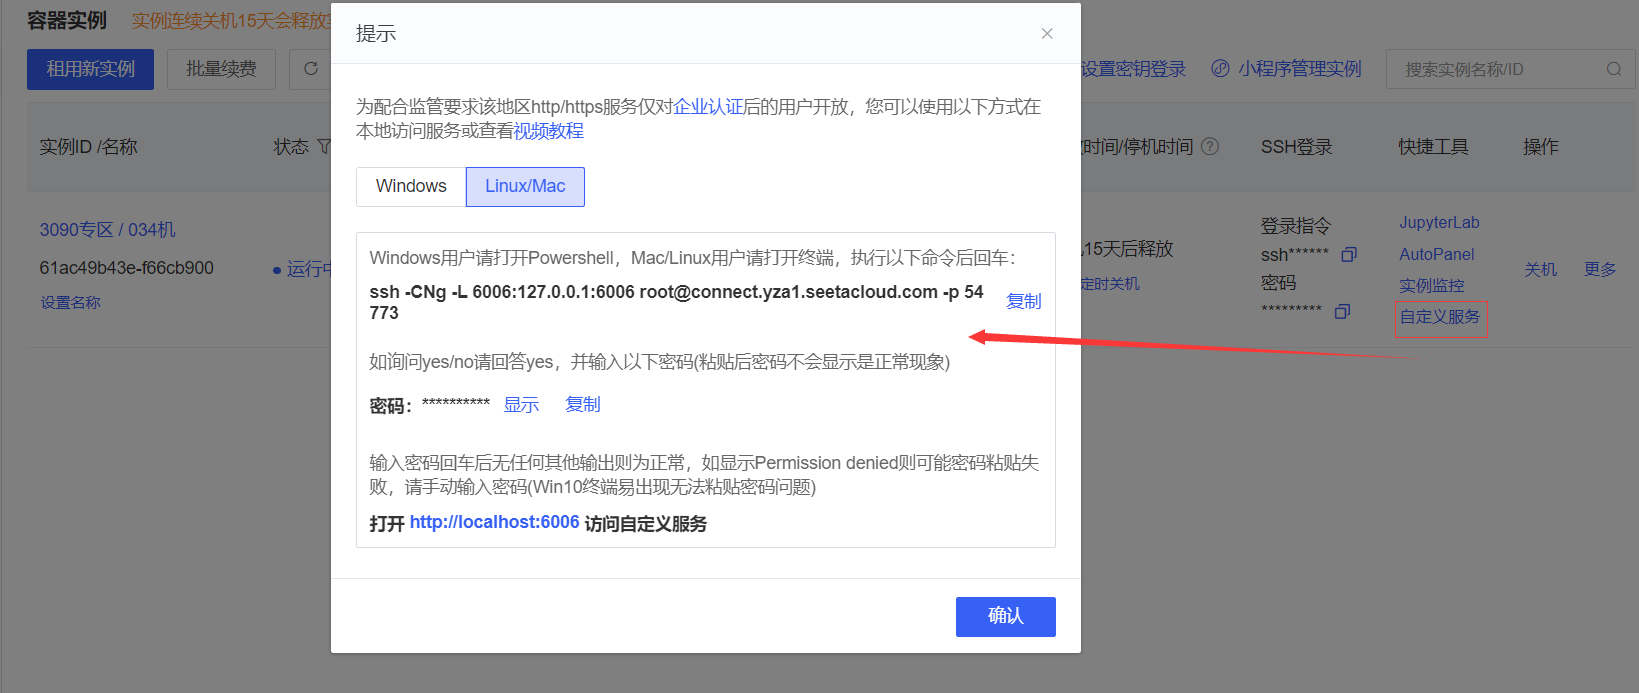
新建 api.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。
下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue。
from fastapi import FastAPI, Request
from auto_gptq import AutoGPTQForCausalLM
from transformers import LlamaTokenizer
import uvicorn
import json
import datetime
import torch

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示

    # 调用模型进行对话生成
    prompt += "<sep>"
    inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
    outputs = model.generate(**inputs, do_sample=False, max_new_tokens=256)
    output = tokenizer.decode(outputs[0])
    response = output.split("<sep>")[-1]

    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串

    # 构建响应JSON
    answer = {
        "response": response,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = "[" + time + "] " + '", prompt:"' + prompt + '", response:"' + repr(response) + '"'
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    # 加载预训练的分词器和模型
    path = '/root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4'

    print("Creat tokenizer...")
    tokenizer = LlamaTokenizer.from_pretrained(path, add_eos_token=False, add_bos_token=False, eos_token='<eod>')
    tokenizer.add_tokens(['<sep>', '<pad>', '<mask>', '<predict>', '<FIM_SUFFIX>', '<FIM_PREFIX>', '<FIM_MIDDLE>','<commit_before>','<commit_msg>','<commit_after>','<jupyter_start>','<jupyter_text>','<jupyter_code>','<jupyter_output>','<empty_output>'], special_tokens=True)

    print("Creat model...")
    model = AutoGPTQForCausalLM.from_quantized(path, trust_remote_code=True).cuda()

    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用Api 部署
在终端输入以下命令启动api服务:
python /root/autodl-tmp/api.py加载完毕后出现如下信息说明成功。
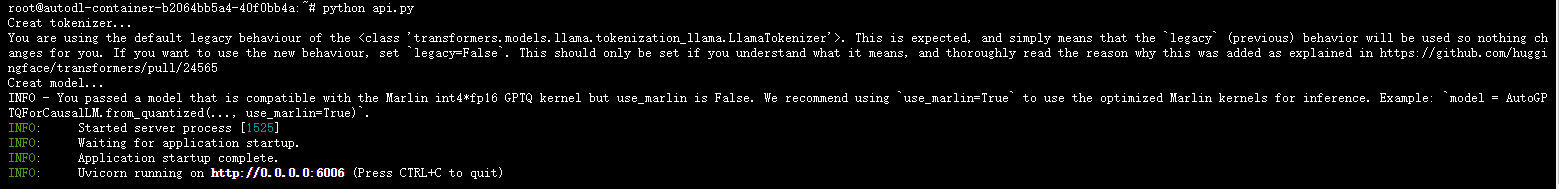
默认部署在 6006 端口,通过 POST 方法进行调用,可以使用 curl 调用,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
     -d '{"prompt": "你好"}'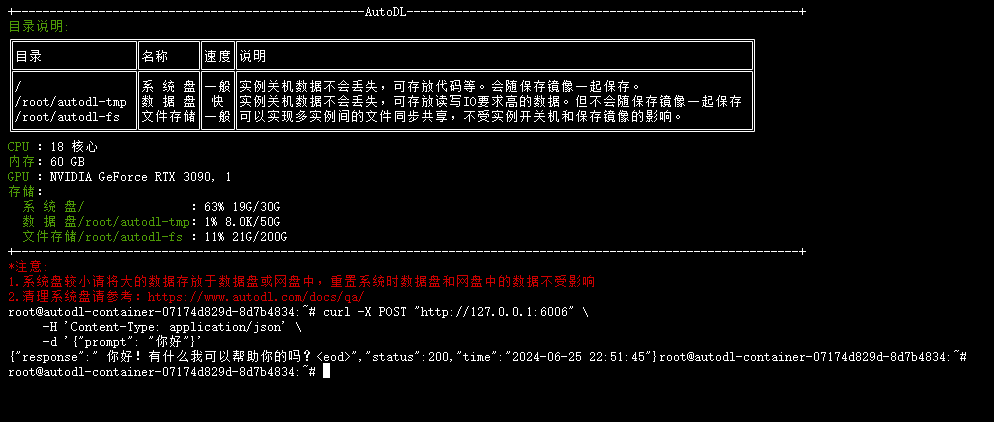
也可以使用 python 中的 requests 库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
    print(get_completion('你好'))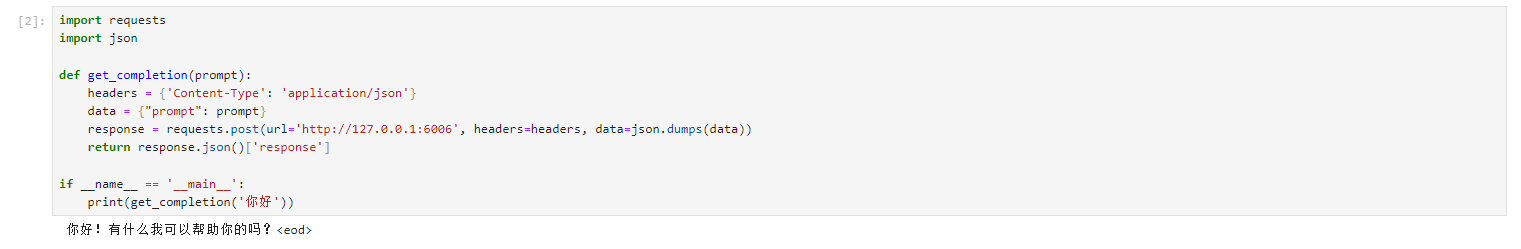
Yuan2.0-M32 接入 LangChain 搭建知识库助手
环境准备
在 Autodl 平台中租赁一个 RTX 3090/24G 显存的显卡机器。如下图所示,镜像选择 PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1。
接下来,我们打开刚刚租用服务器的 JupyterLab,如下图所示。
然后打开其中的终端,开始环境配置、模型下载和运行演示。
环境配置
Yuan2-M32-HF-INT4是由原始的Yuan2-M32-HF经过auto-gptq量化而来的模型。
通过模型量化,部署Yuan2-M32-HF-INT4对显存和硬盘的要求都会显著减低。
注:由于pip版本的auto-gptq目前还不支持Yuan2.0 M32,因此需要编译安装
# 升级pip
python -m pip install --upgrade pip

# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

# 拉取Yuan2.0-M32项目
git clone https://github.com/IEIT-Yuan/Yuan2.0-M32.git

# 进入AutoGPTQ
cd  Yuan2.0-M32/3rd_party/AutoGPTQ

# 安装autogptq
pip install --no-build-isolation -e .

# 安装 einops langchain modelscope
pip install einops langchain modelscope考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Yuan2.0-M32的镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Yuan2.0-M32
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
这里可以先进入autodl平台,初始化机器对应区域的的文件存储,文件存储路径为'/root/autodl-fs'。 该存储中的文件不会随着机器的关闭而丢失,这样可以避免模型二次下载。
然后运行下面代码,执行模型下载。
from modelscope import snapshot_download
model_dir = snapshot_download('YuanLLM/Yuan2-M32-HF-INT4', cache_dir='/root/autodl-fs')模型合并
下载后的模型为多个文件,需要将其进行合并。
cat /root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4/gptq_model-4bit-128g.safetensors* > /root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4/gptq_model-4bit-128g.safetensors代码准备
为便捷构建 LLM 应用,我们需要基于本地部署的 Yuan2,自定义一个 LLM 类,将 Yuan2 接入到 LangChain 框架中。
完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 Yuan2 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from auto_gptq import AutoGPTQForCausalLM
from transformers import LlamaTokenizer
import torch

class Yuan2_LLM(LLM):
    # 基于本地 Yuan2 自定义 LLM 类
    tokenizer: LlamaTokenizer = None
    model: AutoGPTQForCausalLM = None

    def __init__(self, mode_name_or_path :str):
        super().__init__()

        # 加载预训练的分词器和模型
        print("Creat tokenizer...")
        self.tokenizer = LlamaTokenizer.from_pretrained(mode_name_or_path, add_eos_token=False, add_bos_token=False, eos_token='<eod>')
        self.tokenizer.add_tokens(['<sep>', '<pad>', '<mask>', '<predict>', '<FIM_SUFFIX>', '<FIM_PREFIX>', '<FIM_MIDDLE>','<commit_before>','<commit_msg>','<commit_after>','<jupyter_start>','<jupyter_text>','<jupyter_code>','<jupyter_output>','<empty_output>'], special_tokens=True)

        print("Creat model...")
        self.model = AutoGPTQForCausalLM.from_quantized(mode_name_or_path, trust_remote_code=True).cuda()

    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):

        prompt += "<sep>"
        inputs = self.tokenizer(prompt, return_tensors="pt").to(self.model.device)
        outputs = self.model.generate(**inputs, do_sample=False, max_new_tokens=256)
        output = self.tokenizer.decode(outputs[0])
        response = output.split("<sep>")[-1]

        return response

    @property
    def _llm_type(self) -> str:
return "Yuan2_LLM"在上述类定义中,我们分别重写了构造函数和 _call 函数:对于构造函数,我们在对象实例化的一开始加载本地部署的 Yuan2 模型,从而避免每一次调用都需要重新加载模型带来的时间过长;_call 函数是 LLM 类的核心函数,LangChain 会调用该函数来调用 LLM,在该函数中,我们调用已实例化模型的 generate 方法,从而实现对模型的调用并返回调用结果。
在整体项目中,我们将上述代码封装为 LLM.py,后续将直接从该文件中引入自定义的 LLM 类。
调用
然后就可以像使用任何其他的langchain大模型功能一样使用了。
from LLM import Yuan2_LLM
llm = Yuan2_LLM('/root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4')
print(llm("你是谁"))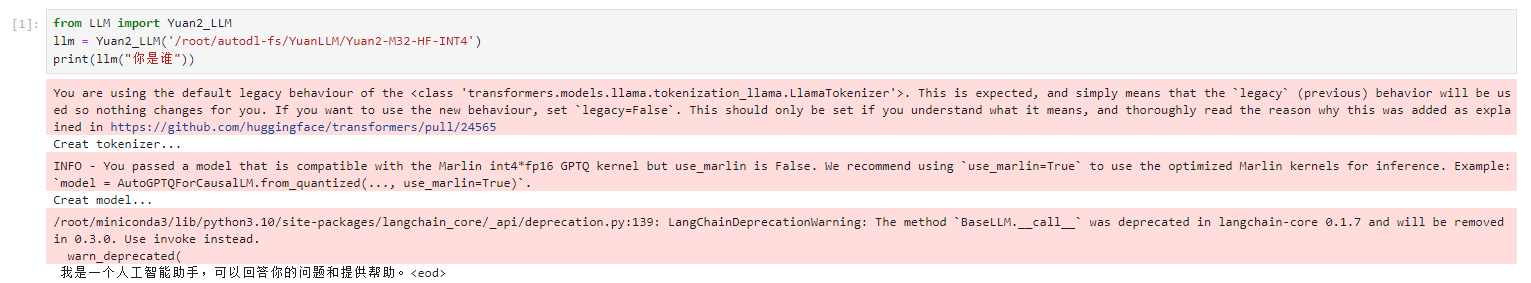
Yuan2.0-M32 WebDemo部署
环境准备
在 Autodl 平台中租赁一个 RTX 3090/24G 显存的显卡机器。如下图所示,镜像选择 PyTorch-->2.1.0-->3.10(ubuntu22.04)-->12.1。
接下来,我们打开刚刚租用服务器的 JupyterLab,如下图所示。
然后打开其中的终端,开始环境配置、模型下载和运行演示。
环境配置
Yuan2-M32-HF-INT4是由原始的Yuan2-M32-HF经过auto-gptq量化而来的模型。
通过模型量化,部署Yuan2-M32-HF-INT4对显存和硬盘的要求都会显著减低。
注:由于pip版本的auto-gptq目前还不支持Yuan2.0 M32,因此需要编译安装
# 升级pip
python -m pip install --upgrade pip

# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

# 拉取Yuan2.0-M32项目
git clone https://github.com/IEIT-Yuan/Yuan2.0-M32.git

# 进入AutoGPTQ
cd  Yuan2.0-M32/3rd_party/AutoGPTQ

# 安装autogptq
pip install --no-build-isolation -e .

# 安装 einops modelscope streamlit
pip install einops modelscope streamlit==1.24.0考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Yuan2.0-M32的镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/Yuan2.0-M32
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
这里可以先进入autodl平台,初始化机器对应区域的的文件存储,文件存储路径为'/root/autodl-fs'。 该存储中的文件不会随着机器的关闭而丢失,这样可以避免模型二次下载。
然后运行下面代码,执行模型下载。
from modelscope import snapshot_download
model_dir = snapshot_download('YuanLLM/Yuan2-M32-HF-INT4', cache_dir='/root/autodl-fs')模型合并
下载后的模型为多个文件,需要将其进行合并。
cat /root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4/gptq_model-4bit-128g.safetensors* > /root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4/gptq_model-4bit-128g.safetensors代码准备
在/root/autodl-tmp路径下新建 chatBot.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出issue。
chatBot.py代码如下
# 导入所需的库
from auto_gptq import AutoGPTQForCausalLM
from transformers import LlamaTokenizer
import torch
import streamlit as st

# 在侧边栏中创建一个标题和一个链接
with st.sidebar:
    st.markdown("## Yuan2.0-M32 LLM")
    "[开源大模型食用指南 self-llm](https://github.com/datawhalechina/self-llm.git)"
    # 创建一个滑块,用于选择最大长度,范围在0到1024之间,默认值为512
    max_length = st.slider("max_length", 0, 1024, 512, step=1)

# 创建一个标题和一个副标题
st.title("💬 Yuan2.0-M32 Chatbot")
st.caption("🚀 A streamlit chatbot powered by Self-LLM")

# 定义模型路径
path = '/root/autodl-fs/YuanLLM/Yuan2-M32-HF-INT4'

# 定义一个函数,用于获取模型和tokenizer
@st.cache_resource
def get_model():
    print("Creat tokenizer...")
    tokenizer = LlamaTokenizer.from_pretrained(path, add_eos_token=False, add_bos_token=False, eos_token='<eod>')
    tokenizer.add_tokens(['<sep>', '<pad>', '<mask>', '<predict>', '<FIM_SUFFIX>', '<FIM_PREFIX>', '<FIM_MIDDLE>','<commit_before>','<commit_msg>','<commit_after>','<jupyter_start>','<jupyter_text>','<jupyter_code>','<jupyter_output>','<empty_output>'], special_tokens=True)

    print("Creat model...")
    model = AutoGPTQForCausalLM.from_quantized(path, trust_remote_code=True).cuda()

    return tokenizer, model

# 加载model和tokenizer
tokenizer, model = get_model()

# 如果session_state中没有"messages",则创建一个包含默认消息的列表
if "messages" not in st.session_state:
    st.session_state["messages"] = [{"role": "assistant", "content": "有什么可以帮您的?"}]

# 遍历session_state中的所有消息,并显示在聊天界面上
for msg in st.session_state.messages:
    st.chat_message(msg["role"]).write(msg["content"])

# 如果用户在聊天输入框中输入了内容,则执行以下操作
if prompt := st.chat_input():
    # 将用户的输入添加到session_state中的messages列表中
    st.session_state.messages.append({"role": "user", "content": prompt})

    # 在聊天界面上显示用户的输入
    st.chat_message("user").write(prompt)

    # 调用模型
    input_str = "<n>".join(msg["content"] for msg in st.session_state.messages) + "<sep>"
    inputs = tokenizer(input_str, return_tensors="pt").to(model.device)
    outputs = model.generate(**inputs, do_sample=False, max_new_tokens=256)
    output = tokenizer.decode(outputs[0])
    response = output.split("<sep>")[-1].replace("<eod>", '')

    # 将模型的输出添加到session_state中的messages列表中
    st.session_state.messages.append({"role": "assistant", "content": response})

    # 在聊天界面上显示模型的输出
    st.chat_message("assistant").write(response)

# print(st.session_state)复制机器ssh登录指令
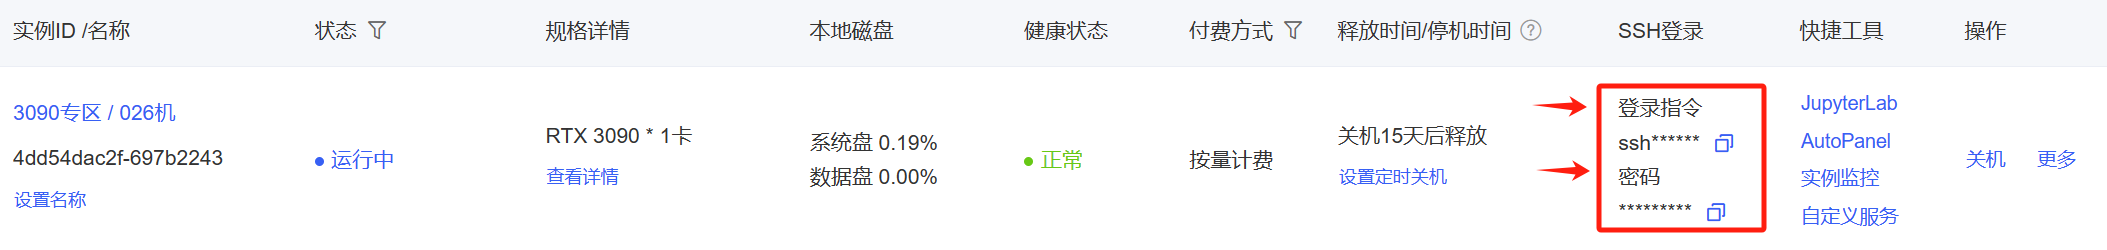
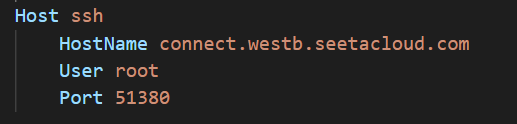
粘贴到本地电脑的.ssh/config,并修改成如下格式
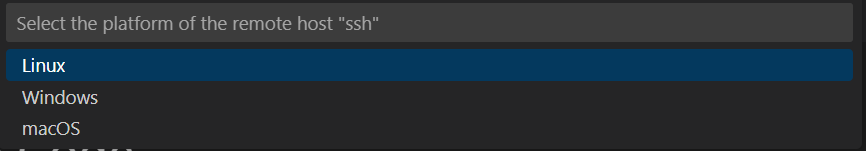
然后连接到此ssh,选择linx
复制密码并输入,按下回车即可登录到机器
运行demo
在终端中运行以下命令,启动streamlit服务
streamlit run chatBot.py --server.address 127.0.0.1 --server.port 6006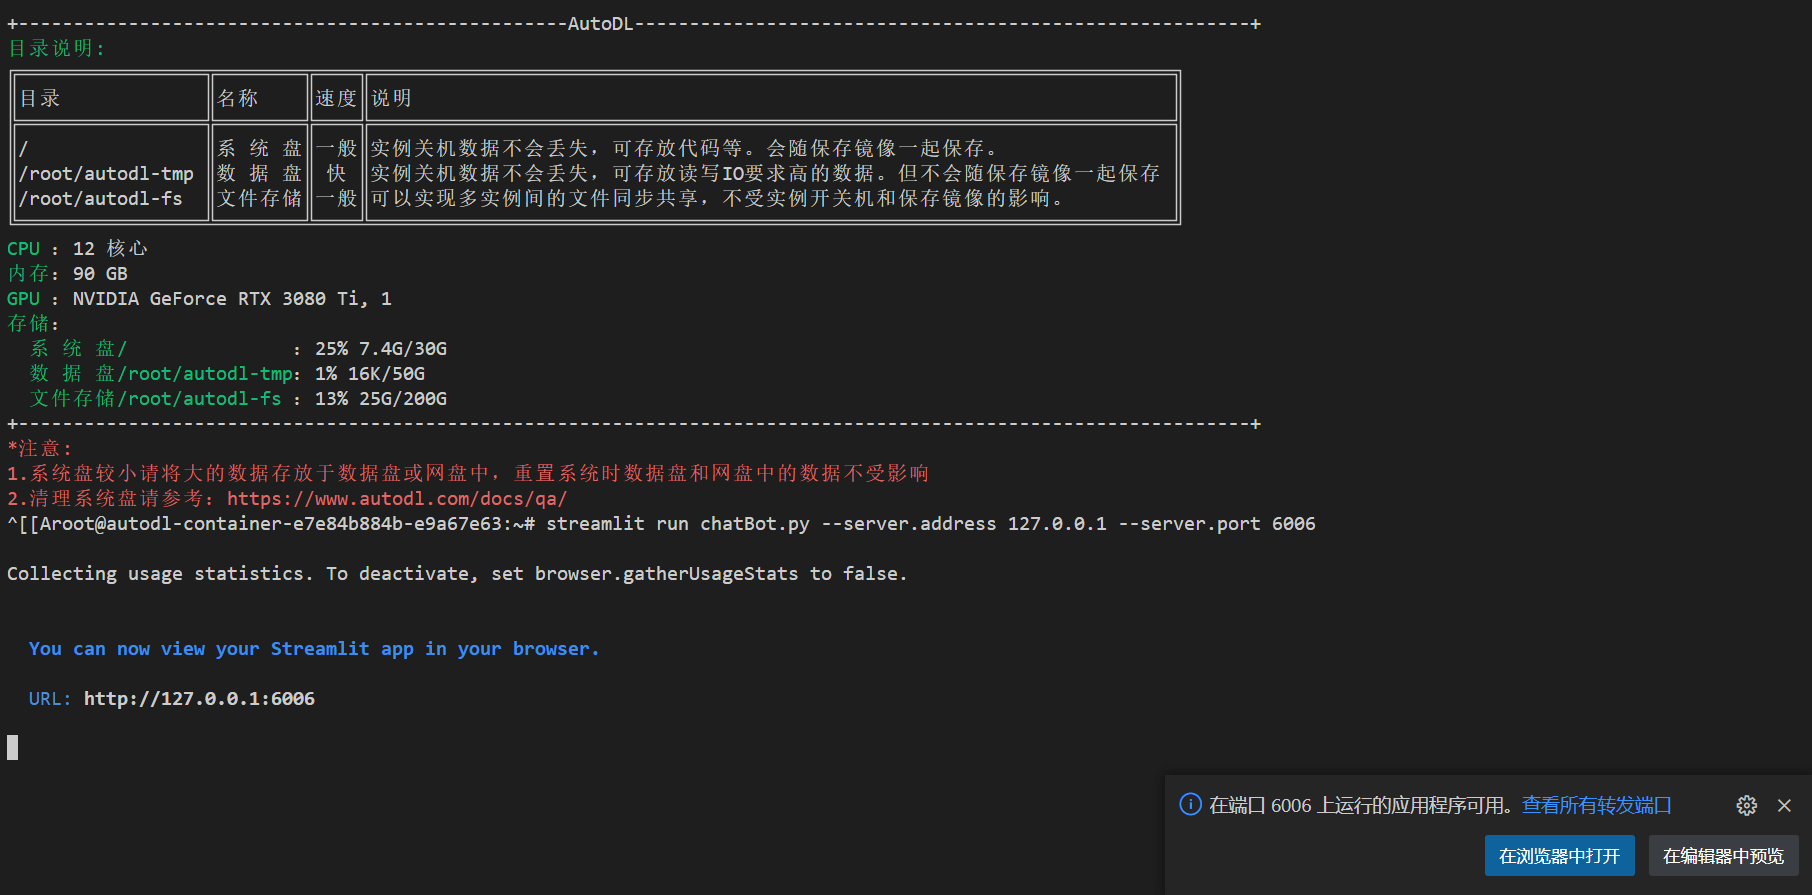
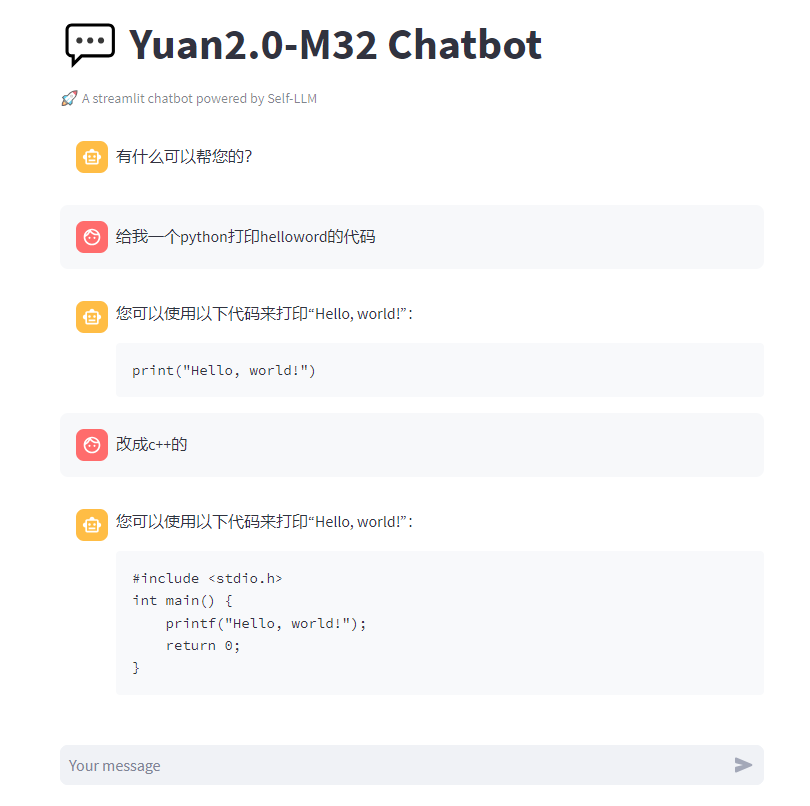
点击在浏览器中打开,即可看到聊天界面。
运行效果如下:
README
- 模型简介
浪潮信息 “源2.0 M32”大模型(简称,Yuan2.0-M32) 采用稀疏混合专家架构(MoE),以Yuan2.0-2B模型作为基底模型,通过创新的门控网络(Attention Router)实现32个专家间(Experts*32)的协同工作与任务调度,在显著降低模型推理算力需求的情况下,带来了更强的模型精度表现与推理性能;源2.0-M32在多个业界主流的评测进行了代码生成、数学问题求解、科学问答与综合知识能力等方面的能力测评。结果显示,源2.0-M32在多项任务评测中,展示出了较为先进的能力表现,MATH(数学求解)、ARC-C(科学问答)测试精度超过LLaMA3-700亿模型。
Yuan2.0-M32大模型 基本信息如下:
- 模型参数量: 40B + 专家数量: 32 + 激活专家数: 2 + 激活参数量: 3.7B + 训练数据量: 2000B tokens + 支持序列长度: 16K
项目地址:https://github.com/IEIT-Yuan/Yuan2.0-M32
官方报道:https://mp.weixin.qq.com/s/WEVyYq9BkTTlO6EAfiCf6w
技术报告:https://arxiv.org/abs/2405.17976
- 模型下载
Yuan2.0-M32提供了多种模型格式,下载链接如下表所示:
| 模型 | 序列长度 | 模型格式 | 下载链接 |
| Yuan2.0-M32 | 16K | Megatron | ModelScope | HuggingFace | 百度网盘 | 始智AI
| Yuan2.0-M32-HF | 16K | HuggingFace | ModelScope | HuggingFace | 百度网盘| 始智AI
| Yuan2.0-M32-GGUF | 16K | GGUF | ModelScope | HuggingFace | 百度网盘 | 始智AI
| Yuan2.0-M32-GGUF-INT4 | 16K | GGUF | ModelScope | HuggingFace | 百度网盘 | 始智AI
| Yuan2.0-M32-HF-INT4 | 16K | HuggingFace | ModelScope | HuggingFace | 百度网盘 | 始智AI
- 教程简介
在上一节介绍的多个模型中,Yuan2-M32-HF-INT4是由原始的Yuan2-M32-HF经过auto-gptq量化而来的模型。
通过模型量化,部署Yuan2-M32-HF-INT4对显存和硬盘的要求都会显著减低。
使用3090部署Yuan2-M32-HF-INT4的显存占用如下图所示:
因此,本教程以Yuan2-M32-HF-INT4为基础,介绍以下内容:
01-Yuan2.0-M32 FastApi 部署调用
02-Yuan2.0-M32 Langchain 接入
03-Yuan2.0-M32 WebDemo部署