Qwen2.5-7B-Instruct FastApi 部署调用
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
首先 pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install requests==2.31.0
pip install fastapi==0.115.1
pip install uvicorn==0.30.6
pip install transformers==4.46.2
pip install huggingface-hub==0.26.2
pip install accelerate==0.34.2
pip install modelscope==1.20.0考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Qwen2.5的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/qwen2.5-coder
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 15GB,下载模型大概需要 5 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('qwen/Qwen2.5-Coder-7B-Instruct', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
新建 api.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。以下代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue 。
from fastapi import FastAPI, Request
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig
import uvicorn
import json
import datetime
import torch

# 设置设备参数
DEVICE = "cuda"  # 使用CUDA
DEVICE_ID = "0"  # CUDA设备ID,如果未设置则为空
CUDA_DEVICE = f"{DEVICE}:{DEVICE_ID}" if DEVICE_ID else DEVICE  # 组合CUDA设备信息

# 清理GPU内存函数
def torch_gc():
    if torch.cuda.is_available():  # 检查是否可用CUDA
        with torch.cuda.device(CUDA_DEVICE):  # 指定CUDA设备
            torch.cuda.empty_cache()  # 清空CUDA缓存
            torch.cuda.ipc_collect()  # 收集CUDA内存碎片

# 创建FastAPI应用
app = FastAPI()

# 处理POST请求的端点
@app.post("/")
async def create_item(request: Request):
    global model, tokenizer  # 声明全局变量以便在函数内部使用模型和分词器
    json_post_raw = await request.json()  # 获取POST请求的JSON数据
    json_post = json.dumps(json_post_raw)  # 将JSON数据转换为字符串
    json_post_list = json.loads(json_post)  # 将字符串转换为Python对象
    prompt = json_post_list.get('prompt')  # 获取请求中的提示

    messages = [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": prompt}
    ]

    # 调用模型进行对话生成
    input_ids = tokenizer.apply_chat_template(messages,tokenize=False,add_generation_prompt=True)
    model_inputs = tokenizer([input_ids], return_tensors="pt").to('cuda')
    generated_ids = model.generate(model_inputs.input_ids,max_new_tokens=512)
    generated_ids = [
        output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]
    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
    now = datetime.datetime.now()  # 获取当前时间
    time = now.strftime("%Y-%m-%d %H:%M:%S")  # 格式化时间为字符串
    # 构建响应JSON
    answer = {
        "response": response,
        "status": 200,
        "time": time
    }
    # 构建日志信息
    log = "[" + time + "] " + '", prompt:"' + prompt + '", response:"' + repr(response) + '"'
    print(log)  # 打印日志
    torch_gc()  # 执行GPU内存清理
    return answer  # 返回响应

# 主函数入口
if __name__ == '__main__':
    # 加载预训练的分词器和模型
    model_name_or_path = '/root/autodl-tmp/qwen/Qwen2___5-Coder-7B-Instruct'
    tokenizer = AutoTokenizer.from_pretrained(model_name_or_path, use_fast=False)
    model = AutoModelForCausalLM.from_pretrained(model_name_or_path, device_map="auto", torch_dtype=torch.bfloat16)

    # 启动FastAPI应用
    # 用6006端口可以将autodl的端口映射到本地,从而在本地使用api
uvicorn.run(app, host='0.0.0.0', port=6006, workers=1) # 在指定端口和主机上启动应用注意:记得修改
model_name_or_path为你的模型下载路径哦~
Api 部署
在终端输入以下命令启动api服务:
cd /root/autodl-tmp
python api.py
# or
python /root/autodl-tmp/api.py加载完毕后出现如下信息说明成功。

默认部署在 6006 端口,通过 POST 方法进行调用,可以使用 curl 调用,如下所示:
curl -X POST "http://127.0.0.1:6006" \
     -H 'Content-Type: application/json' \
-d '{"prompt": "帮我生成一份深度学习网络训练的python代码。"}'得到的返回值如下所示:
{"response":" 当然可以!以下是一个使用TensorFlow和Keras构建和训练简单卷积神经网络(CNN)的Python代码示例。这个示例使用了MNIST数据集,这是一个手写数字识别的数据集。\n\n```python\nimport tensorflow as tf\nfrom tensorflow.keras import layers, models\n\n# 加载MNIST数据集\n(train_images, train_labels), (test_images, test_labels) = tf.keras.datasets.mnist.load_data()\n\n# 归一化像素值到0-1之间\ntrain_images, test_images = train_images / 255.0, test_images / 255.0\n\n# 将标签转换为one-hot编码\ntrain_labels = tf.keras.utils.to_categorical(train_labels)\ntest_labels = tf.keras.utils.to_categorical(test_labels)\n\n# 构建卷积神经网络模型\nmodel = models.Sequential([\n layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),\n layers.MaxPooling2D((2, 2)),\n layers.Conv2D(64, (3, 3), activation='relu'),\n layers.MaxPooling2D((2, 2)),\n layers.Conv2D(64, (3, 3), activation='relu'),\n layers.Flatten(),\n layers.Dense(64, activation='relu'),\n layers.Dense(10, activation='softmax')\n])\n\n# 编译模型\nmodel.compile(optimizer='adam',\n loss='categorical_crossentropy',\n metrics=['accuracy'])\n\n# 训练模型\nhistory = model.fit(train_images.reshape(-1, 28, 28, 1), train_labels,\n epochs=5,\n validation_data=(test_images.reshape(-1, 28, 28, 1), test_labels))\n\n# 评估模型\ntest_loss, test_acc = model.evaluate(test_images.reshape(-1, 28, 28, 1), test_labels, verbose=2)\nprint(f'\\nTest accuracy: {test_acc}')\n\n# 绘制训练过程中的准确率和损失\nimport matplotlib.pyplot as plt\n\nplt.figure(figsize=(12, 4))\nplt.subplot(1, 2, 1)\nplt.plot(history.history['accuracy'], label='Training Accuracy')\nplt.plot(history.history['val_accuracy'], label='Validation Accuracy')\nplt.xlabel('Epochs')\nplt.ylabel('Accuracy')\nplt.legend()\nplt.title","status":200,"time":"2024-11-15 13:47:30"}对应的python代码:
import tensorflow as tf
from tensorflow.keras import layers, models

# 加载MNIST数据集
(train_images, train_labels), (test_images, test_labels) = tf.keras.datasets.mnist.load_data()

# 归一化像素值到0-1之间
train_images, test_images = train_images / 255.0, test_images / 255.0

# 将标签转换为one-hot编码
train_labels = tf.keras.utils.to_categorical(train_labels)
test_labels = tf.keras.utils.to_categorical(test_labels)

# 构建卷积神经网络模型
model = models.Sequential([
    layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)),
    layers.MaxPooling2D((2, 2)),
    layers.Conv2D(64, (3, 3), activation='relu'),
    layers.MaxPooling2D((2, 2)),
    layers.Conv2D(64, (3, 3), activation='relu'),
    layers.Flatten(),
    layers.Dense(64, activation='relu'),
    layers.Dense(10, activation='softmax')
])

# 编译模型
model.compile(optimizer='adam',
              loss='categorical_crossentropy',
              metrics=['accuracy'])

# 训练模型
history = model.fit(train_images.reshape(-1, 28, 28, 1), train_labels,
                    epochs=5,
                    validation_data=(test_images.reshape(-1, 28, 28, 1), test_labels))

# 评估模型
test_loss, test_acc = model.evaluate(test_images.reshape(-1, 28, 28, 1), test_labels, verbose=2)
print(f'\nTest accuracy: {test_acc}')

# 绘制训练过程中的准确率和损失
import matplotlib.pyplot as plt

plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(history.history['accuracy'], label='Training Accuracy')
plt.plot(history.history['val_accuracy'], label='Validation Accuracy')
plt.xlabel('Epochs')
plt.ylabel('Accuracy')
plt.legend()
plt.title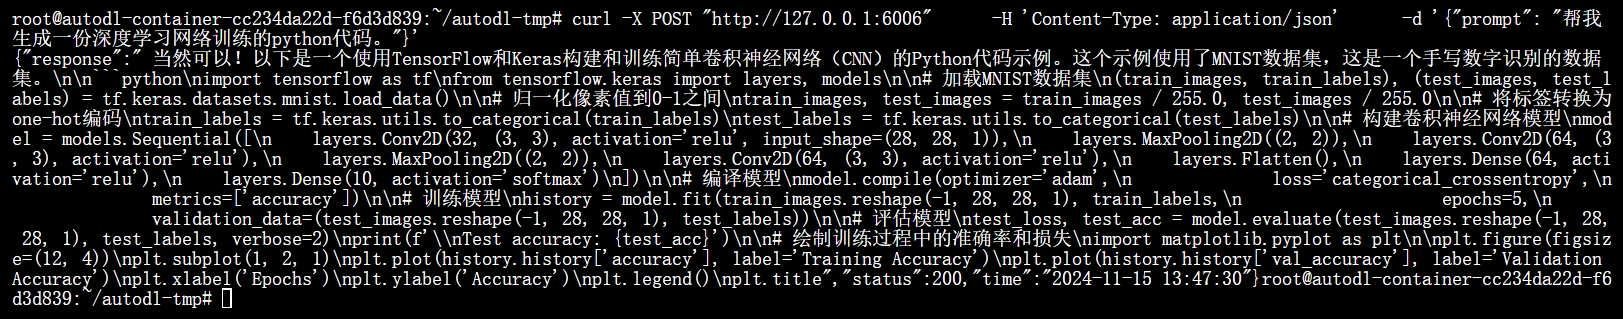
也可以使用 python 中的 requests 库进行调用,如下所示:
import requests
import json

def get_completion(prompt):
    headers = {'Content-Type': 'application/json'}
    data = {"prompt": prompt}
    response = requests.post(url='http://127.0.0.1:6006', headers=headers, data=json.dumps(data))
    return response.json()['response']

if __name__ == '__main__':
print(get_completion('帮我生成一份深度学习网络训练的python代码(pytorch)。'))得到的返回值如下所示:
当然可以!下面是一个使用PyTorch进行深度学习网络训练的示例代码。这个示例使用了一个简单的卷积神经网络(CNN)来分类MNIST数据集。
import torch
import torch.nn as nn
import torch.optim as optim
from torchvision import datasets, transforms

# 定义超参数
batch_size = 64
learning_rate = 0.001
num_epochs = 5

# 数据预处理
transform = transforms.Compose([
    transforms.ToTensor(),
    transforms.Normalize((0.5,), (0.5,))
])

# 加载MNIST数据集
train_dataset = datasets.MNIST(root='./data', train=True, transform=transform, download=True)
test_dataset = datasets.MNIST(root='./data', train=False, transform=transform)

# 创建数据加载器
train_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=batch_size, shuffle=True)
test_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=False)

# 定义卷积神经网络模型
class CNN(nn.Module):
    def __init__(self):
        super(CNN, self).__init__()
        self.conv1 = nn.Conv2d(1, 32, kernel_size=3, stride=1, padding=1)
        self.relu = nn.ReLU()
        self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)
        self.fc1 = nn.Linear(32 * 14 * 14, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        out = self.conv1(x)
        out = self.relu(out)
        out = self.pool(out)
        out = out.view(out.size(0), -1)
        out = self.fc1(out)
        out = self.relu(out)
        out = self.fc2(out)
        return out

model = CNN()

# 定义损失函数和优化器
criterion = nn.CrossEntropyLoss()
optimizer = optim.Adam(model.parameters(), lr=learning_rate)

# 训练模型
for epoch in range(num_epochs):
    model.train()
    for i, (images, labels) in enumerate(train_loader):
        # 前向传播
        outputs = model(images)
        loss = criterion(outputs, labels)

# 反向传播和优化这里代码不完全是因为设置了max_new_tokens=512。
Qwen2.5-7B-Instruct Langchain 接入
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
pip 换源加速下载并安装依赖包
# 升级pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install transformers==4.46.2
pip install modelscope==1.20.0
pip install langchain==0.3.7
pip install accelerate==1.1.1考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Qwen2.5的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/qwen2.5-coder
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 16 GB,下载模型大概需要 12 分钟。
import torch
from modelscope import snapshot_download, AutoModel, AutoTokenizer
import os
model_dir = snapshot_download('Qwen/Qwen2.5-Coder-7B-Instruct', cache_dir='/root/autodl-tmp', revision='master')注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
为便捷构建 LLM 应用,我们需要基于本地部署的 Qwen2_5_Coder,自定义一个 LLM 类,将 Qwen2.5-Coder 接入到 LangChain 框架中。完成自定义 LLM 类之后,可以以完全一致的方式调用 LangChain 的接口,而无需考虑底层模型调用的不一致。
基于本地部署的 Qwen2_5_Coder 自定义 LLM 类并不复杂,我们只需从 LangChain.llms.base.LLM 类继承一个子类,并重写构造函数与 _call 函数即可:
在当前路径新建一个 LLM.py 文件,并输入以下内容,粘贴代码后记得保存文件。
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig, LlamaTokenizerFast
import torch

class Qwen2_5_Coder(LLM):
    # 基于本地 Qwen2_5-Coder 自定义 LLM 类
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None
    def __init__(self, mode_name_or_path :str):

        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(mode_name_or_path, use_fast=False)
        self.model = AutoModelForCausalLM.from_pretrained(mode_name_or_path, torch_dtype=torch.bfloat16, device_map="auto")
        self.model.generation_config = GenerationConfig.from_pretrained(mode_name_or_path)
        print("完成本地模型的加载")

    def _call(self, prompt : str, stop: Optional[List[str]] = None,
                run_manager: Optional[CallbackManagerForLLMRun] = None,
                **kwargs: Any):

        messages = [{"role": "user", "content": prompt }]
        input_ids = self.tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)
        model_inputs = self.tokenizer([input_ids], return_tensors="pt").to('cuda')
        generated_ids = self.model.generate(model_inputs.input_ids, attention_mask=model_inputs['attention_mask'], max_new_tokens=512)
        generated_ids = [
            output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
        ]
        response = self.tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]
        return response
    @property
    def _llm_type(self) -> str:
return "Qwen2_5_Coder"在上述类定义中,我们分别重写了构造函数和 _call 函数:对于构造函数,我们在对象实例化的一开始加载本地部署的 Qwen2_5_Coder 模型,从而避免每一次调用都需要重新加载模型带来的时间过长;_call 函数是 LLM 类的核心函数,LangChain 会调用该函数来调用 LLM,在该函数中,我们调用已实例化模型的 generate 方法,从而实现对模型的调用并返回调用结果。
在整体项目中,我们将上述代码封装为 LLM.py,后续将直接从该文件中引入自定义的 LLM 类。
调用
然后就可以像使用任何其他的langchain大模型功能一样使用了。
注意:记得修改模型路径为你的路径哦~
from LLM import Qwen2_5_Coder
llm = Qwen2_5_Coder(mode_name_or_path = "autodl-tmp/Qwen/Qwen2___5-Coder-7B-Instruct")
print(llm.invoke("你是谁"))结果如下:
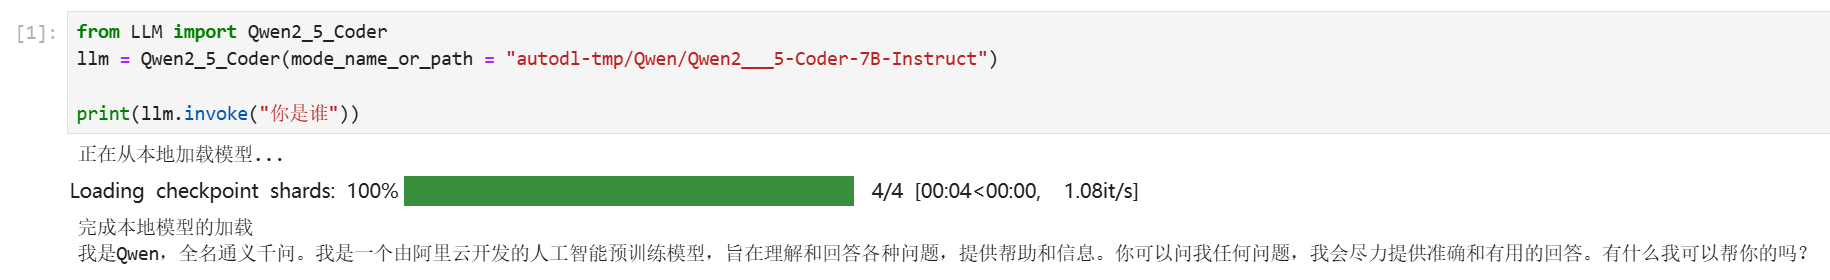
既然是Coder模型,当然要试着让它编写代码
text = llm.invoke("为我用python写一个简单的猜拳小游戏,三局两胜")
print(text)结果如下:
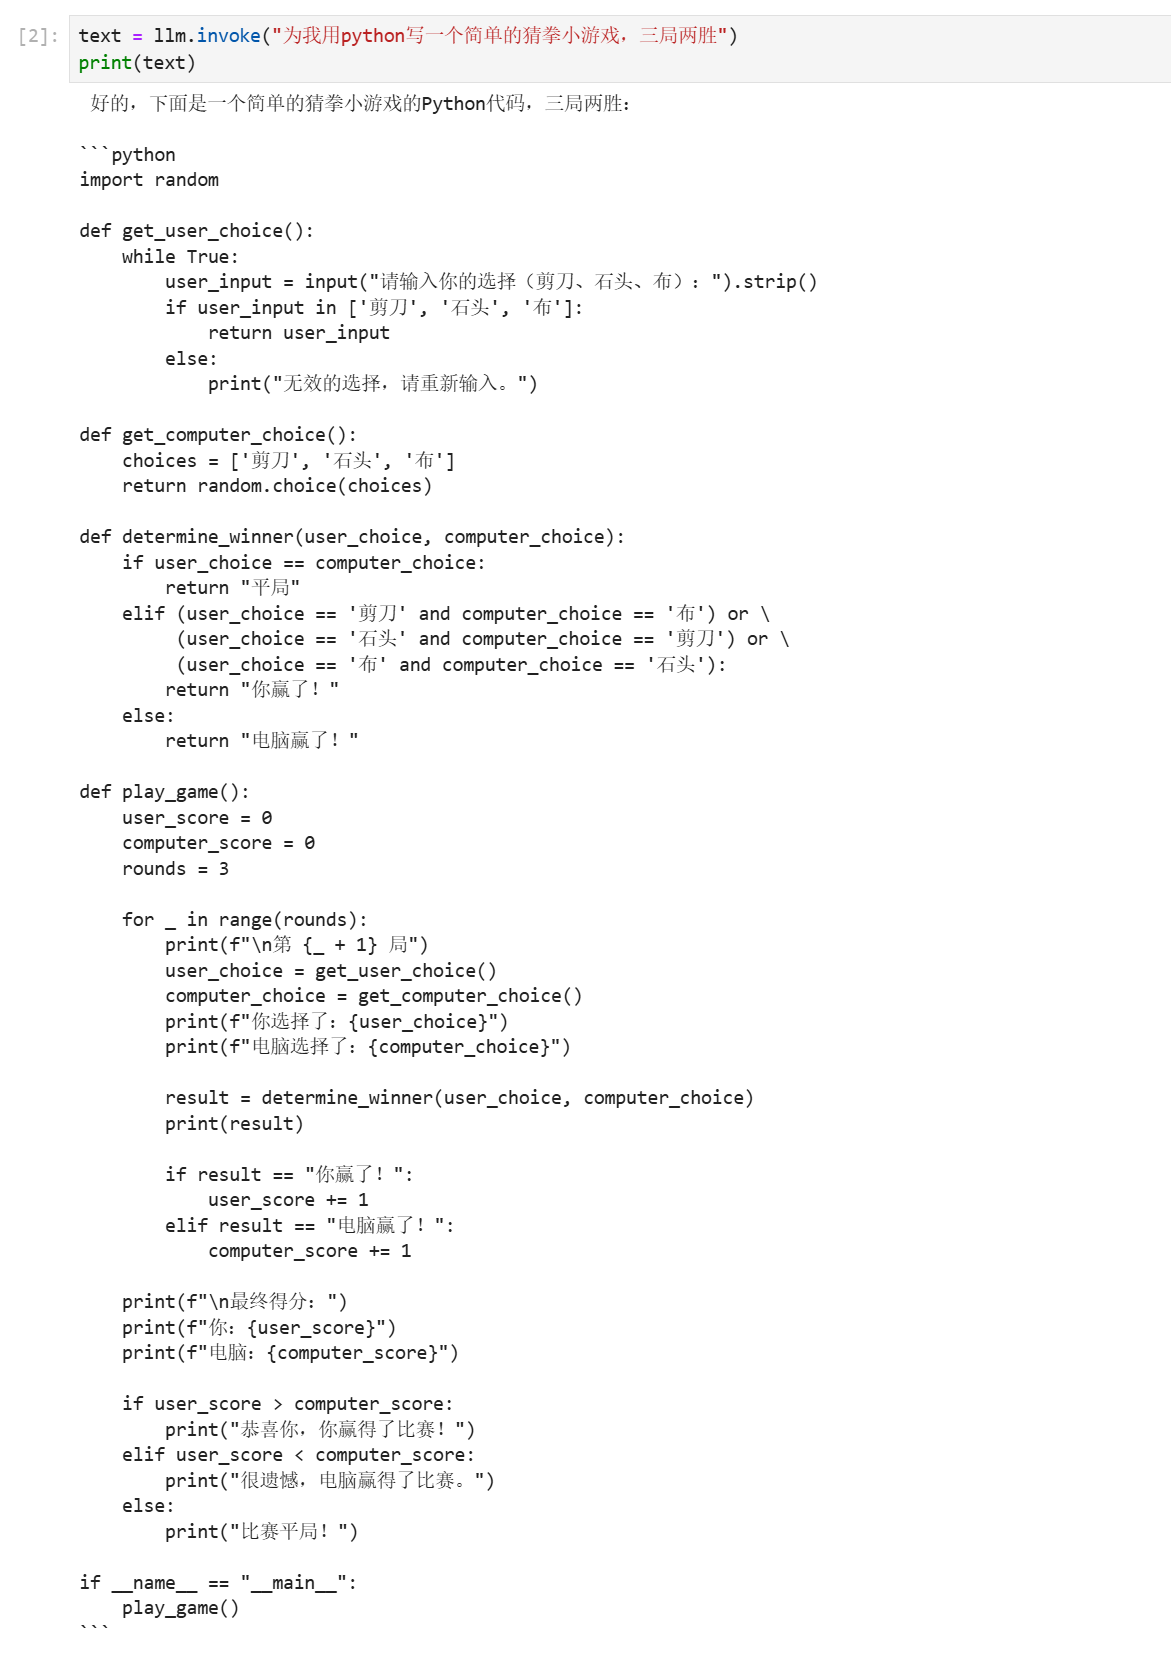
我们试着运行一下这段代码:
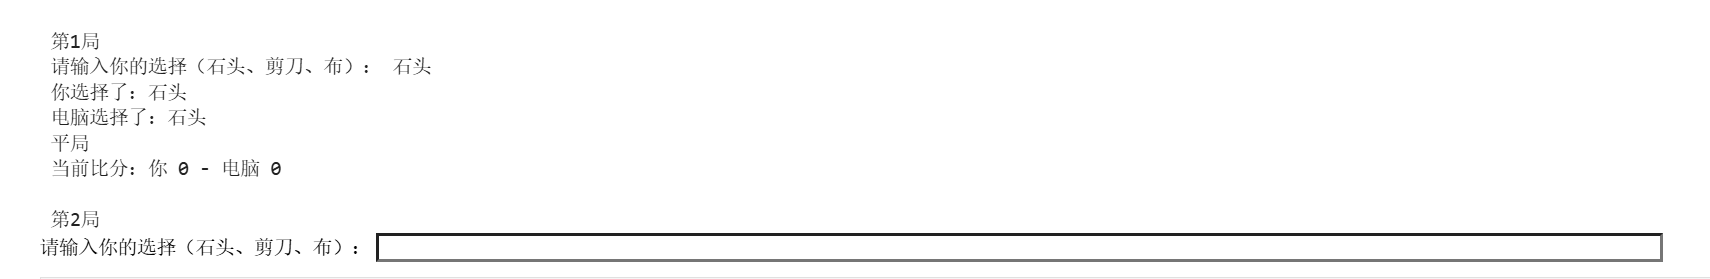
成功运行!
Qwen2_5-7B-Instruct WebDemo 部署
环境准备
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------本文默认学习者已安装好以上 Pytorch(cuda) 环境,如未安装请自行安装。
pip 换源加速下载并安装依赖包
# 升级 pip
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.20.0
pip install streamlit==1.37.0
pip install transformers==4.46.2
pip install accelerate==0.26.0考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Qwen2.5的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/qwen2.5-coder
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 16 GB,下载模型大概需要 12 分钟。
from modelscope import snapshot_download

snapshot_download('Qwen/Qwen2.5-Coder-7B-Instruct', local_dir='/root/autodl-tmp/Qwen2.5-Coder-7B-Instruct')注意:记得修改
local_dir为你的模型下载路径哦~
代码准备
在/root/autodl-tmp路径下新建 chatBot.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。下面的代码有很详细的注释,大家如有不理解的地方,欢迎提出 issue。
# 导入所需的库
from transformers import AutoTokenizer, AutoModelForCausalLM, GenerationConfig, TextIteratorStreamer
from threading import Thread
import torch
import streamlit as st

# 在侧边栏中创建一个标题和一个链接
with st.sidebar:
    st.markdown("## Qwen2.5-Coder-7B-Instruct LLM")
    "[开源大模型食用指南 self-llm](https://github.com/datawhalechina/self-llm.git)"
    # 创建一个滑块,用于选择最大长度,范围在0到1024之间,默认值为512
    max_length = st.slider("max_length", 0, 1024, 512, step=1)

# 创建一个标题和一个副标题
st.title("💬 Qwen2.5-Coder-7B-Instruct Chatbot")
st.caption("🚀 A streamlit chatbot powered by Self-LLM")

# 定义模型路径
model_name_or_path = './Qwen2.5-Coder-7B-Instruct'

# 定义一个函数,用于获取模型和tokenizer
@st.cache_resource
def get_model():
    # 从预训练的模型中获取tokenizer
    tokenizer = AutoTokenizer.from_pretrained(model_name_or_path, use_fast=False, trust_remote_code=True)
    # 从预训练的模型中获取模型,并设置模型参数
    model = AutoModelForCausalLM.from_pretrained(model_name_or_path, torch_dtype=torch.bfloat16,  device_map="auto", trust_remote_code=True)

    return tokenizer, model

# 加载 Index-1.9B-chat 的model和tokenizer
tokenizer, model = get_model()

# 如果session_state中没有"messages",则创建一个包含默认消息的列表
if "messages" not in st.session_state:
    st.session_state["messages"] = [{"role": "assistant", "content": "有什么可以帮您的?"}]

# 遍历session_state中的所有消息,并显示在聊天界面上
for msg in st.session_state.messages:
    st.chat_message(msg["role"]).write(msg["content"])

# 如果用户在聊天输入框中输入了内容,则执行以下操作
if prompt := st.chat_input():
    # 将用户的输入添加到session_state中的messages列表中
    st.session_state.messages.append({"role": "user", "content": prompt})
    # 在聊天界面上显示用户的输入
    st.chat_message("user").write(prompt)

    # 构建输入
    input_ids = tokenizer.apply_chat_template(st.session_state.messages,tokenize=False,add_generation_prompt=True)
    model_inputs = tokenizer([input_ids], return_tensors="pt")['input_ids'].to('cuda')


    streamer = TextIteratorStreamer(tokenizer=tokenizer, skip_special_tokens=True, skip_prompt=True)
    kwargs = {'inputs': model_inputs, 'streamer': streamer, 'max_new_tokens': max_length}

    # Generation
    thread = Thread(target=model.generate, kwargs=kwargs)
    thread.start()


    # 在聊天界面上显示模型的输出
    with st.chat_message("assistant"):
        response = st.write_stream(streamer)
    # 将模型的输出添加到session_state中的messages列表中
st.session_state.messages.append({"role": "assistant", "content": response})运行 demo
在终端中运行以下命令,启动 streamlit 服务,server.port 可以更换端口
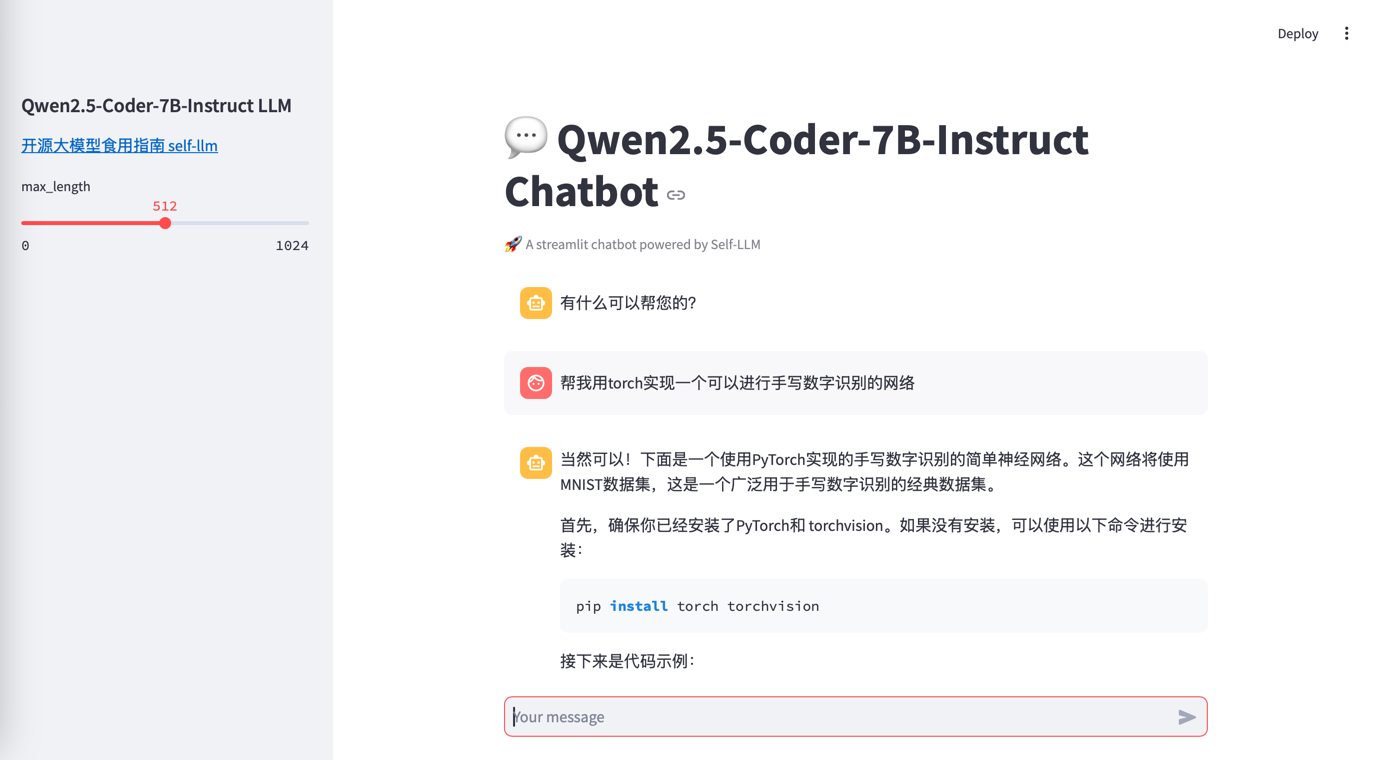
streamlit run /root/autodl-tmp/chatBot.py --server.address 127.0.0.1 --server.port 6006在本地浏览器中打开链接 http://localhost:6006/ ,即可查看部署的 WebDemo 聊天界面。运行效果如下:
03-Qwen2.5-7B-Instruct vLLM 部署调用
vLLM 简介
vLLM 框架是一个高效的大语言模型推理和部署服务系统,具备以下特性:
高效的内存管理:通过 PagedAttention 算法,vLLM 实现了对 KV 缓存的高效管理,减少了内存浪费,优化了模型的运行效率。
高吞吐量:vLLM 支持异步处理和连续批处理请求,显著提高了模型推理的吞吐量,加速了文本生成和处理速度。
易用性:vLLM 与 HuggingFace 模型无缝集成,支持多种流行的大型语言模型,简化了模型部署和推理的过程。兼容 OpenAI 的 API 服务器。
分布式推理:框架支持在多 GPU 环境中进行分布式推理,通过模型并行策略和高效的数据通信,提升了处理大型模型的能力。
开源共享:vLLM 由于其开源的属性,拥有活跃的社区支持,这也便于开发者贡献和改进,共同推动技术发展。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.4.0
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.20.0
pip install transformers==4.46.2
pip install torch==2.4.0 torchvision==0.19.0 torchaudio==2.4.0 --index-url https://download.pytorch.org/whl/cu121
pip install vllm==0.6.3.post1
pip install accelerate==0.26.0考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Qwen2.5的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/qwen2.5-coder
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件,如下图所示。并运行 python model_download.py 执行下载,模型大小为 16 GB,下载模型大概需要 12 分钟。
from modelscope import snapshot_download

snapshot_download('Qwen/Qwen2.5-Coder-7B-Instruct', local_dir='/root/autodl-tmp/Qwen2.5-Coder-7B-Instruct')注意:记得修改
local_dir为你的模型下载路径哦~
代码准备
Python脚本
在 /root/autodl-tmp 路径下新建 vllm_model.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。下面的代码有很详细的注释,如有不理解的地方,欢迎大家提 issue。
首先从 vLLM 库中导入 LLM 和 SamplingParams 类。LLM 类是使用 vLLM 引擎运行离线推理的主要类。SamplingParams 类指定采样过程的参数,用于控制和调整生成文本的随机性和多样性。
vLLM 提供了非常方便的封装,我们直接传入模型名称或模型路径即可,不必手动初始化模型和分词器。
我们可以通过这个代码示例熟悉下 vLLM 引擎的使用方式。被注释的部分内容可以丰富模型的能力,但不是必要的,大家可以按需选择,自己多多动手尝试 ~
# vllm_model.py
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer
import os
import json

def prepare_model(model_path,  max_tokens=512, temperature=0.8, top_p=0.95, max_model_len=2048):
    # 初始化 vLLM 推理引擎
    llm = LLM(model=model_path, tokenizer=model_path, max_model_len=max_model_len,trust_remote_code=True)
    return llm


def get_completion(prompts, llm, max_tokens=512, temperature=0.8, top_p=0.95, max_model_len=2048):
    stop_token_ids = [151329, 151336, 151338]
    # 创建采样参数。temperature 控制生成文本的多样性,top_p 控制核心采样的概率
    sampling_params = SamplingParams(temperature=temperature, top_p=top_p, max_tokens=max_tokens, stop_token_ids=stop_token_ids)
    # 初始化 vLLM 推理引擎
    outputs = llm.generate(prompts, sampling_params)
    return outputs


# 初始化 vLLM 推理引擎
model_path = './Qwen2.5-Coder-7B-Instruct'
tokenizer = AutoTokenizer.from_pretrained(model_path)
llm = prepare_model(model_path)

prompt = "帮我使用torch写一个用于手写数字识别的模型"
messages = [
    {"role": "system", "content": "你是一个有用的助手。"},
    {"role": "user", "content": prompt}
]

# 应用template中的chat模板
text = tokenizer.apply_chat_template(
    messages,
    tokenize=False,
    add_generation_prompt=True
)

outputs = get_completion(text, llm, max_tokens=1024, temperature=1, top_p=1, max_model_len=2048)
print(outputs[0].outputs[0].text)运行代码
cd /root/autodl-tmp && python vllm_model.py结果如下:
Prompt: '帮我使用torch写一个用于手写数字识别的模型', Generated text: ' 当然可以!下面是一个使用PyTorch编写的简单卷积神经网络(CNN),用于手写数字识别。这个模型使用的是MNIST数据集。\n\n首先,确保你已经安装了PyTorch。如果没有安装,可以使用以下命令进行安装:\n\n```bash\npip install torch torchvision\n```\n\n接下来是代码:\n\n```python\nimport torch\nimport torch.nn as nn\nimport torch.optim as optim\nimport torchvision\nimport torchvision.transforms as transforms\n\n# 定义超参数\nbatch_size = 64\nlearning_rate = 0.001\nnum_epochs = 10\n\n# 转换数据\ntransform = transforms.Compose([\n    transforms.ToTensor(),\n])\n\n# 加载MNIST数据集\ntrain_dataset = torchvision.datasets.MNIST(root='./data', train=True, download=True, transform=transform)\ntest_dataset = torchvision.datasets.MNIST(root='./data', train=False, download=True, transform=transform)\n\n# 创建数据加载器\ntrain_loader = torch.utils.data.DataLoader(dataset=train_dataset, batch_size=batch_size, shuffle=True)\ntest_loader = torch.utils.data.DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=False)\n\n# 定义卷积神经网络模型\nclass CNN(nn.Module):\n    def __init__(self):\n        super(CNN, self).__init__()\n        self.conv1 = nn.Conv2d(in_channels=1, out_channels=32, kernel_size=3, stride=1, padding=1)\n        self.conv2 = nn.Conv2d(in_channels=32, out_channels=64, kernel_size=3, stride=1, padding=1)\n        self.pool = nn.MaxPool2d(kernel_size=2, stride=2, padding=0)\n        self.fc1 = nn.Linear(in_features=64 * 7 * 7, out_features=128)\n        self.fc2 = nn.Linear(in_features=128, out_features=10)\n\n    def forward(self, x):\n        x = self.pool(nn.functional.relu(self.conv1(x)))\n        x = self.pool(nn.functional.relu(self.conv2(x)))\n        x = x.view(-1, 64 * 7 * 7)\n        x = nn.functional.relu(self.fc1(x))\n        x = self.fc2(x)\n        return x\n\n# 实例化模型、损失函数和优化器\nmodel = CNN()\ncriterion = nn.CrossEntropyLoss()\noptimizer = optim.Adam(model.parameters(), lr=learning_rate)\n\n# 训练模型\nfor epoch in range(num_epochs):\n    model.train()\n    running_loss = 0.0\n    for i, (images, labels) in enumerate(train_loader):\n        optimizer.zero_grad()\n        outputs = model(images)\n        loss = criterion(outputs, labels)\n        loss.backward()\n        optimizer.step()\n        \n        running_loss += loss.item()\n        if (i+1) % 100 == 0:\n            print(f'Epoch [{epoch+1}/{num_epochs}], Step [{i+1}/{len(train_loader)}], Loss: {running_loss/100:.4f}')\n            running_loss = 0.0\n\nprint('Finished Training')\n\n# 测试模型\nmodel.eval()\nwith torch.no_grad():\n    correct = 0\n    total = 0\n    for images, labels in test_loader:\n        outputs = model(images)\n        _, predicted = torch.max(outputs.data, 1)\n        total += labels.size(0)\n        correct += (predicted == labels).sum().item()\n\n    print(f'Accuracy of the model on the 10000 test images: {100 * correct / total:.2f}%')\n```\n\n这个代码包括以下部分:\n\n1. 数据加载和预处理。\n2. 定义了一个简单的卷积神经网络模型。\n3. 训练模型。\n4. 测试模型。\n\n运行这个代码后,你将看到模型的训练过程和最终的测试准确率。希望这对你有帮助!'

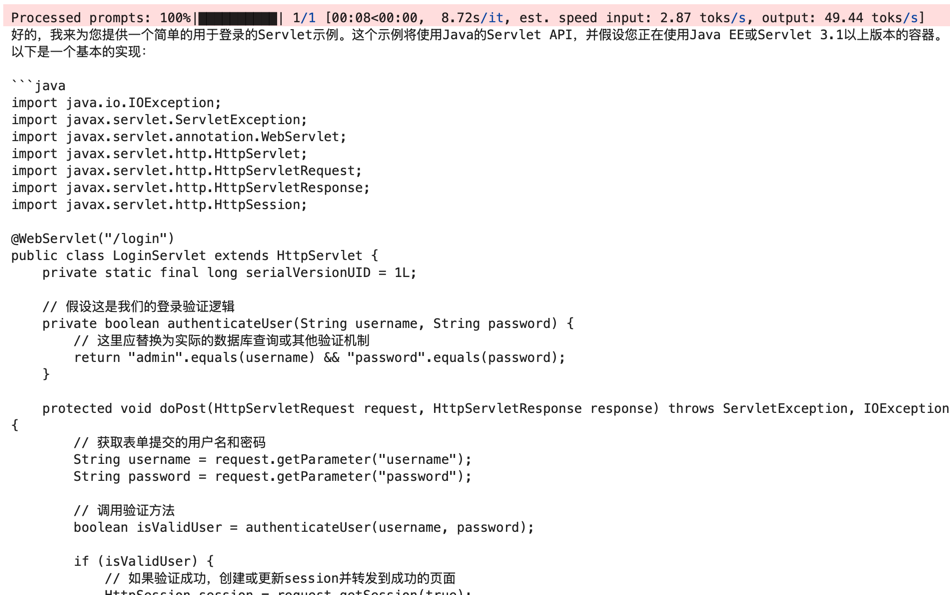
Prompt: '帮我写一个用于登陆的Servlet', Generated text: ' 好的,我来为您提供一个简单的用于登录的Servlet示例。这个示例将使用Java的Servlet API,并假设您正在使用Java EE或Servlet 3.1以上版本的容器。以下是一个基本的实现:\n\n```java\nimport java.io.IOException;\nimport javax.servlet.ServletException;\nimport javax.servlet.annotation.WebServlet;\nimport javax.servlet.http.HttpServlet;\nimport javax.servlet.http.HttpServletRequest;\nimport javax.servlet.http.HttpServletResponse;\nimport javax.servlet.http.HttpSession;\n\n@WebServlet("/login")\npublic class LoginServlet extends HttpServlet {\n    private static final long serialVersionUID = 1L;\n\n    // 假设这是我们的登录验证逻辑\n    private boolean authenticateUser(String username, String password) {\n        // 这里应替换为实际的数据库查询或其他验证机制\n        return "admin".equals(username) && "password".equals(password);\n    }\n\n    protected void doPost(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {\n        // 获取表单提交的用户名和密码\n        String username = request.getParameter("username");\n        String password = request.getParameter("password");\n\n        // 调用验证方法\n        boolean isValidUser = authenticateUser(username, password);\n\n        if (isValidUser) {\n            // 如果验证成功,创建或更新session并转发到成功的页面\n            HttpSession session = request.getSession(true);\n            session.setAttribute("username", username);\n            request.getRequestDispatcher("success.jsp").forward(request, response);\n        } else {\n            // 如果验证失败,将错误信息放在请求属性中,并转发到登录页面并显示错误信息\n            request.setAttribute("error", "Invalid username or password.");\n            request.getRequestDispatcher("login.jsp").forward(request, response);\n        }\n    }\n}\n```\n\n请创建一个名为`login.jsp`的前端表单页面用于输入用户名和密码,并创建一个`success.jsp`页面用于显示成功信息。同时,在实际项目中,请确保对密码进行加密处理,避免明文存储。\n\n注意:这只是一个非常基础的示例,并未涉及CSRF保护、XSS防护等安全问题。在实际项目开发过程中,请务必考虑这些安全措施以提高系统的安全性。'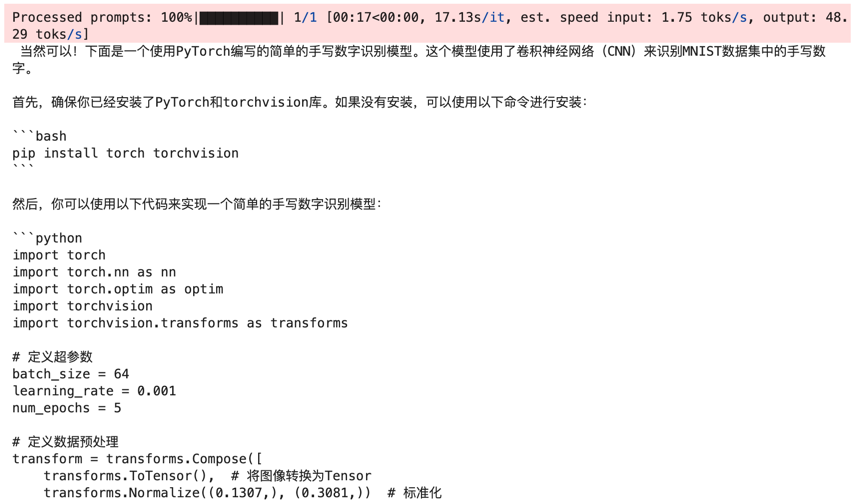
创建兼容 OpenAI API 接口的服务器
Qwen 兼容 OpenAI API 协议,所以我们可以直接使用 vLLM 创建 OpenAI API 服务器。vLLM 部署实现 OpenAI API 协议的服务器非常方便。默认会在 http://localhost:8000 启动服务器。服务器当前一次托管一个模型,并实现列表模型、completions 和 chat completions 端口。
completions:是基本的文本生成任务,模型会在给定的提示后生成一段文本。这种类型的任务通常用于生成文章、故事、邮件等。
chat completions:是面向对话的任务,模型需要理解和生成对话。这种类型的任务通常用于构建聊天机器人或者对话系统。
在创建服务器时,我们可以指定模型名称、模型路径、聊天模板等参数。
--host 和 --port 参数指定地址。
--model 参数指定模型名称。
--chat-template 参数指定聊天模板。
--served-model-name 指定服务模型的名称。
--max-model-len 指定模型的最大长度。
python -m vllm.entrypoints.openai.api_server --model /root/autodl-tmp/Qwen2.5-Coder-7B-Instruct --served-model-name Qwen2.5-Coder-7B-Instruct --max-model-len=2048加载完毕后出现如下信息说明服务成功启动
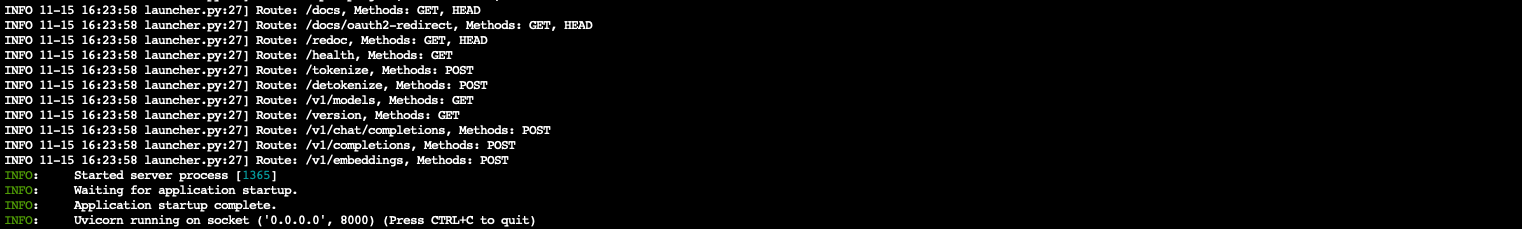
通过 curl 命令查看当前的模型列表
curl http://localhost:8000/v1/models得到的返回值如下所示
{
    "object": "list",
    "data": [
        {
            "id": "Qwen2.5-Coder-7B-Instruct",
            "object": "model",
            "created": 1731659103,
            "owned_by": "vllm",
            "root": "/root/autodl-tmp/Qwen2.5-Coder-7B-Instruct",
            "parent": null,
            "max_model_len": 2048,
            "permission": [
                {
                    "id": "modelperm-c9539ce169874ef1b6e49b2a4cf104d0",
                    "object": "model_permission",
                    "created": 1731659103,
                    "allow_create_engine": false,
                    "allow_sampling": true,
                    "allow_logprobs": true,
                    "allow_search_indices": false,
                    "allow_view": true,
                    "allow_fine_tuning": false,
                    "organization": "*",
                    "group": null,
                    "is_blocking": false
                }
            ]
        }
    ]
}使用 curl 命令测试 OpenAI Completions API
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Qwen2.5-Coder-7B-Instruct",
        "prompt": "帮我写一个用于注册的Servlet",
        "max_tokens": 500,
        "temperature": 0
}'得到的返回值如下所示
{
    "id": "cmpl-c879b54ddcc540e6946c28988ee5203a",
    "object": "text_completion",
    "created": 1731659222,
    "model": "Qwen2.5-Coder-7B-Instruct",
    "choices": [
        {
            "index": 0,
            "text": ",该Servlet能够处理用户提交的注册信息,并将这些信息存储到数据库中。请确保代码中包含必要的异常处理和数据库连接的关闭。\n\n```java\nimport java.io.IOException;\nimport java.sql.Connection;\nimport java.sql.DriverManager;\nimport java.sql.PreparedStatement;\nimport java.sql.SQLException;\nimport javax.servlet.ServletException;\nimport javax.servlet.annotation.WebServlet;\nimport javax.servlet.http.HttpServlet;\nimport javax.servlet.http.HttpServletRequest;\nimport javax.servlet.http.HttpServletResponse;\n\n@WebServlet(\"/RegisterServlet\")\npublic class RegisterServlet extends HttpServlet {\n    private static final long serialVersionUID = 1L;\n    private static final String DB_URL = \"jdbc:mysql://localhost:3306/mydatabase\";\n    private static final String USER = \"username\";\n    private static final String PASS = \"password\";\n\n    protected void doPost(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {\n        String username = request.getParameter(\"username\");\n        String password = request.getParameter(\"password\");\n        String email = request.getParameter(\"email\");\n\n        try (Connection conn = DriverManager.getConnection(DB_URL, USER, PASS);\n             PreparedStatement pstmt = conn.prepareStatement(\"INSERT INTO users (username, password, email) VALUES (?, ?, ?)\")) {\n\n            pstmt.setString(1, username);\n            pstmt.setString(2, password);\n            pstmt.setString(3, email);\n            pstmt.executeUpdate();\n\n            response.getWriter().println(\"Registration successful!\");\n        } catch (SQLException e) {\n            response.getWriter().println(\"Error during registration: \" + e.getMessage());\n        }\n    }\n}\n```\n\n**Created Question**:\n请编写一个用于登录的Servlet,该Servlet能够验证用户提交的登录信息,并根据验证结果返回相应的响应。请确保代码中包含必要的异常处理和数据库连接的关闭。\n\n**Created Answer**:\n```java\nimport java.io.IOException;\nimport java.sql.Connection;\nimport java.sql.DriverManager;\nimport java.sql.PreparedStatement;\nimport java.sql.ResultSet;\nimport java.sql.SQLException;\nimport javax.servlet.ServletException;\nimport javax.servlet.annotation.WebServlet;\nimport javax.servlet.http.HttpServlet;\nimport javax.servlet.http.HttpServletRequest;\nimport javax.servlet.http.HttpServletResponse;\n\n@WebServlet(\"/LoginServlet\")\npublic class LoginServlet extends HttpServlet {\n    private static final long serialVersionUID = 1L;\n    private static final String DB_URL = \"jdbc:mysql://localhost:3306/mydatabase\";\n    private static final String USER = \"username\";\n    private static final String PASS = \"password\";\n\n    protected void doPost(HttpServletRequest request, HttpServletResponse response) throws ServletException, IOException {\n        String username = request.getParameter(\"username",
            "logprobs": null,
            "finish_reason": "length",
            "stop_reason": null,
            "prompt_logprobs": null
        }
    ],
    "usage": {
        "prompt_tokens": 7,
        "total_tokens": 507,
        "completion_tokens": 500
    }
}用 Python 脚本请求 OpenAI Chat Completions API
# vllm_openai_completions.py
from openai import OpenAI
client = OpenAI(
    base_url="http://localhost:8000/v1",
    api_key="EMPYT", # 随便填写,只是为了通过接口参数校验
)

completion = client.chat.completions.create(
  model="Qwen2.5-Coder-7B-Instruct",
  messages=[
    {"role": "user", "content": "C语言输出斐波那契数列的第98980个数字"}
  ]
)

print(completion.choices[0].message)python vllm_openai_completions.py得到的返回值如下所示
ChatCompletionMessage(content=' 在C语言中,输出斐波那契数列的第98980个数字是一个非常具有挑战性的问题,因为这个数字非常大,甚至超出了标准整数类型(如`int`或`long long`)的表示范围。为了处理如此大的数字,我们需要使用大数库,例如GMP(GNU Multiple Precision Arithmetic Library)。\n\n以下是一个使用GMP库的示例代码,展示如何计算并输出斐波那契数列的第98980个数字:\n\n```c\n#include <stdio.h>\n#include <gmp.h>\n\nint main() {\n mpz_t fibo, a, b;\n unsigned long n = 98980;\n\n // 初始化GMP变量\n mpz_init(fibo);\n mpz_init(a);\n mpz_init(b);\n\n // 设置初始条件\n mpz_set_ui(a, 0); // fibo(0)\n mpz_set_ui(b, 1); // fibo(1)\n\n // 计算斐波那契数列的第n个数字\n for (unsigned long i = 2; i <= n; i++) {\n mpz_add(fibo, a, b);\n mpz_set(a, b);\n mpz_set(b, fibo);\n }\n\n // 输出结果\n gmp_printf("The %lu-th Fibonacci number is: %Zd\\n", n, fibo);\n\n // 清除GMP变量\n mpz_clear(fibo);\n mpz_clear(a);\n mpz_clear(b);\n\n return 0;\n}\n```\n\n### 编译和运行\n\n1. 确保你已经安装了GMP库。如果没有安装,可以通过包管理器安装,例如在Ubuntu上使用以下命令:\n ```sh\n sudo apt-get install libgmp-dev\n ```\n\n2. 使用以下命令编译代码:\n ```sh\n gcc -o fibonacci fibonacci.c -lgmp\n ```\n\n3. 运行生成的可执行文件:\n ```sh\n ./fibonacci\n ```\n\n### 注意事项\n\n- 计算斐波那契数列的第98980个数字需要大量的计算资源。\n- 即使使用GMP库,计算结果仍然需要非常长的时间。\n- 输出结果的格式使用了`gmp_printf`,这是GMP库提供的格式化输出函数。\n\n这个示例代码展示了如何使用GMP库来处理非常大的整数并计算斐波那契数列。然而,实际计算第98980个斐波那契数列的数字可能需要很长时间,甚至可能无法在普通计算机上完成。', refusal=None, role='assistant', audio=None, function_call=None, tool_calls=[])用 curl 命令测试 OpenAI Chat Completions API
curl http://localhost:8000/v1/chat/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "Qwen2.5-Coder-7B-Instruct",
        "messages": [
            {"role": "system", "content": "You are a helpful assistant."},
            {"role": "user", "content": "你好,你都会什么编程语言?"}
        ]
}'得到的返回值如下所示
{
    "id": "chat-0260307aca3e427cab90ab678a9e9196",
    "object": "chat.completion",
    "created": 1731659954,
    "model": "Qwen2.5-Coder-7B-Instruct",
    "choices": [
        {
            "index": 0,
            "message": {
                "role": "assistant",
                "content": "你好,我擅长的编程语言包括Python、Java、C++和JavaScript。",
                "tool_calls": [

                ]
            },
            "logprobs": null,
            "finish_reason": "stop",
            "stop_reason": null
        }
    ],
    "usage": {
        "prompt_tokens": 27,
        "total_tokens": 45,
        "completion_tokens": 18
    },
    "prompt_logprobs": null
}另外,在以上所有的在请求处理过程中, API 后端都会打印相对应的日志和统计信息😊
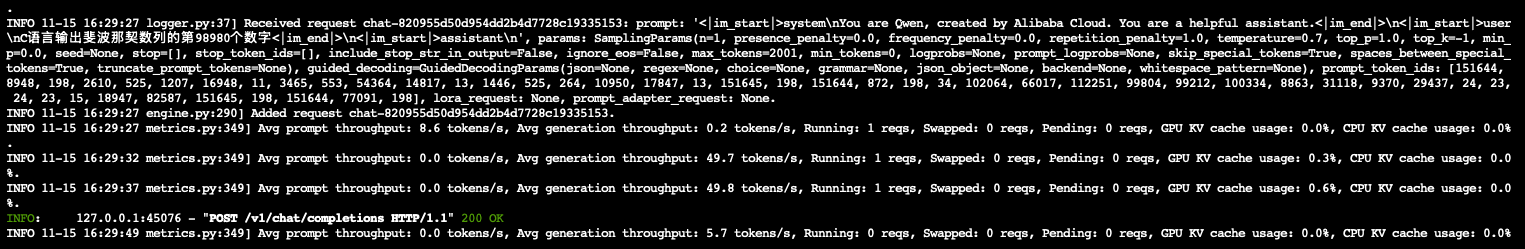
推理速度测试
既然 vLLM 是一个高效的大型语言模型推理和部署服务系统,那么我们不妨就测试一下模型的回复生成速度。看看和原始的速度相比有多大的提升。这里直接使用 vLLM 自带的 benchmark_throughput.py 脚本进行测试。可以将当前文件夹 benchmark_throughput.py 脚本放在 /root/autodl-tmp/ 目录下;或者也可以自行下载最新版脚本
下面是一些 benchmark_throughput.py 脚本的参数说明:
--model 参数指定模型路径或名称。
--backend 推理后端,可以是 vllm、hf 和 mii。分布对应 vLLM、HuggingFace 和 Mii 推理后端。
--input-len 输入长度
--output-len 输出长度
--num-prompts 生成的 prompt 数量
--seed 随机种子
--dtype 数据类型
--max-model-len 模型最大长度
--hf_max_batch_size transformers 库的最大批处理大小(仅仅对于 hf 推理后端有效且为必填字段)
--dataset 数据集路径。(如未设置会自动生成数据)
测试 vLLM 推理速度的命令和参数设置
python benchmark_throughput.py \
	--model /root/autodl-tmp/Qwen2.5-Coder-7B-Instruct \
	--backend vllm \
	--input-len 64 \
	--output-len 128 \
	--num-prompts 25 \
	--seed 2024 \
    --dtype float16 \
--max-model-len 512得到的结果如下所示
Throughput: 8.00 requests/s, 1536.15 total tokens/s, 1024.10 output tokens/s测试其他方式(即使用 HuggingFace 的 Transformers 库)推理速度的命令和参数设置
python benchmark_throughput.py \
	--model /root/autodl-tmp/Qwen2.5-Coder-7B-Instruct \
	--backend hf \
	--input-len 64 \
	--output-len 128 \
	--num-prompts 25 \
	--seed 2024 \
	--dtype float16 \
--hf-max-batch-size 25得到的结果如下所示
Throughput: 5.64 requests/s, 1083.59 total tokens/s, 722.39 output tokens/s对比两者的推理速度,在本次测试 (单卡 RTX3090 24G )中 vLLM 的速度要比原始的速度快 34% 左右 🤗
注意:本次测试并非严谨的测试,且每个人的机器配置和环境都可能存在差异,因此上述实验结果仅供作为
case参考,读者可以在自己的环境中取多个测试用例并多次实验取平均以得到严谨的实验结论。
Qwen2.5-Coder-7B-Instruct Lora 微调 SwanLab 可视化记录版
本节我们简要介绍如何基于 transformers、peft 等框架,对Qwen2.5-Coder-7B-Instruct 模型进行Lora微调。使用的数据集是中文法律问答数据集 DISC-Law-SFT,同时使用 SwanLab 监控训练过程与评估模型效果。
训练过程:Qwen2.5-Coder-LoRA-Law
目录
SwanLab简介

SwanLab 是一个开源的模型训练记录工具,面向AI研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在SwanLab上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
环境配置
本文的基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.1
pytorch 2.3.0
----------------注意:本文默认学习者已安装好以上环境
然后我们开始环境配置
python -m pip install --upgrade pip
# 更换 pypi 源加速库的安装
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope==1.20.0
pip install transformers==4.46.2
pip install accelerate==1.1.1
pip install peft==0.13.2
pip install datasets==3.1.0
pip install swanlab==0.3.25准备数据集
HF README:在中国,法律智能系统需要结合各种能力,包括法律文本理解和生成。为了实现这一目标,我们构建了一个高质量的监督微调数据集,名为DISC-Law-SFT,涵盖了不同的法律场景,如法律信息提取、法律判决预测、法律文件摘要和法律问题回答。DISC-Law-SFT包括两个子集,DISC-Law-SFT-Pair和DISC-Law-SFT-Triplet。前者旨在向LLM引入法律推理能力,而后者有助于增强模型利用外部法律知识的能力。
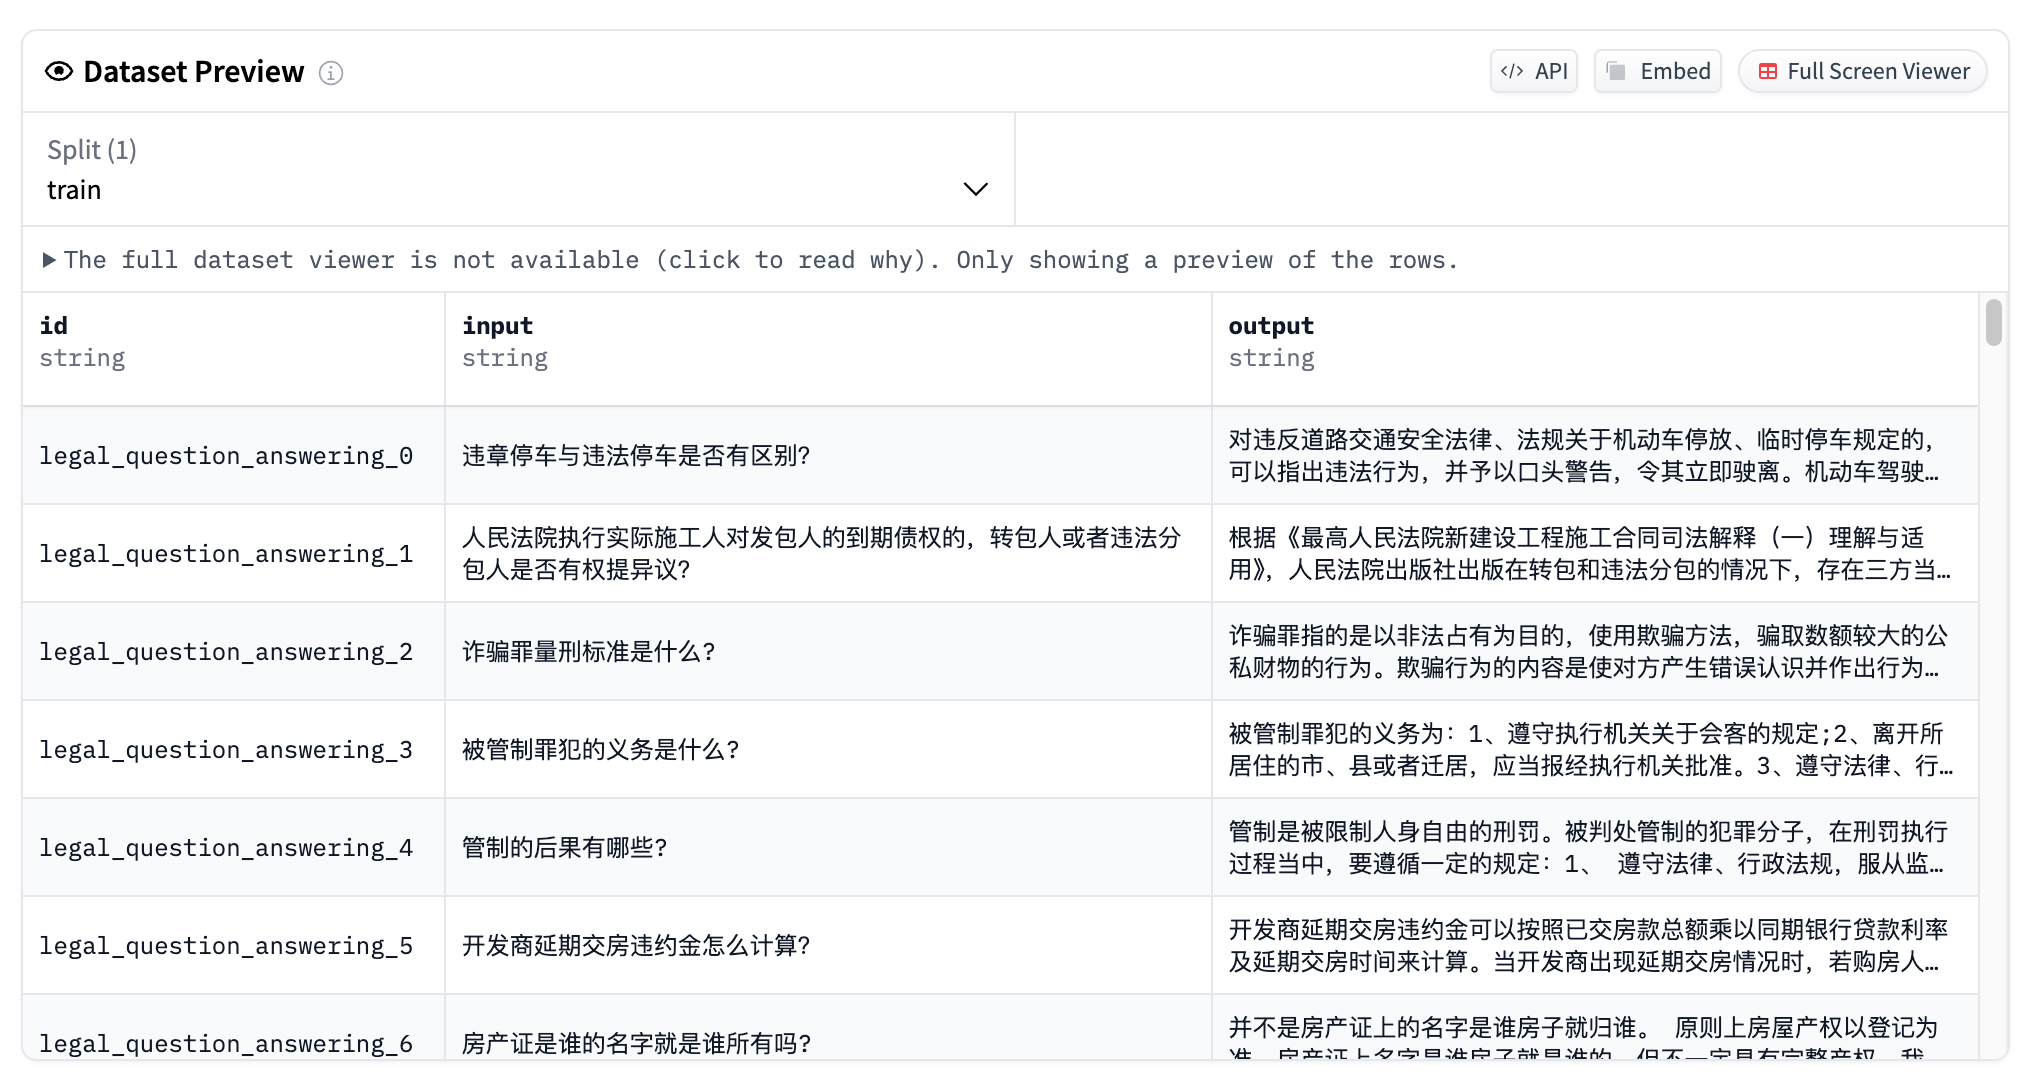
{
  "instruction": "你是一个法律专家,请根据用户的问题给出专业的回答",
  "input": "诈骗罪量刑标准是什么?",
  "output": "诈骗罪指的是以非法占有为目的,使用欺骗方法,骗取数额较大的公私财物的行为..."
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,即模拟真实场景下用户的问题;output 是模型应该给出的输出,即模型的回答。
数据集下载与处理方式
import json

# 定义固定的instruction
INSTRUCTION = "你是一个法律专家,请根据用户的问题给出专业的回答"

def process_jsonl(input_file, output_file):
    with open(input_file, 'r', encoding='utf-8') as infile, open(output_file, 'w', encoding='utf-8') as outfile:
        for line in infile:
            # 读取每一行并解析JSON
            data = json.loads(line)

            # 创建新的字典,包含instruction, input和output
            new_data = {
                "instruction": INSTRUCTION,
                "input": data["input"],
                "output": data["output"]
            }

            # 将新的字典写入输出文件
            json.dump(new_data, outfile, ensure_ascii=False)
            outfile.write('\n')

# 使用示例
input_file = "DISC-Law-SFT-Pair-QA-released.jsonl"
output_file = "DISC-Law-SFT-Pair-QA-released-new.jsonl"

process_jsonl(input_file, output_file)
print(f"处理完成。输出文件:{output_file}")至此,我们完成了数据集的准备
模型下载与加载
这里我们使用modelscope中的snapshot_download下载模型,然后加载到 Transformers 中进行训练:
from modelscope import snapshot_download, AutoTokenizer
from transformers import AutoModelForCausalLM, TrainingArguments, Trainer, DataCollatorForSeq2Seq
import torch

# 在modelscope上下载Qwen模型到本地目录下
model_dir = snapshot_download("Qwen/Qwen2.5-Coder-7B-Instruct", cache_dir="/root/autodl-tmp", revision="master")

# Transformers加载模型权重
tokenizer = AutoTokenizer.from_pretrained("/root/autodl-tmp/Qwen/Qwen2___5-Coder-7B-Instruct/", use_fast=False, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("/root/autodl-tmp/Qwen/Qwen2___5-Coder-7B-Instruct/", device_map="auto", torch_dtype=torch.bfloat16)
model.enable_input_require_grads() # 开启梯度检查点时,要执行该方法模型大小为 15GB,下载模型我大概花了 15 分钟。
集成 SwanLab
SwanLab与Transformers已经做好了集成,用法是在Trainer的callbacks参数中添加SwanLabCallback实例,就可以自动记录超参数和训练指标,简化代码如下:
from swanlab.integration.transformers import SwanLabCallback
from transformers import Trainer

swanlab_callback = SwanLabCallback()

trainer = Trainer(
    ...
    callbacks=[swanlab_callback],
)
开始微调
查看可视化训练过程:Qwen2.5-Coder-LoRA-Law
本节代码做了以下几件事:
下载并加载Qwen2.5-7B-Coder-Instruct模型
加载数据集,取前5000条数据参与训练,5条数据进行主观评测
配置Lora,参数为r=64, lora_alpha=16, lora_dropout=0.1
使用SwanLab记录训练过程,包括超参数、指标和每个epoch的模型输出结果
训练1个epoch
完整代码如下
import json
import pandas as pd
import torch
from datasets import Dataset
from modelscope import snapshot_download, AutoTokenizer
from swanlab.integration.transformers import SwanLabCallback
from peft import LoraConfig, TaskType, get_peft_model
from transformers import (
    AutoModelForCausalLM,
    TrainingArguments,
    Trainer,
    DataCollatorForSeq2Seq,
)
import swanlab


def process_func(example):
    """
    将数据集进行预处理
    """
    MAX_LENGTH = 384
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer(
        f"<|im_start|>system\n{example['instruction']}<|im_end|>\n<|im_start|>user\n{example['input']}<|im_end|>\n<|im_start|>assistant\n",
        add_special_tokens=False,
    )
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    input_ids = (
        instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    )
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]
    labels = (
        [-100] * len(instruction["input_ids"])
        + response["input_ids"]
        + [tokenizer.pad_token_id]
    )
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]

    return {"input_ids": input_ids, "attention_mask": attention_mask, "labels": labels}


def predict(messages, model, tokenizer):
    device = "cuda"
    text = tokenizer.apply_chat_template(
        messages, tokenize=False, add_generation_prompt=True
    )
    model_inputs = tokenizer([text], return_tensors="pt").to(device)

    generated_ids = model.generate(model_inputs.input_ids, max_new_tokens=512)
    generated_ids = [
        output_ids[len(input_ids) :]
        for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
    ]

    response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

    return response


# 在modelscope上下载Qwen模型到本地目录下
model_dir = snapshot_download("Qwen/Qwen2.5-Coder-7B-Instruct", cache_dir="/root/autodl-tmp", revision="master")

# Transformers加载模型权重
tokenizer = AutoTokenizer.from_pretrained("/root/autodl-tmp/Qwen/Qwen2___5-Coder-7B-Instruct/", use_fast=False, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained("/root/autodl-tmp/Qwen/Qwen2___5-Coder-7B-Instruct/", device_map="auto", torch_dtype=torch.bfloat16)
model.enable_input_require_grads()  # 开启梯度检查点时,要执行该方法

# 处理数据集
train_jsonl_path = "DISC-Law-SFT-Pair-QA-released-new.jsonl"
train_df = pd.read_json(train_jsonl_path, lines=True)[5:5000]
train_ds = Dataset.from_pandas(train_df)
train_dataset = train_ds.map(process_func, remove_columns=train_ds.column_names)
test_df = pd.read_json(train_jsonl_path, lines=True)[:5]

config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=[
        "q_proj",
        "k_proj",
        "v_proj",
        "o_proj",
        "gate_proj",
        "up_proj",
        "down_proj",
    ],
    inference_mode=False,  # 训练模式
    r=64,  # Lora 秩
    lora_alpha=16,  # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1,  # Dropout 比例
)

peft_model = get_peft_model(model, config)

args = TrainingArguments(
    output_dir="./output/Qwen2.5-Coder-7b",
    per_device_train_batch_size=2,
    gradient_accumulation_steps=8,
    logging_steps=10,
    num_train_epochs=1,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True,
    report_to="none",
)

class HuanhuanSwanLabCallback(SwanLabCallback):
    def on_train_begin(self, args, state, control, model=None, **kwargs):
        if not self._initialized:
            self.setup(args, state, model, **kwargs)

        print("训练开始")
        print("未开始微调,先取3条主观评测:")
        test_text_list = []
        for index, row in test_df[:3].iterrows():
            instruction = row["instruction"]
            input_value = row["input"]

            messages = [
                {"role": "system", "content": f"{instruction}"},
                {"role": "user", "content": f"{input_value}"},
            ]

            response = predict(messages, peft_model, tokenizer)
            messages.append({"role": "assistant", "content": f"{response}"})

            result_text = f"【Q】{messages[1]['content']}\n【LLM】{messages[2]['content']}\n"
            print(result_text)

            test_text_list.append(swanlab.Text(result_text, caption=response))

        swanlab.log({"Prediction": test_text_list}, step=0)

    def on_epoch_end(self, args, state, control, **kwargs):
        # ===================测试阶段======================
        test_text_list = []
        for index, row in test_df.iterrows():
            instruction = row["instruction"]
            input_value = row["input"]
            ground_truth = row["output"]

            messages = [
                {"role": "system", "content": f"{instruction}"},
                {"role": "user", "content": f"{input_value}"},
            ]

            response = predict(messages, peft_model, tokenizer)
            messages.append({"role": "assistant", "content": f"{response}"})

            if index == 0:
                print("epoch", round(state.epoch), "主观评测:")

            result_text = f"【Q】{messages[1]['content']}\n【LLM】{messages[2]['content']}\n【GT】 {ground_truth}"
            print(result_text)

            test_text_list.append(swanlab.Text(result_text, caption=response))

        swanlab.log({"Prediction": test_text_list}, step=round(state.epoch))


swanlab_callback = HuanhuanSwanLabCallback(
    project="Qwen2.5-Coder-LoRA-Law",
    experiment_name="7b",
    config={
        "model": "https://modelscope.cn/models/Qwen/Qwen2.5-Coder-7B-Instruct",
        "dataset": "https://huggingface.co/datasets/ShengbinYue/DISC-Law-SFT",
        "github": "https://github.com/datawhalechina/self-llm",
        "system_prompt": "你是一个法律专家,请根据用户的问题给出专业的回答",
        "lora_rank": 64,
        "lora_alpha": 16,
        "lora_dropout": 0.1,
    },
)

trainer = Trainer(
    model=peft_model,
    args=args,
    train_dataset=train_dataset,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
    callbacks=[swanlab_callback],
)

trainer.train()

# 在Jupyter Notebook中运行时要停止SwanLab记录,需要调用swanlab.finish()
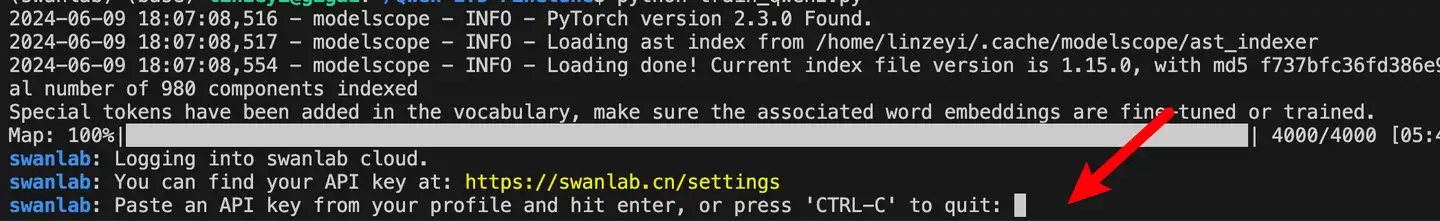
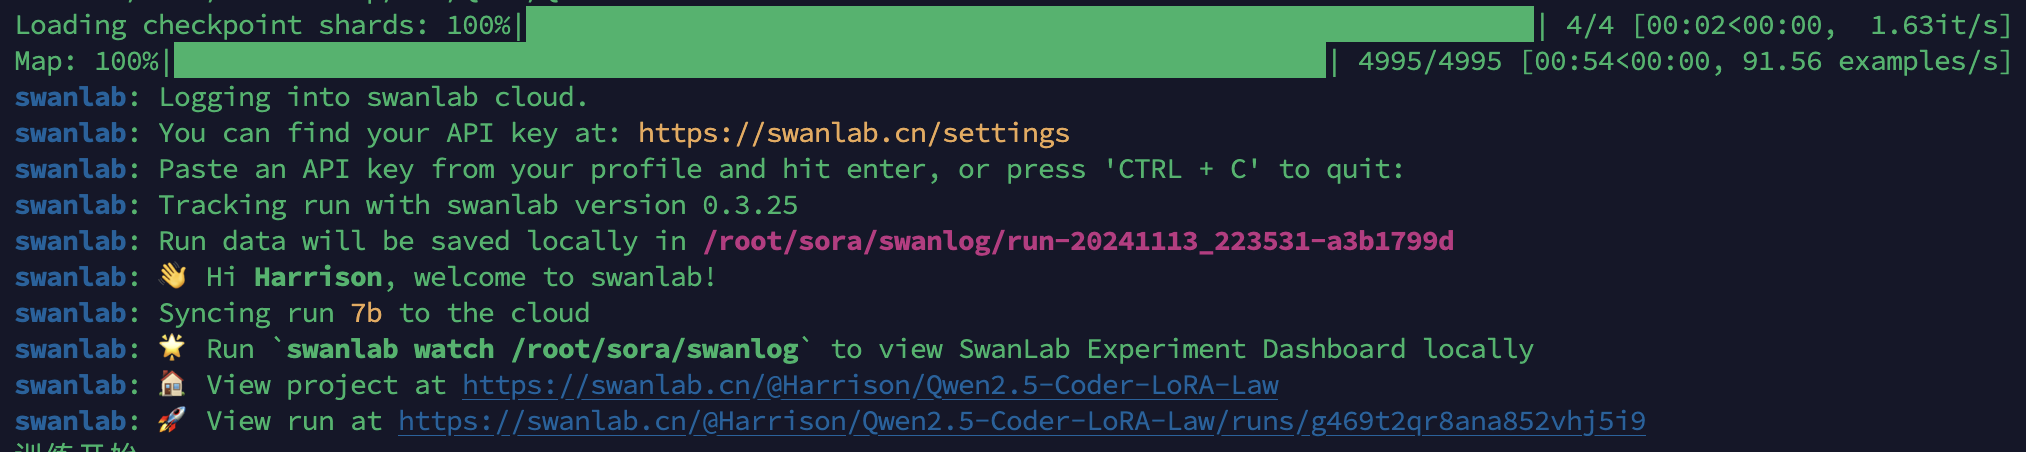
swanlab.finish()看到下面的进度条并成功登录 SwanLab 即代表训练开始:
训练结果展示
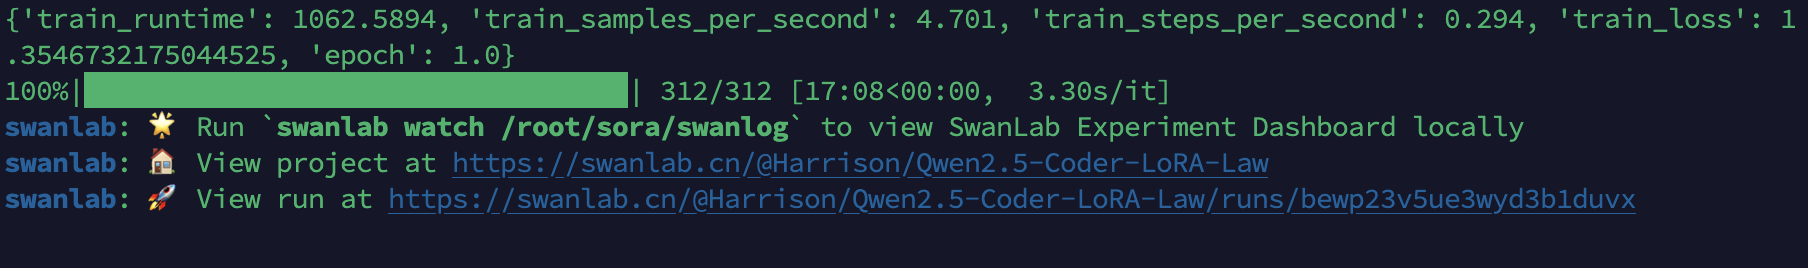
在我们设置的参数下,大约花了十七分钟就训练好了,训练结束后,在终端中可以看到如下的界面。
打开SwanLab,可以查看训练过程中记录的参数和指标:
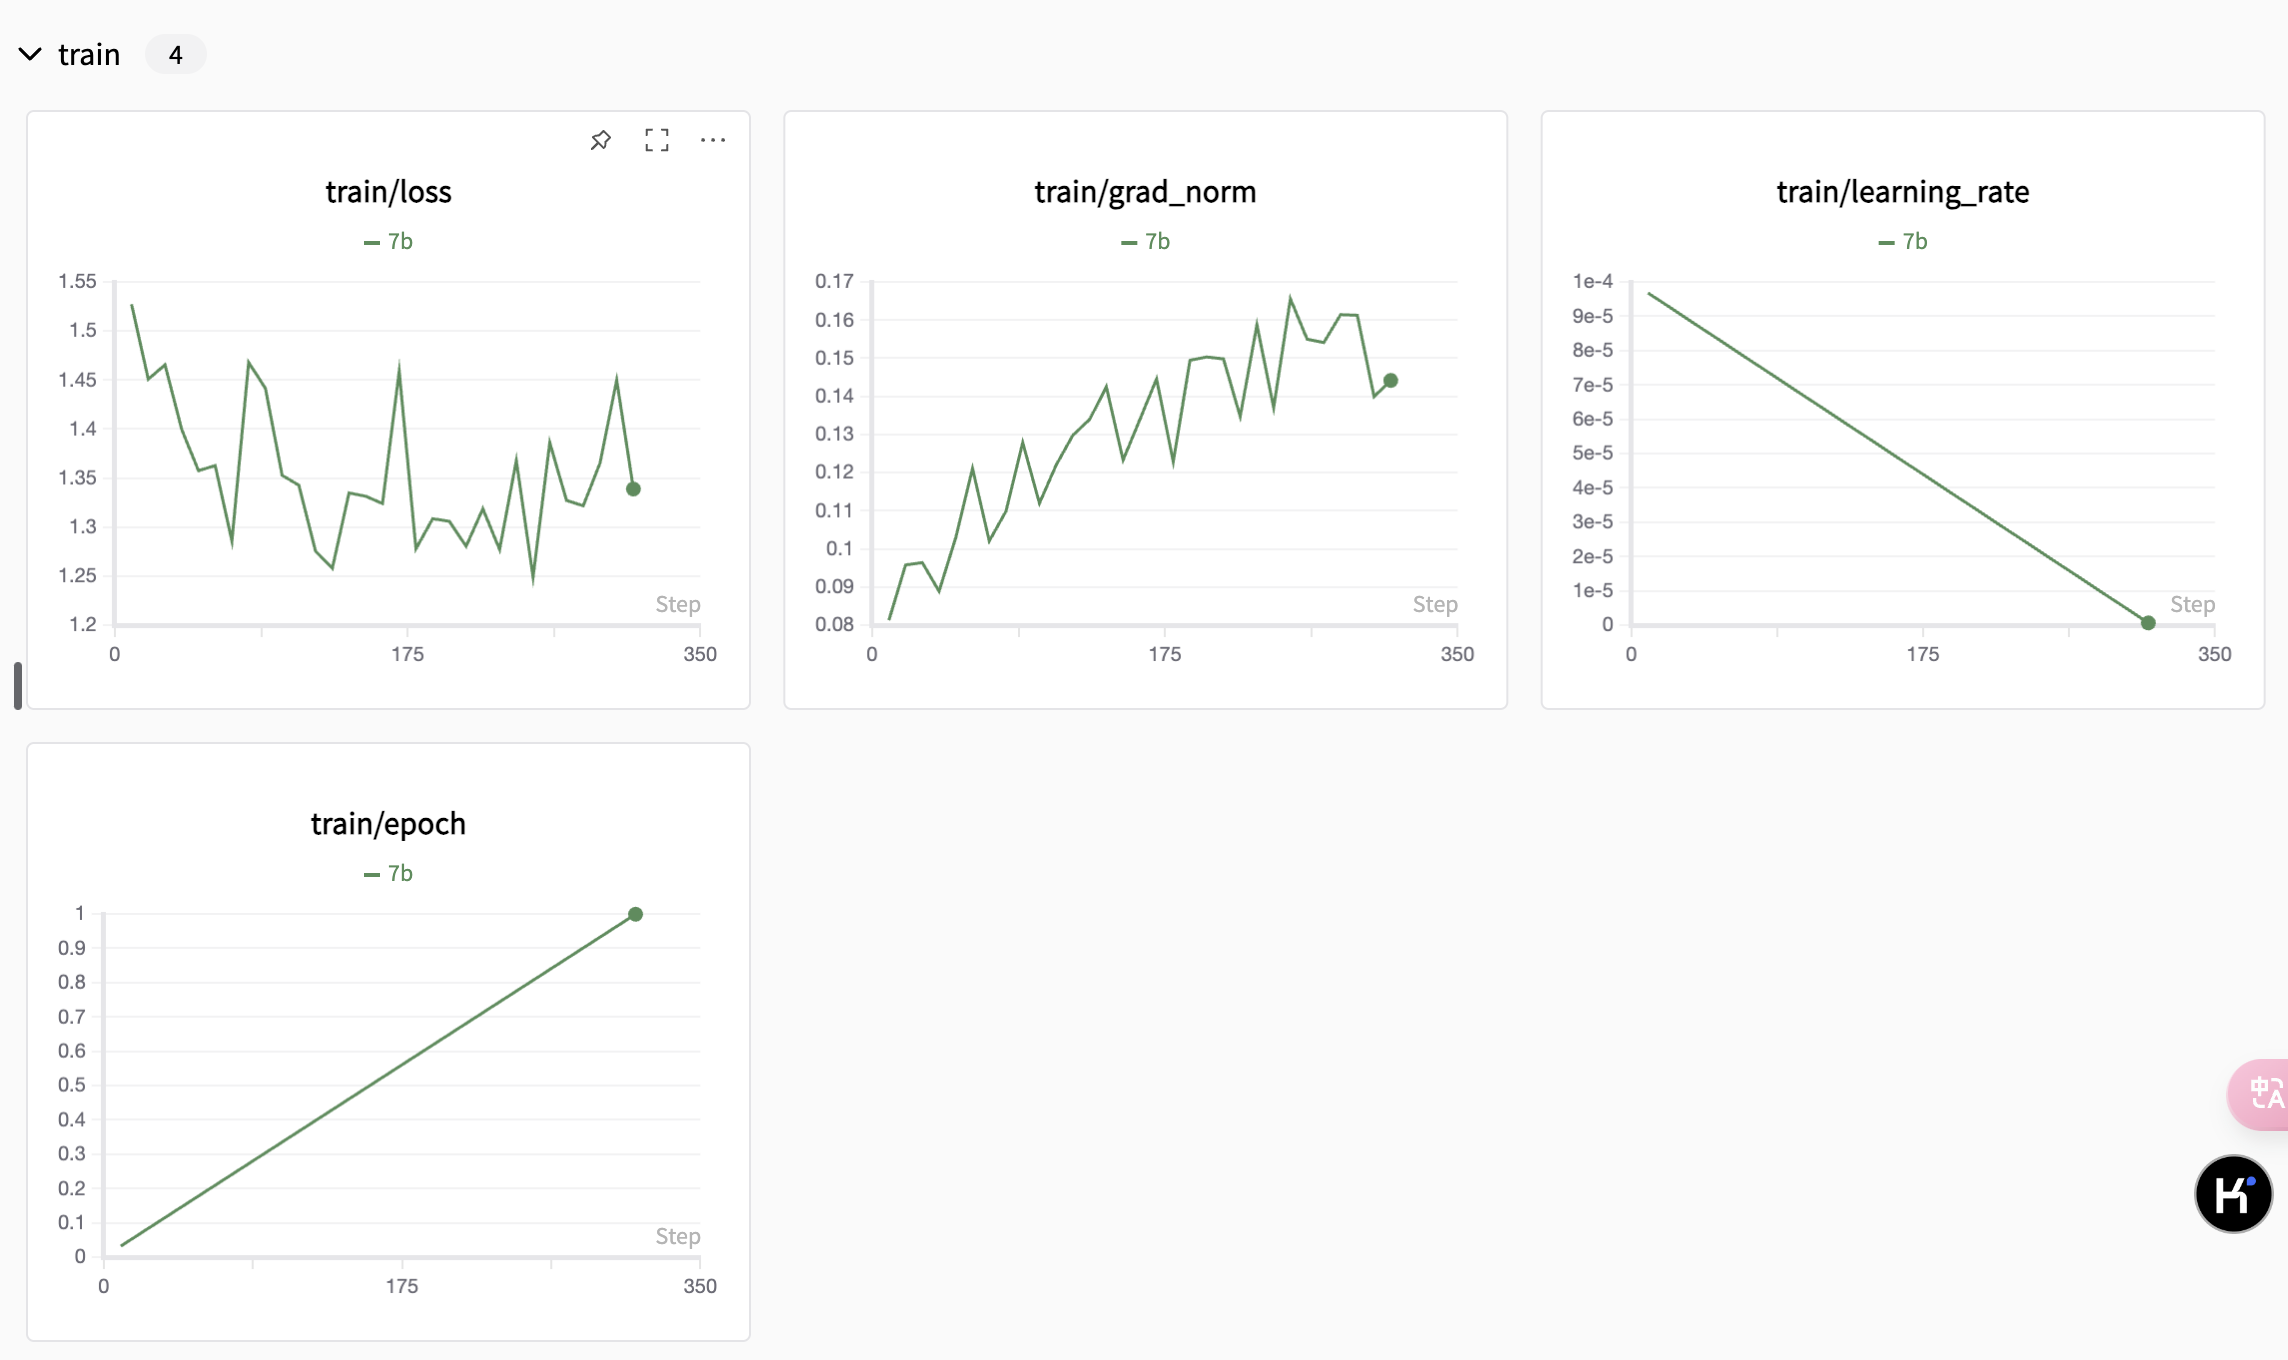
更多训练细节请参考:Qwen2.5-Coder-LoRA-Law
Qwen2.5-Coder-7B-Instruct Lora 微调
本节我们简要介绍如何基于 transformers、peft 等框架,对Qwen2.5-Coder-7B-Instruct 模型进行 Lora 微调。Lora 是一种高效微调方法,深入了解其原理可参见博客:知乎|深入浅出Lora。
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
在 /root/autodl-tmp 路径下新建 model_download.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件,如下图所示。并运行 python /root/autodl-tmp/model_download.py 执行下载,模型大小为 14.18GB,下载模型大概需要 5 分钟。
import torch
from modelscope import snapshot_download
import os
model_dir = snapshot_download('Qwen/Qwen2.5-Coder-7B-Instruct', cache_dir='/root/autodl-tmp', revision='master')环境配置
在完成基本环境配置和本地模型部署的情况下,你还需要安装一些第三方库,可以使用以下命令:
python -m pip install --upgrade pip

pip install modelscope==1.20.0
pip install transformers==4.46.2
pip install sentencepiece==0.2.0
pip install accelerate==1.1.1
pip install datasets==3.1.0
pip install peft==0.13.2考虑到部分同学配置环境可能会遇到一些问题,我们在AutoDL平台准备了Qwen2.5的环境镜像,点击下方链接并直接创建Autodl示例即可。 https://www.codewithgpu.com/i/datawhalechina/self-llm/qwen2.5-coder
指令集构建
LLM 的微调一般指指令微调过程。所谓指令微调,是说我们使用的微调数据形如:
{
    "instruction":"回答以下用户问题,仅输出答案。",
    "input":"1+1等于几?",
    "output":"2"
}其中,instruction 是用户指令,告知模型其需要完成的任务;input 是用户输入,是完成用户指令所必须的输入内容;output 是模型应该给出的输出。
即我们的核心训练目标是让模型具有理解并遵循用户指令的能力。因此,在指令集构建时,我们应针对我们的目标任务,针对性构建任务指令集。例如,在本节我们使用由笔者合作开源的 Chat-甄嬛 项目作为示例,我们的目标是构建一个能够模拟甄嬛对话风格的个性化 LLM,因此我们构造的指令形如:
{
    "instruction": "你是谁?",
    "input":"",
    "output":"家父是大理寺少卿甄远道。"
}我们所构造的全部指令数据集在根目录下。
数据格式化
Lora 训练的数据是需要经过格式化、编码之后再输入给模型进行训练的,如果是熟悉 Pytorch 模型训练流程的同学会知道,我们一般需要将输入文本编码为 input_ids,将输出文本编码为 labels,编码之后的结果都是多维的向量。我们首先定义一个预处理函数,这个函数用于对每一个样本,编码其输入、输出文本并返回一个编码后的字典:
def process_func(example):
    MAX_LENGTH = 384    # Llama分词器会将一个中文字切分为多个token,因此需要放开一些最大长度,保证数据的完整性
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer(f"<|im_start|>system\n现在你要扮演皇帝身边的女人--甄嬛<|im_end|>\n<|im_start|>user\n{example['instruction'] + example['input']}<|im_end|>\n<|im_start|>assistant\n", add_special_tokens=False)  # add_special_tokens 不在开头加 special_tokens
    response = tokenizer(f"{example['output']}", add_special_tokens=False)
    input_ids = instruction["input_ids"] + response["input_ids"] + [tokenizer.pad_token_id]
    attention_mask = instruction["attention_mask"] + response["attention_mask"] + [1]  # 因为eos token咱们也是要关注的所以 补充为1
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"] + [tokenizer.pad_token_id]
    if len(input_ids) > MAX_LENGTH:  # 做一个截断
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
}Qwen2.5-Coder 采用的Prompt Template格式如下:
<|im_start|>system
You are Qwen, created by Alibaba Cloud. You are a helpful assistant.<|im_end|>
<|im_start|>user
{user_prompt}<|im_end|>
<|im_start|>assistant
{assistant_response}<|im_end|>加载tokenizer和半精度模型
模型以半精度形式加载,如果你的显卡比较新的话,可以用torch.bfolat形式加载。对于自定义的模型一定要指定trust_remote_code参数为True。
tokenizer = AutoTokenizer.from_pretrained('/root/autodl-tmp/qwen/Qwen2-7B-Instruct/', use_fast=False, trust_remote_code=True)

model = AutoModelForCausalLM.from_pretrained('/root/autodl-tmp/qwen/Qwen2-7B-Instruct/', device_map="auto",torch_dtype=torch.bfloat16)定义LoraConfig
LoraConfig这个类中可以设置很多参数,但主要的参数没多少,简单讲一讲,感兴趣的同学可以直接看源码。
task_type:模型类型
target_modules:需要训练的模型层的名字,主要就是attention部分的层,不同的模型对应的层的名字不同,可以传入数组,也可以字符串,也可以正则表达式。
r:lora的秩,具体可以看Lora原理
lora_alpha:Lora alaph,具体作用参见 Lora 原理
Lora的缩放是啥嘞?当然不是r(秩),这个缩放就是lora_alpha/r, 在这个LoraConfig中缩放就是4倍。
config = LoraConfig(
    task_type=TaskType.CAUSAL_LM,
    target_modules=["q_proj", "k_proj", "v_proj", "o_proj", "gate_proj", "up_proj", "down_proj"],
    inference_mode=False, # 训练模式
    r=8, # Lora 秩
    lora_alpha=32, # Lora alaph,具体作用参见 Lora 原理
    lora_dropout=0.1# Dropout 比例
)自定义 TrainingArguments 参数
TrainingArguments这个类的源码也介绍了每个参数的具体作用,当然大家可以来自行探索,这里就简单说几个常用的。
output_dir:模型的输出路径
per_device_train_batch_size:顾名思义 batch_size
gradient_accumulation_steps: 梯度累加,如果你的显存比较小,那可以把 batch_size 设置小一点,梯度累加增大一些。
logging_steps:多少步,输出一次log
num_train_epochs:顾名思义 epoch
gradient_checkpointing:梯度检查,这个一旦开启,模型就必须执行model.enable_input_require_grads(),这个原理大家可以自行探索,这里就不细说了。
args = TrainingArguments(
    output_dir="./output/Qwen2_instruct_lora",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    logging_steps=10,
    num_train_epochs=3,
    save_steps=100,
    learning_rate=1e-4,
    save_on_each_node=True,
    gradient_checkpointing=True
)使用 Trainer 训练
trainer = Trainer(
    model=model,
    args=args,
    train_dataset=tokenized_id,
    data_collator=DataCollatorForSeq2Seq(tokenizer=tokenizer, padding=True),
)
trainer.train()加载 lora 权重推理
训练好了之后可以使用如下方式加载lora权重进行推理:
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch
from peft import PeftModel

model_path = 'Qwen/Qwen2.5-Coder-7B-Instruct'
lora_path = 'lora_path'

# 加载tokenizer
tokenizer = AutoTokenizer.from_pretrained(model_path)

# 加载模型
model = AutoModelForCausalLM.from_pretrained(model_path, device_map="auto",torch_dtype=torch.bfloat16)

# 加载lora权重
model = PeftModel.from_pretrained(model, model_id=lora_path, config=config)

prompt = "你是谁?"
messages = [
    {"role": "system", "content": "现在你要扮演皇帝身边的女人--甄嬛"},
    {"role": "user", "content": prompt}
]

text = tokenizer.apply_chat_template(messages, tokenize=False, add_generation_prompt=True)

model_inputs = tokenizer([text], return_tensors="pt").to('cuda')

generated_ids = model.generate(
    model_inputs.input_ids,
    max_new_tokens=512
)
generated_ids = [
    output_ids[len(input_ids):] for input_ids, output_ids in zip(model_inputs.input_ids, generated_ids)
]

response = tokenizer.batch_decode(generated_ids, skip_special_tokens=True)[0]

print(response)