MiniMax-M3 vLLM 部署调用
MiniMax-M3 简介
MiniMax-M3 是 MiniMax 推出的最新一代开源大语言模型。相较于 M2.5,M3 在长上下文、推理质量和多模态能力上均有明显提升:上下文窗口扩展到 512K、单次最大输出可达 128K,并原生支持图片输入(OpenAI 兼容与 Anthropic 兼容两套接口均可使用,目前仅图片,视频/音频/文档暂不支持)。
本文以 MiniMax-M3 为模型基座,演示如何通过 vLLM 完成模型下载、服务启动与客户端调用(含图片输入)。
vLLM 简介
vLLM 是一个面向大语言模型的高性能部署推理框架,提供开箱即用的推理加速与 OpenAI 兼容接口。它支持长上下文推理、流式输出、多卡并行(如张量并行与专家并行)、工具调用与"思考内容"解析等能力,便于将最新模型快速落地到生产环境。
环境准备
基础环境(参考值):
可用
nvidia-smi与python -c "import torch;print(torch.cuda.is_available())"自检 CUDA / PyTorch。
显存与推荐配置(按官方文档):
权重需求约 220 GB 显存;每 1M 上下文 token 约需 240 GB 显存
96G × 4 GPU:支持约 40 万 token 总上下文
144G × 8 GPU:支持约 300 万 token 总上下文
注:上下文窗口最大为 512K,单次最大输出为 128K;以上数值为硬件支持的最大并发缓存总量。
安装依赖:
建议使用虚拟环境(venv / conda / uv)避免依赖冲突
uv venv
source .venv/bin/activate
uv pip install vllm --torch-backend=auto请确保 vLLM 版本支持 MiniMax-M3。若启动时报模型不支持,请升级
pip install -U vllm。
模型下载
vLLM 会在首次启动时自动从 Hugging Face 拉取并缓存模型,无需手动下载。若希望提前下载或受网络限制,可选用 modelscope 手动下载模型:
# model_download.py
from modelscope import snapshot_download

model_dir = snapshot_download('MiniMaxAI/MiniMax-M3', cache_dir='/root/autodl-tmp', revision='master')
print(f"模型下载成功,保存到: {model_dir}")pip install modelscope
python model_download.py注意:使用
modelscope下载模型时无需设置 HF 镜像。若不使用 modelscope,而是让 vLLM 自动从 Hugging Face 拉取,网络受限时可设置镜像:export HF_ENDPOINT=https://hf-mirror.com
启动 vLLM 服务
Python 启动脚本
新建 start_server.py:
import torch
from vllm.utils import launch_server_cmd, wait_for_server

gpu_count = torch.cuda.device_count() if torch.cuda.is_available() else 0
if gpu_count == 4:
    cmd = (
        "SAFETENSORS_FAST_GPU=1 vllm serve "
        "MiniMaxAI/MiniMax-M3 --trust-remote-code "
        "--tensor-parallel-size 4 "
        "--enable-auto-tool-choice --tool-call-parser minimax_m2 "
        "--reasoning-parser minimax_m2_append_think"
    )
elif gpu_count == 8:
    cmd = (
        "SAFETENSORS_FAST_GPU=1 vllm serve "
        "MiniMaxAI/MiniMax-M3 --trust-remote-code "
        "--enable_expert_parallel --tensor-parallel-size 8 "
        "--enable-auto-tool-choice --tool-call-parser minimax_m2 "
        "--reasoning-parser minimax_m2_append_think"
    )
else:
    raise RuntimeError(f"建议使用 4 或 8 张 GPU,当前检测到: {gpu_count}")

server_process, port = launch_server_cmd(cmd, port=8000)
wait_for_server(f"http://127.0.0.1:{port}")
print(f"vLLM Server started: http://127.0.0.1:{port}")启动:
python start_server.py服务启动成功后将监听 http://127.0.0.1:8000/v1。
命令行直接启动
4 卡部署:
SAFETENSORS_FAST_GPU=1 vllm serve \
    MiniMaxAI/MiniMax-M3 --trust-remote-code \
    --tensor-parallel-size 4 \
    --enable-auto-tool-choice --tool-call-parser minimax_m2 \
--reasoning-parser minimax_m2_append_think8 卡部署:
SAFETENSORS_FAST_GPU=1 vllm serve \
    MiniMaxAI/MiniMax-M3 --trust-remote-code \
    --enable_expert_parallel --tensor-parallel-size 8 \
    --enable-auto-tool-choice --tool-call-parser minimax_m2 \
--reasoning-parser minimax_m2_append_think由于模型较大,首次加载时间较长,可能需要半小时以上。
如遇到 CUDA 内存错误,可在启动参数中添加
--compilation-config "{\"cudagraph_mode\": \"PIECEWISE\"}"解决。
curl 测试
使用 curl 调用 OpenAI 兼容接口:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M3",
    "messages": [
      {"role": "system", "content": [{"type": "text", "text": "You are a helpful assistant."}]},
      {"role": "user", "content": [{"type": "text", "text": "请简要介绍 MiniMax-M3 模型的特点。"}]}
    ]
}'调用示例
以下示例均使用 OpenAI 官方 Python SDK 调用 vLLM 的 OpenAI 兼容接口。
聊天对话(Chat Completions)
# test_chat.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M3",
    messages=[
        {"role": "user", "content": "请介绍 MiniMax-M3 相比 M2.5 有哪些提升?"}
    ],
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)

msg = response.choices[0].message
print("MiniMax-M3:", msg.content)运行:
python test_chat.py流式输出(Streaming)
# test_streaming.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

stream = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M3",
    messages=[{"role": "user", "content": "请用 Python 写一个快速排序算法,并附带详细注释。"}],
    stream=True,
    max_tokens=32768,
    top_p=0.95,
    temperature=1.0,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta and delta.content:
print(delta.content, end="", flush=True)运行:
python test_streaming.py图片输入(Vision)
MiniMax-M3 原生支持图片输入。在 OpenAI 兼容接口中,将 image_url 与文本一起放入 content 数组即可:
# test_vision.py
from openai import OpenAI

client = OpenAI(api_key="EMPTY", base_url="http://127.0.0.1:8000/v1")

response = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M3",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "请描述这张图片中的内容。"},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://upload.wikimedia.org/wikipedia/commons/thumb/3/3a/Cat03.jpg/640px-Cat03.jpg"},
                },
            ],
        }
    ],
    max_tokens=4096,
)
print(response.choices[0].message.content)仅支持图片输入;视频、音频、文档暂不支持。
工具调用(Tool Calling)
MiniMax-M3 在 Agent 和工具调用方面继续保持强表现,能够稳定执行复杂长链条工具调用任务。在 vLLM 部署时通过 --enable-auto-tool-choice --tool-call-parser minimax_m2 启用工具调用功能。
# test_tool_calling.py
from openai import OpenAI
import json

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

def get_weather(location: str, unit: str):
    return f"Getting the weather for {location} in {unit}..."

tool_functions = {"get_weather": get_weather}

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the current weather in a given location",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "City and state, e.g., 'San Francisco, CA'"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
            },
            "required": ["location", "unit"]
        }
    }
}]

response = client.chat.completions.create(
    model=client.models.list().data[0].id,
    messages=[{"role": "user", "content": "北京今天天气怎么样?请用摄氏度。"}],
    tools=tools,
    tool_choice="auto"
)

tool_call = response.choices[0].message.tool_calls[0].function
print(f"Function called: {tool_call.name}")
print(f"Arguments: {tool_call.arguments}")
print(f"Result: {get_weather(**json.loads(tool_call.arguments))}")运行:
python test_tool_calling.py参数说明与建议
model:启动时指定的模型名称或本地路径(例:MiniMaxAI/MiniMax-M3);OpenAI 请求中的 model 需与之对应。
--tensor-parallel-size:张量并行大小,常设为 GPU 数量(4 或 8)。
--enable_expert_parallel:启用专家并行(8 卡示例中开启)。
--enable-auto-tool-choice:自动工具选择(使模型在需要时自主发起工具调用)。
--tool-call-parser minimax_m2:启用 MiniMax 的工具调用解析。
--reasoning-parser minimax_m2_append_think:启用思考内容解析(将 reasoning 以追加方式处理)。
max_tokens:控制生成长度,M3 支持最大 128K 输出;过大将增加显存和时延。
temperature/top_p:控制多样性。官方推荐参数:temperature=1.0, top_p=0.95, top_k=20。
显存建议:M3 权重约 220 GB;每 1M 上下文约 240 GB。请结合业务并发与上下文需求评估资源。
常见问题
Hugging Face 网络问题
如果遇到网络问题,可设置镜像后再进行拉取:
export HF_ENDPOINT=https://hf-mirror.comMiniMax-M3 model is not currently supported
该 vLLM 版本过旧,请升级到最新版本:
pip install -U vllmtorch.AcceleratorError: CUDA error
在启动参数添加 --compilation-config "{\"cudagraph_mode\": \"PIECEWISE\"}" 可以解决。
模型输出乱码
请升级到最新版本的 vLLM,并确保使用与 MiniMax-M3 适配的版本。
参考链接
MiniMax-M3 SGLang 部署调用
MiniMax-M3 简介
MiniMax-M3 是 MiniMax 推出的最新一代开源大语言模型。相较于 M2.5,M3 在长上下文、推理质量和多模态能力上均有明显提升:上下文窗口扩展到 512K、单次最大输出可达 128K,并原生支持图片输入(OpenAI 兼容与 Anthropic 兼容两套接口均可使用,目前仅图片,视频/音频/文档暂不支持)。
本文以 MiniMax-M3 为模型基座,演示如何通过 SGLang 完成模型下载、服务启动与客户端调用(含图片输入)。
SGLang 简介
SGLang 是一个面向大语言模型的高性能部署推理框架,提供开箱即用的推理加速与 OpenAI 兼容接口。它支持长上下文推理、流式输出、多卡并行(如张量并行与专家并行)、工具调用与"思考内容"解析等能力,便于将最新模型快速落地到生产环境。
环境准备
基础环境(参考值):
可用
nvidia-smi与python -c "import torch;print(torch.version.cuda, torch.cuda.is_available())"自检 CUDA / PyTorch。
显存与推荐配置(按官方文档):
权重需求约 220 GB 显存;每 1M 上下文 token 约需 240 GB 显存
96G × 4 GPU:支持约 40 万 token 总上下文
144G × 8 GPU:支持约 300 万 token 总上下文
注:上下文窗口最大为 512K,单次最大输出为 128K;以上数值为硬件支持的最大并发缓存总量。
安装依赖:
建议使用虚拟环境(venv / conda / uv)避免依赖冲突
uv venv
source .venv/bin/activate
uv pip install sglang请确保 SGLang 版本支持 MiniMax-M3,可使用
pip show sglang查看当前安装的版本,必要时升级。
模型下载
SGLang 会在首次启动时自动从 Hugging Face 拉取并缓存模型,无需手动下载。若希望提前下载或受网络限制,可选用 modelscope 手动下载模型:
# model_download.py
from modelscope import snapshot_download

model_dir = snapshot_download('MiniMaxAI/MiniMax-M3', cache_dir='/root/autodl-tmp', revision='master')
print(f"模型下载成功,保存到: {model_dir}")pip install modelscope
python model_download.py注意:使用
modelscope下载模型时无需设置 HF 镜像。若不使用 modelscope,而是让 SGLang 自动从 Hugging Face 拉取,网络受限时可设置镜像:export HF_ENDPOINT=https://hf-mirror.com
启动 SGLang 服务
Python 启动脚本
新建 start_server.py:
import torch
from sglang.utils import launch_server_cmd, wait_for_server

gpu_count = torch.cuda.device_count() if torch.cuda.is_available() else 0
if gpu_count == 4:
    cmd = (
        "python -m sglang.launch_server "
        "--model-path MiniMaxAI/MiniMax-M3 "
        "--host 0.0.0.0 "
        "--port 8000 "
        "--tp-size 4 "
        "--tool-call-parser minimax-m2 "
        "--reasoning-parser minimax-append-think "
        "--trust-remote-code "
        "--mem-fraction-static 0.85"
    )
elif gpu_count == 8:
    cmd = (
        "python -m sglang.launch_server "
        "--model-path MiniMaxAI/MiniMax-M3 "
        "--host 0.0.0.0 "
        "--port 8000 "
        "--tp-size 8 "
        "--ep-size 8 "
        "--tool-call-parser minimax-m2 "
        "--reasoning-parser minimax-append-think "
        "--trust-remote-code "
        "--mem-fraction-static 0.85"
    )
else:
    raise RuntimeError(f"建议使用 4 或 8 张 GPU,当前检测到: {gpu_count}")

server_process, port = launch_server_cmd(cmd, port=8000)
wait_for_server(f"http://127.0.0.1:{port}")
print(f"SGLang Server started: http://127.0.0.1:{port}")启动:
python start_server.py服务启动成功后将监听 http://127.0.0.1:8000/v1。
命令行直接启动
4 卡部署:
python -m sglang.launch_server \
  --model-path MiniMaxAI/MiniMax-M3 \
  --tp-size 4 \
  --tool-call-parser minimax-m2 \
  --reasoning-parser minimax-append-think \
  --host 0.0.0.0 \
  --trust-remote-code \
  --port 8000 \
--mem-fraction-static 0.858 卡部署:
python -m sglang.launch_server \
  --model-path MiniMaxAI/MiniMax-M3 \
  --tp-size 8 \
  --ep-size 8 \
  --tool-call-parser minimax-m2 \
  --trust-remote-code \
  --host 0.0.0.0 \
  --reasoning-parser minimax-append-think \
  --port 8000 \
--mem-fraction-static 0.85由于模型较大,首次加载时间较长,可能需要半小时以上。
curl 测试
使用 curl 调用 OpenAI 兼容接口:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "MiniMaxAI/MiniMax-M3",
    "messages": [
      {"role": "system", "content": [{"type": "text", "text": "You are a helpful assistant."}]},
      {"role": "user", "content": [{"type": "text", "text": "请简要介绍 MiniMax-M3 模型的特点。"}]}
    ]
}'调用示例
以下示例均使用 OpenAI 官方 Python SDK 调用 SGLang 的 OpenAI 兼容接口。
聊天对话(Chat Completions)
# test_chat.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

response = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M3",
    messages=[
        {"role": "user", "content": "请介绍 MiniMax-M3 相比 M2.5 有哪些提升?"}
    ],
    max_tokens=8192,
    top_p=0.95,
    temperature=1.0,
)

msg = response.choices[0].message
print("MiniMax-M3:", msg.content)运行:
python test_chat.py流式输出(Streaming)
# test_streaming.py
from openai import OpenAI

client = OpenAI(
    api_key="EMPTY",
    base_url="http://127.0.0.1:8000/v1",
)

stream = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M3",
    messages=[{"role": "user", "content": "请用 Python 实现一个二叉搜索树,包含插入、查找和删除操作。"}],
    stream=True,
    max_tokens=32768,
    top_p=0.95,
    temperature=1.0,
)

for chunk in stream:
    delta = chunk.choices[0].delta
    if delta and delta.content:
print(delta.content, end="", flush=True)运行:
python test_streaming.py图片输入(Vision)
MiniMax-M3 原生支持图片输入。在 OpenAI 兼容接口中,将 image_url 与文本一起放入 content 数组即可:
# test_vision.py
from openai import OpenAI

client = OpenAI(api_key="EMPTY", base_url="http://127.0.0.1:8000/v1")

response = client.chat.completions.create(
    model="MiniMaxAI/MiniMax-M3",
    messages=[
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "请描述这张图片中的内容。"},
                {
                    "type": "image_url",
                    "image_url": {"url": "https://upload.wikimedia.org/wikipedia/commons/thumb/3/3a/Cat03.jpg/640px-Cat03.jpg"},
                },
            ],
        }
    ],
    max_tokens=4096,
)
print(response.choices[0].message.content)仅支持图片输入;视频、音频、文档暂不支持。
工具调用(Tool Calling)
MiniMax-M3 在 Agent 和工具调用方面继续保持强表现。在 SGLang 部署时通过 --tool-call-parser minimax-m2 启用工具调用功能。
# test_tool_calling.py
from openai import OpenAI
import json

client = OpenAI(base_url="http://localhost:8000/v1", api_key="EMPTY")

def get_weather(location: str, unit: str):
    return f"Getting the weather for {location} in {unit}..."

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "Get the current weather in a given location",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "City and state, e.g., 'San Francisco, CA'"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
            },
            "required": ["location", "unit"]
        }
    }
}]

response = client.chat.completions.create(
    model=client.models.list().data[0].id,
    messages=[{"role": "user", "content": "北京今天天气怎么样?请用摄氏度。"}],
    tools=tools,
    tool_choice="auto"
)

tool_call = response.choices[0].message.tool_calls[0].function
print(f"Function called: {tool_call.name}")
print(f"Arguments: {tool_call.arguments}")
print(f"Result: {get_weather(**json.loads(tool_call.arguments))}")运行:
python test_tool_calling.py参数说明与建议
--model-path:模型名称或本地路径(例:MiniMaxAI/MiniMax-M3)。
--tp-size:张量并行大小,常设为 GPU 数量(4 或 8)。
--ep-size:专家并行大小(8 卡示例中开启)。
--tool-call-parser minimax-m2:启用 MiniMax 的工具调用解析。
--reasoning-parser minimax-append-think:启用思考内容解析。
--mem-fraction-static:静态显存比例,显存紧张时可适当调低。
--trust-remote-code:信任远程代码(MiniMax 模型需要此参数)。
官方推荐采样参数:temperature=1.0, top_p=0.95, top_k=20。
M3 单次最大输出可达 128K token;按业务需要设置 max_tokens。
显存建议:M3 权重约 220 GB;每 1M 上下文约 240 GB。请结合业务并发与上下文需求评估资源。
常见问题
Hugging Face 网络问题
如果遇到网络问题,可设置镜像后再进行拉取:
export HF_ENDPOINT=https://hf-mirror.comMiniMax-M3 model is not currently supported
请升级到最新的稳定版本:
pip install -U sglang参考链接
MiniMax-M3 Transformers 部署调用
MiniMax-M3 简介
MiniMax-M3 是 MiniMax 推出的最新一代开源大语言模型。相较于 M2.5,M3 在长上下文、推理质量和多模态能力上均有明显提升:上下文窗口扩展到 512K、单次最大输出可达 128K,并原生支持图片输入(仅图片,视频/音频/文档暂不支持)。本文演示如何通过 Transformers 直接加载并运行 MiniMax-M3 模型。
环境准备
基础环境(参考值):
OS:Linux
Python:3.9 - 3.12
Transformers:>= 4.57.1
GPU:compute capability 7.0 or higher,显存需求约 220 GB
安装依赖:
建议使用虚拟环境(venv / conda / uv)避免依赖冲突
uv venv
source .venv/bin/activate
uv pip install transformers==4.57.1 torch accelerate --torch-backend=auto模型下载
Transformers 会在首次加载时自动从 Hugging Face 下载并缓存模型。若网络受限,可使用 modelscope 提前下载:
# model_download.py
from modelscope import snapshot_download

model_dir = snapshot_download('MiniMaxAI/MiniMax-M3', cache_dir='/root/autodl-tmp', revision='master')
print(f"模型下载成功,保存到: {model_dir}")pip install modelscope
python model_download.py注意:使用
modelscope下载模型时无需设置 HF 镜像。若不使用 modelscope,而是直接通过 Transformers 从 Hugging Face 下载,网络受限时可设置镜像:export HF_ENDPOINT=https://hf-mirror.com
推理示例
基础对话
# test_transformers.py
from transformers import AutoModelForCausalLM, AutoTokenizer
import torch

MODEL_PATH = "MiniMaxAI/MiniMax-M3"

model = AutoModelForCausalLM.from_pretrained(
    MODEL_PATH,
    device_map="auto",
    trust_remote_code=True,
)
tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH)

messages = [
    {"role": "user", "content": [{"type": "text", "text": "请介绍一下 MiniMax-M3 模型的主要特点。"}]},
]

model_inputs = tokenizer.apply_chat_template(
    messages, return_tensors="pt", add_generation_prompt=True
).to("cuda")

generated_ids = model.generate(
    model_inputs,
    max_new_tokens=2048,
    generation_config=model.generation_config,
)

response = tokenizer.batch_decode(generated_ids)[0]
print(response)运行:
python test_transformers.py多轮对话
# test_multi_turn.py
from transformers import AutoModelForCausalLM, AutoTokenizer

MODEL_PATH = "MiniMaxAI/MiniMax-M3"

model = AutoModelForCausalLM.from_pretrained(
    MODEL_PATH,
    device_map="auto",
    trust_remote_code=True,
)
tokenizer = AutoTokenizer.from_pretrained(MODEL_PATH)

messages = [
    {"role": "user", "content": [{"type": "text", "text": "什么是快速排序?"}]},
    {"role": "assistant", "content": [{"type": "text", "text": "快速排序是一种高效的排序算法,采用分治策略,通过选择一个基准元素将数组分为两部分,然后递归排序。"}]},
    {"role": "user", "content": [{"type": "text", "text": "请用 Python 实现它。"}]},
]

model_inputs = tokenizer.apply_chat_template(
    messages, return_tensors="pt", add_generation_prompt=True
).to("cuda")

generated_ids = model.generate(
    model_inputs,
    max_new_tokens=2048,
    generation_config=model.generation_config,
)

response = tokenizer.batch_decode(generated_ids)[0]
print(response)运行:
python test_multi_turn.py长输出(≤128K)
M3 支持单次最大 128K 的输出长度,按需调整 max_new_tokens 即可:
generated_ids = model.generate(
    model_inputs,
    max_new_tokens=131072,   # 128K
    generation_config=model.generation_config,
)输出越长,显存与时延越高,建议结合任务实际需求设置。
常见问题
Hugging Face 网络问题
若未使用 modelscope 下载模型,而是直接通过 Transformers 从 Hugging Face 下载,可设置镜像:
export HF_ENDPOINT=https://hf-mirror.com若已通过
modelscope下载模型并指定了本地路径,则无需此设置。
MiniMax-M3 model is not currently supported
请确认已开启 trust_remote_code=True,并升级 Transformers 至 >= 4.57.1:
pip install -U transformers参考链接
MiniMax-M3 BF16 8 卡 LoRA 微调及 SwanLab 可视化
本教程介绍如何在 8 张 NVIDIA RTX PRO 6000 Blackwell Server Edition 上,使用 Transformers、PEFT 和 DeepSpeed ZeRO-3 CPU Offload 对 MiniMax-M3 BF16 进行 LoRA 微调,并使用 SwanLab 记录训练过程、tmux 保持任务运行。
本次结果证明该方案可以完成 forward、backward、optimizer step 和 adapter 保存。4 条样本、1 个 step 只用于验证训练链路,不代表模型已经完成有效收敛。
目录
1. 实验结论
2. 硬件与软件环境
3. 代码结构
4. 模型下载
5. 环境配置
6. 安装 ZeRO-3 流式加载补丁
7. 构建指令数据
8. LoRA 与 ZeRO-3 配置
9. SwanLab
10. 使用 tmux 启动训练
11. 训练结果
12. 扩展为正式训练
13. 常见问题
14. 限制与复现边界
- 实验结论
MiniMax-M3 BF16 共有约 4270.6 亿参数,59 个 safetensors 分片,权重目录约 796 GiB。8 张卡的总显存仍小于 BF16 权重体积,因此不能使用普通的 GPU-only LoRA。
本教程采用以下组合:
DeepSpeed ZeRO-3 将参数切分到 8 个 rank。
offload_param=cpu 将 ZeRO 参数分片放入内存。
定制 Transformers 5.12.1 的 ZeRO-3 加载路径,避免每个 rank 合并全部 59 个分片。
LoRA 只训练语言模型 attention 的 q_proj、k_proj、v_proj 和 o_proj。
使用 reentrant gradient checkpointing 控制训练显存。
最终 smoke test 成功完成:
| 项目 | 结果 |
| 总参数 | 427,060,285,184 |
| LoRA 可训练参数 | 20,152,320(0.0047%) |
| 最大序列长度 | 128 |
| 训练 step | 1 |
| Loss | 65.6567 |
| Grad norm | 13.2417 |
| 单个训练 step | 约 189.85 秒 |
| Trainer 总时间 | 约 313.1 秒,包含 checkpoint 保存 |
| Adapter 大小 | 40,376,216 字节,约 38.5 MiB |
SwanLab 实验记录:
- 硬件与软件环境
2.1 硬件
| 资源 | 实测配置 |
| GPU | 8 x NVIDIA RTX PRO 6000 Blackwell Server Edition |
| 单卡显存 | 97,887 MiB,约 95.6 GiB |
| CPU | Intel Xeon Platinum 8470Q,208 vCPU |
| 物理内存 | 约 1 TiB |
| 容器内存上限 | 944,892,805,120 字节,约 880 GiB |
| Swap | 无 |
| 本地数据盘 | XFS,约 1.2 TiB |
加载阶段每张卡约使用 17.4 GiB,容器内存一度接近 880 GiB 上限;训练阶段每张卡约使用 63.4 GiB。该配置几乎没有内存余量,不建议在训练时运行其他大内存任务。
2.2 软件
Python        3.12
torch         2.11.0+cu130
transformers  5.12.1
accelerate    1.14.0
datasets      5.0.0
peft          0.19.1
deepspeed     0.18.9
swanlab       0.8.4
modelscope    1.38.0
safetensors   0.8.0
tokenizers    0.22.2
- 代码结构
models/MiniMax-M3/
├── 4-MiniMax-M3-BF16-LoRA及SwanLab可视化.md
└── finetune/
    ├── requirements.txt
    ├── bin/
    │   ├── apply_transformers_patch.sh
    │   ├── download_model.py
    │   └── source_env.sh
    ├── data/
    │   └── tiny_qa.jsonl
    ├── patches/
    │   └── transformers-5.12.1-zero3-streaming.patch
    ├── secrets/
    │   └── env.example
    └── train/
        ├── deepspeed_zero3_cpu_offload.json
        ├── finetune_m3_bf16_zero3.py
└── run_m3_bf16_zero3_tmux.sh将代码同步到训练机:
rsync -av models/MiniMax-M3/finetune/ \
auto:/root/autodl-fs/experiments/minimax-m3-8gpu/模型权重、训练输出、日志和密钥不包含在本目录中。
- 模型下载
本次使用 ModelScope 上的 MiniMax/MiniMax-M3,直接下载到 1.2 TiB 本地数据盘:
cd /root/autodl-fs/experiments/minimax-m3-8gpu
python bin/download_model.py \
  --model-id MiniMax/MiniMax-M3 \
  --output /root/autodl-tmp/models/MiniMax-M3-BF16 \
--workers 8全量模型约 796 GiB。新下载建议至少准备 850 GiB 空闲空间,并确认得到 59 个权重分片:
du -sh /root/autodl-tmp/models/MiniMax-M3-BF16
find /root/autodl-tmp/models/MiniMax-M3-BF16 \
-maxdepth 1 -name 'model-*.safetensors' | wc -l预期第二条命令输出 59。
本教程必须使用 BF16 基座。NVFP4/FP8 推理 checkpoint 不能直接替代为普通 PEFT/Trainer 训练基座。
- 环境配置
创建独立环境:
conda create -y -p /root/miniconda3/envs/minimax-m3-bf16-lora python=3.12
conda activate /root/miniconda3/envs/minimax-m3-bf16-lora先使用平台镜像或 PyTorch 官方 CUDA 13.0 安装方式准备 torch==2.11.0+cu130,再安装其余依赖:
python -m pip install -r requirements.txt核对环境:
python - <<'PY'
from importlib.metadata import version
import torch

print("torch", torch.__version__)
for package in ["transformers", "deepspeed", "peft", "swanlab"]:
    print(package, version(package))
print("gpu_count", torch.cuda.device_count())
PY需要看到 8 张 GPU,且版本与第 2 节一致。
- 安装 ZeRO-3 流式加载补丁
6.1 为什么需要补丁
Transformers 5.12.1 的默认 ZeRO-3 加载路径会先把所有 checkpoint shard 合并为一个完整 state_dict。对于约 796 GiB 的 MiniMax-M3,这会使每个 rank 尝试物化完整权重并被系统杀死。
本目录中的补丁做了三件事:
仅由 rank 0 逐组读取 safetensors,其他 rank 接收 key 和必要 buffer。
将跨物理 shard 的同一 MoE expert layer 组成完整加载组,避免 expert 数量不匹配。
每组通过 ZeRO-3 collective 写入参数分片后立即释放临时 state_dict。
该补丁只匹配 Transformers 5.12.1,并包含 MiniMax-M3 权重 key 规则,不应直接应用到其他版本或模型。
6.2 应用补丁
cd /root/autodl-fs/experiments/minimax-m3-8gpu
source bin/source_env.sh
bash bin/apply_transformers_patch.sh脚本会检查版本、保存 modeling_utils.py.minimax-m3.orig 备份,并支持重复执行。
- 构建指令数据
训练数据使用 JSON Lines,每行包含 instruction 和 response:
{"instruction":"用一句话解释为什么实验需要记录随机种子。","response":"记录随机种子可以帮助复现实验结果并定位结果波动的来源。"}示例数据位于 finetune/data/tiny_qa.jsonl,共 4 条,只用于 smoke test。训练脚本使用 MiniMax-M3 的 chat template 拼接 user/assistant 消息,再生成 input_ids 和 labels。
正式训练时应替换为任务数据,并先独立检查:
python - <<'PY'
import json

path = "data/tiny_qa.jsonl"
with open(path, encoding="utf-8") as handle:
    rows = [json.loads(line) for line in handle if line.strip()]
assert rows and all({"instruction", "response"} <= row.keys() for row in rows)
print("samples", len(rows))
PY
- LoRA 与 ZeRO-3 配置
8.1 LoRA target
MiniMax-M3 是 MoE 模型。为了控制参数量和训练风险,本教程冻结全部 expert,仅匹配语言模型 attention projection:
target_modules = (
    r"^model\.language_model\.layers\.\d+\.self_attn\."
    r"(q_proj|k_proj|v_proj|o_proj)$"
)LoRA 参数为:
r=8
lora_alpha=16
lora_dropout=0.05
task_type=CAUSAL_LM8.2 DeepSpeed ZeRO-3 CPU Offload
核心配置如下:
{
  "bf16": {"enabled": "auto"},
  "train_micro_batch_size_per_gpu": "auto",
  "gradient_accumulation_steps": "auto",
  "train_batch_size": "auto",
  "zero_optimization": {
    "stage": 3,
    "offload_param": {"device": "cpu", "pin_memory": false},
    "stage3_param_persistence_threshold": 100000,
    "stage3_max_live_parameters": 200000000,
    "stage3_max_reuse_distance": 200000000,
    "stage3_prefetch_bucket_size": 50000000,
    "stage3_gather_16bit_weights_on_model_save": false
  }
}pin_memory=false 是有意设置:本实验内存已经接近容器上限,额外锁页会进一步压缩可用空间。
8.3 必须使用 reentrant checkpointing
实测配置为:
gradient_checkpointing=True
gradient_checkpointing_kwargs={"use_reentrant": True}同时执行:
model.enable_input_require_grads()
model.gradient_checkpointing_enable(
    gradient_checkpointing_kwargs={"use_reentrant": True}
)关闭 gradient checkpointing 会让 forward 阶段每卡使用约 92.35 GiB,随后因还需申请 4.50 GiB 而 CUDA OOM。使用 use_reentrant=False 则会在 backward 重算时与 ZeRO-3 参数释放冲突,出现 checkpoint tensor 从正常 shape 变成 [0] 的错误。
- SwanLab
将 SwanLab API Key 写入本地 secret 文件:
mkdir -p secrets
cat > secrets/.env.local <<'EOF'
SWANLAB_API_KEY=替换为自己的_API_Key
EOF
chmod 600 secrets/.env.local脚本只在 rank 0 初始化 SwanLab,避免 8 个 rank 创建重复实验。swanlab.finish(async_log_timeout=30) 用于限制异步日志收尾等待;本次原始 smoke run 在 adapter 保存后曾卡在无超时的 finish(),因此教程代码增加了该参数。
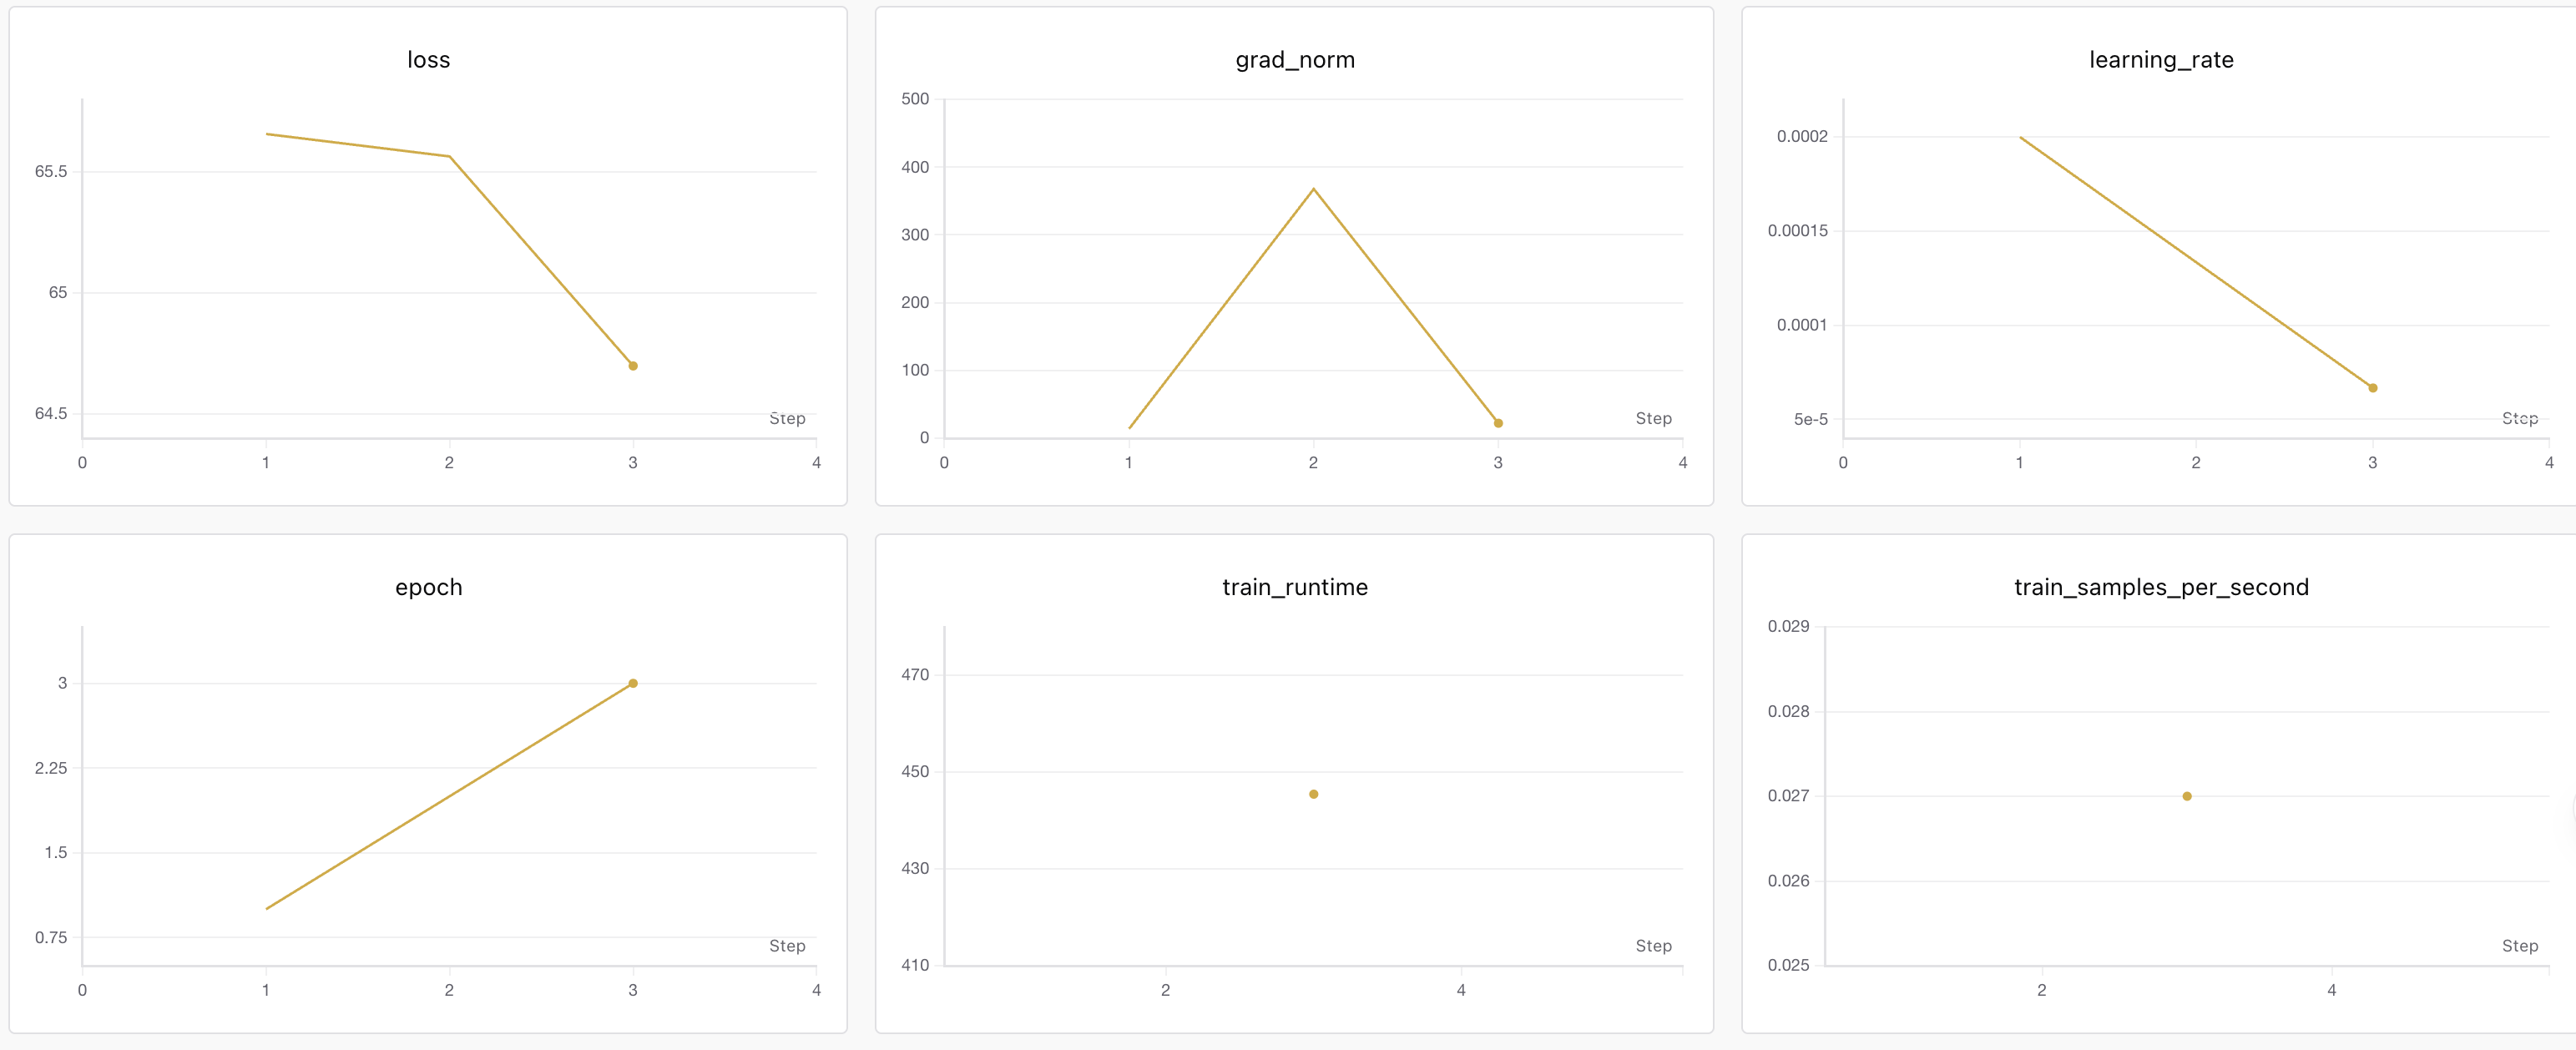
3 epoch 实验的 SwanLab 指标曲线如下:
- 使用 tmux 启动训练
先做 1 step smoke test:
cd /root/autodl-fs/experiments/minimax-m3-8gpu
chmod +x bin/*.sh train/*.sh

RUN_ID="$(date +%Y%m%d-%H%M)-reentrant-smoke" \
MAX_STEPS=1 \
MAX_LENGTH=128 \
TMUX_SESSION=minimax-m3-bf16-zero3-smoke \
bash train/run_m3_bf16_zero3_tmux.sh按 3 个 epoch 运行并在 SwanLab 中记录每个 step:
RUN_ID="$(date +%Y%m%d-%H%M)-3epoch" \
MAX_STEPS=-1 \
NUM_TRAIN_EPOCHS=3 \
MAX_LENGTH=128 \
TMUX_SESSION=minimax-m3-bf16-zero3-3epoch \
bash train/run_m3_bf16_zero3_tmux.shMAX_STEPS 大于 0 时优先按 step 停止;设置为 -1 时才使用 NUM_TRAIN_EPOCHS。
启动器会立即返回 tmux session、日志和输出目录。查看状态:
tmux ls
tmux attach -t minimax-m3-bf16-zero3-smoke不进入 tmux 也可以查看日志:
tail -f logs/minimax-m3-bf16-zero3-lora-<RUN_ID>.log检查资源:
nvidia-smi
cat /sys/fs/cgroup/memory.current
cat /sys/fs/cgroup/memory.max
cat /sys/fs/cgroup/memory.events终态文件:
cat output/minimax-m3-bf16-zero3-lora-<RUN_ID>/.terminal_status0 表示成功,非 0 表示失败。无文件表示训练仍在运行或启动器尚未收尾。
- 训练结果
成功运行的关键日志:
trainable params: 20,152,320 || all params: 427,060,285,184 || trainable%: 0.0047
100%|██████████| 1/1 [03:09<00:00, 189.85s/it]
{'loss': '65.66', 'grad_norm': '13.24', 'learning_rate': '0.0002', 'epoch': '1'}
{'train_runtime': '313.1', 'train_samples_per_second': '0.026',
'train_steps_per_second': '0.003', 'train_loss': '65.66', 'epoch': '1'}主要输出:
adapter_model.safetensors
adapter_config.json
tokenizer.json
run_metadata.json
checkpoint-1/本次 adapter 的 SHA-256:
c51e4c35bf7eb7a16208f7ed7baa31685fce2a5a276498ca9e65dd62f95bd98a验证输出:
out=output/minimax-m3-bf16-zero3-lora-<RUN_ID>
test -s "$out/adapter_model.safetensors"
test -s "$out/adapter_config.json"
sha256sum "$out/adapter_model.safetensors"
- 扩展为正式训练
smoke test 通过后,通过 DATA_PATH 替换数据并增加步数:
RUN_ID="$(date +%Y%m%d-%H%M)-train" \
MAX_STEPS=50 \
MAX_LENGTH=256 \
DATA_PATH=/root/autodl-tmp/data/train.jsonl \
TMUX_SESSION=minimax-m3-bf16-zero3-train \
bash train/run_m3_bf16_zero3_tmux.sh按 smoke test 的单步时间粗略外推,50 step 的纯训练时间约 2.6 小时,另需约 20 至 30 分钟加载模型和保存;真实时间会随序列长度与数据变化。
正式实验至少应增加:
独立训练集和验证集。
合理的 epoch/step、warmup 和学习率计划。
固定随机种子并记录数据版本。
定期 checkpoint 与恢复训练验证。
训练后任务指标和生成质量评估。
- 常见问题
13.1 加载时进程被 SIGKILL
若使用未打补丁的 Transformers 5.12.1,每个 rank 会合并全部模型分片,内存远超上限。确认第 6 节补丁已经应用,并检查 memory.events。
13.2 MoE expert tensor 数量不一致
MiniMax-M3 的一个 expert layer 可能横跨两个物理 safetensors。不能简单地逐文件调用 ZeRO loader;本教程补丁会按完整 MoE layer 分组。
13.3 CheckpointError 中 recomputed shape 为 [0]
这是 non-reentrant gradient checkpointing 与 ZeRO-3 参数释放冲突。确认两处配置均为 use_reentrant=True。
13.4 CUDA OOM,尝试申请 4.50 GiB
这通常表示 gradient checkpointing 被关闭。实测无 checkpointing 时每卡已使用约 92.35 GiB,只剩约 2.61 GiB。
13.5 SwanLab 页面迟迟不出现
本脚本在模型加载、LoRA 注入之后才调用 swanlab.init()。约 796 GiB 权重的首次加载实测需要 20 分钟以上,因此加载期间看不到 run 属于正常现象。
13.6 已保存 adapter,但 tmux 不退出
检查是否停在 swanlab.finish()。教程代码已设置 async_log_timeout=30;如果仍出现问题,先确认 adapter、checkpoint、trainer_state.json 和 run_metadata.json 已落盘,再排查 SwanLab 网络或升级兼容版本,不要直接把训练结果判为失败。
- 限制与复现边界
本教程验证的是 8 卡、约 880 GiB 容器内存上限的特定机器,较小内存实例大概率无法加载。
Transformers 补丁绑定 5.12.1 和 MiniMax-M3 权重命名;升级前必须重新审查上游加载实现。
当前仅完成 4 样本、1 step smoke test,没有验证模型质量提升。
没有在本次实验中重新加载 adapter 做完整生成评估;推理验证应作为正式训练后的独立步骤。
CPU offload 的代价是加载和训练速度较慢,但它避免了 GPU-only 无法容纳 BF16 基座的问题。