Kimi-K2.5 论文解读
Kimi-K2.5 是一个开源的,原生多模态的 agentic model。正如 Kimi-K2.5 在发布时所引用的那句话 “The soul never thinks without a mental image” 一样,多模态能力对于实现更强大的智能至关重要。因此,接下来将围绕多模态和智能体两个关键词对于 Kimi-K2.5 的技术报告进行解读。先附上一个简易目录。
图文联合优化(Joint Optimization of Text and Vision)
原生多模态预训练
零视觉 SFT
多模态联合强化学习
智能体集群(Agent Swarm)
并行智能体强化学习(PARL)
Kimi-K2.5 架构与训练
MoonViT 3D 压缩策略
训练策略
图文联合优化(Joint Optimization of Text and Vision)
K2.5 emphasizes the joint optimization of text and vision so that two modalities enhance each other. K2.5 强调文本模态与视觉模态的联合优化,使两种模态互相增强。
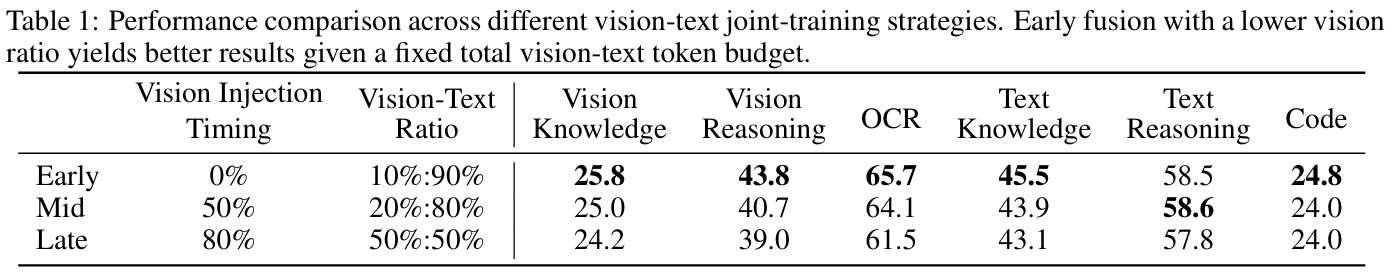
在预训练方面,不同于之前的方法(在靠后的训练阶段,才给文本模型加入视觉 token),Kimi-K2.5 在训练早期就以较低比例混入了视觉数据。
在架构方面,Kimi-K2.5 使用了 MoonViT-3D。为了理解视频,还引入了一种轻量化的 3D ViT 压缩策略。即,连续的4帧视为一组,经过相同的 MoonViT 处理后,并在时间维度对 patch 进行平均。
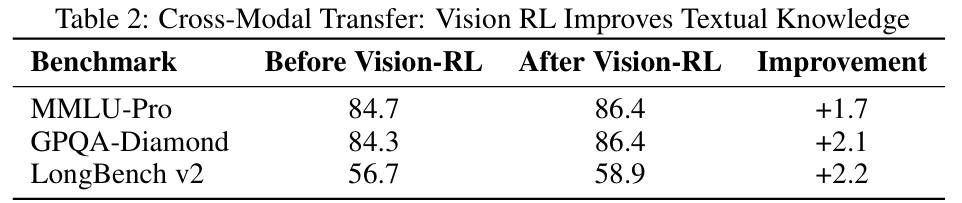
在后训练方面,Kimi-K2.5 采用了零视觉 SFT,即仅使用文本数据激活模型的视觉推理和工具调用能力。此外,Kimi-K2.5 还在文本和视觉任务上应用了联合强化学习。视觉任务上的强化学习不仅不会损害文本能力,反而会提升。同时,文本任务上的强化学习也会促进视觉能力。
原生多模态预训练
先前的方法会在训练后期以较高比例(比如大于50%)混入视觉数据,将视觉能力进行事后追加。
但是,经过实验,早期以较低比例混入视觉数据可以得到更好的效果,这有助于模型获得较为均衡的多模态表征。
零视觉 SFT
为了让预训练的 VLM 获得基于视觉的工具调用能力,Kimi-K2.5 仅使用文本数据来进行 SFT,作为后续视觉强化学习的冷启动。所有的图片操作均通过 IPython 进行代理。
这种零视觉 SFT训练,激活了模型多种推理行为。包括物体大小估计(通过二值化和计数),并泛化到各种视觉定位任务(物体定位、计数和 OCR)。
此外,实验说明,视觉-文本 SFT 的效果不如仅文本 SFT,这可能是因为缺少高质量的视觉数据。
多模态联合强化学习
由于零视觉 SFT,视觉输入有时候会被忽略。因此,在视觉理解任务上采用了基于结果的强化学习。主要分为三类:视觉定位与计数、图表与文档理解、依赖视觉的 STEM (数学、科学等)任务。
根据下表实验结果,基于结果的视觉强化学习对于文本能力的强化也起到了作用。视觉强化学习增强校准了需要结构化信息提取的领域,就像是减少了视觉基础推理(技术、OCR)的查询的不确定性。视觉强化学习可以增强文本推理能力,而不是降低语言能力。
因此,Kimi-K2.5 采用了多模态联合强化学习,不再按照输入模态组织,而是按照能力(知识、推理、代码、agent)来组织 RL。同时,生成式奖励模型(Generative Reward Model)打破了模态的障碍。
智能体集群(Agent Swarm)
The limited capacity of a single agent working through each step one by one can lead to the exhaustion of practical
reasoning depth and tool-call budgets, ultimately hindering the system’s ability to handle more complex scenarios.
单个智能体依次逐步执行任务的有限能力,可能导致实际推理深度和工具调用配额的耗尽,最终阻碍系统处理更复杂场景的能力。
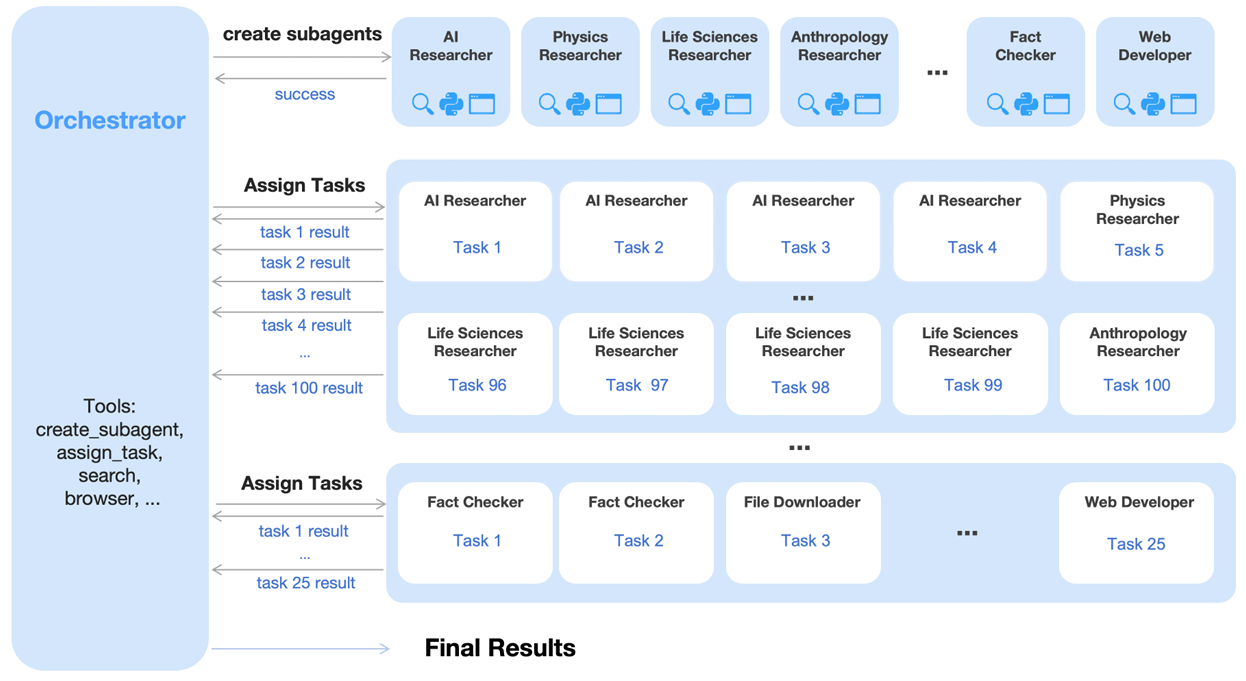
Agent Swarm 可谓是 Kimi-K2.5 引入的最有趣的内容。正如技术报告中所说,K2.5 不是将任务执行视为推理链,也不是预定义的并行化启发式方法,而是通过动态任务分解,子 agent 实例化和并行任务调度来启动智能体的集群。如下图所示,智能体集群由一个超级智能体 Orchestrator 通过调用 create_subagent 实现子 agent 的创建以及任务的拆分与分发。
并行智能体强化学习(PARL)
为了实现“何时并行,如何并行”,Kimi-K2.5 采用了 RL 的方法来进行探索学习。具体地,强化学习过程中的 reward 设计为:
$r_{\text{PARL}}(x, y) = \lambda_1 r_{\text{parallel}} + \lambda_2 r_{\text{finish}} + r_{\text{perf}}(x, y)$
其中, $x$ 是任务, $y$ 是解法。奖励函数的三部分分别评估了:并行度、子任务完成率,任务 $x$ 的完成表现。
并行度奖励虽然鼓励模型生成更加并行化的任务拆分,但也引入了生成无效子 agent 来骗取并行度的 reward hacking 嫌疑。但是子任务完成率一项通过关注子 agent 有没有把事情做完来避免虚假并行。
为了衡量并行智能体的计算开销,类比于图中的关键路径,关键步骤(Critical Steps)被提出。定义为:
图中的关键路径
graph LR
    A --3--> B
    A --5--> C
    B --7--> D
    C --1--> D
D --2--> E如上图所示,A->B->D->E 的总开销为 3+7+2=12,而 A->C->D->E 的开销为 5+1+2=8,因此 A->B->D->E 为该图的关键路径。
$\text{CriricalSteps} = \sum_{t=1}^T (S_{\text{main}}^{(t)} + \max_i S_{\text{sub}}^{(t)})$
对于每一个时刻,关键步骤的组成为:主 agent 的行动步骤数 + 最长耗时的子 agent 的行动步骤数。在该指标下,不减少最大执行时间的过多子任务创建没有益处,均衡的任务分解才有用。
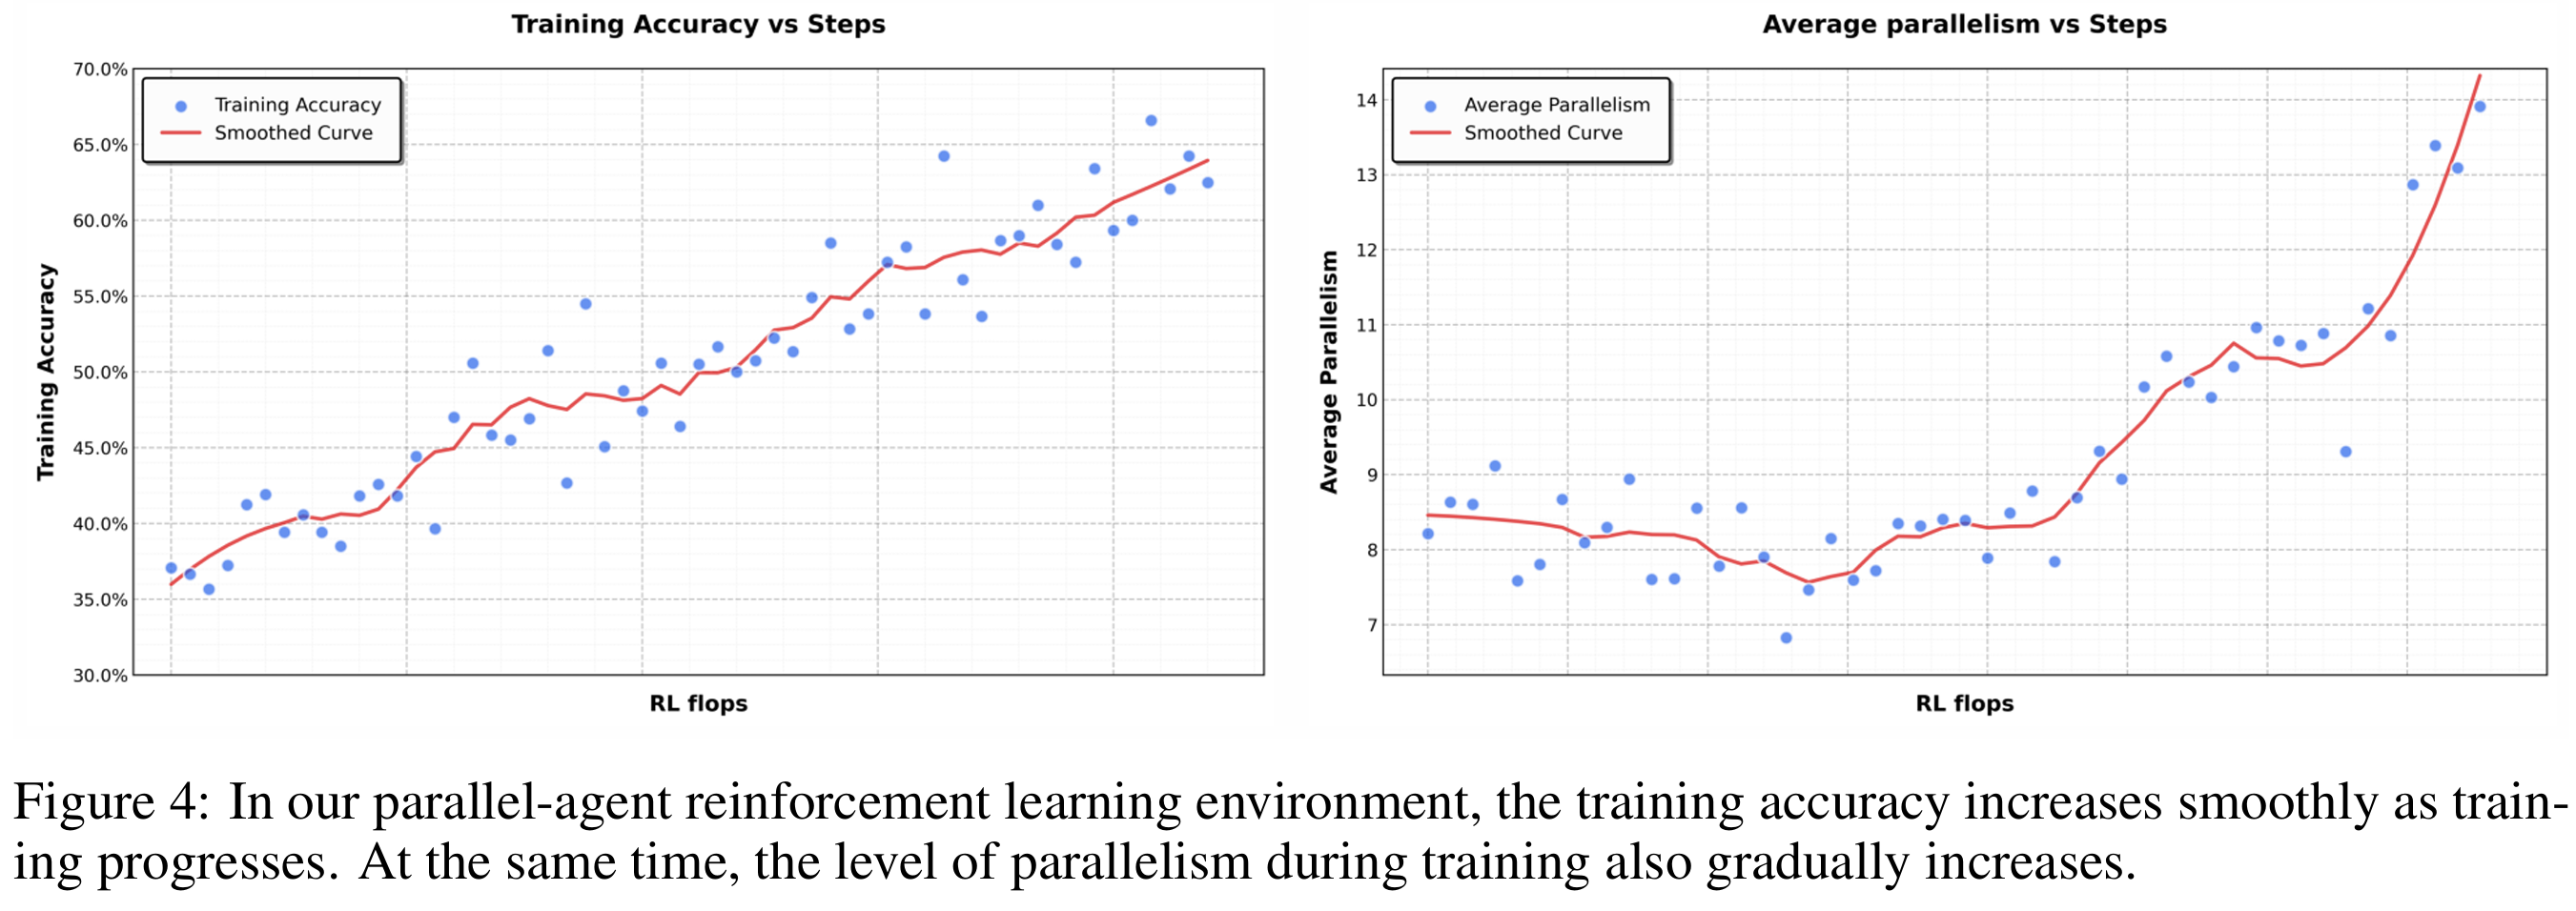
如下图所示,随着 PARL 的进行,准确率与 agent 并行度都有明显增长。
Kimi-K2.5 架构与训练
MoonViT 3D 压缩策略
连续的4帧视为一组,经过相同的 MoonViT 处理后,并在时间维度对 patch 进行平均。
连续的4帧作为一组的具体代码位于 https://huggingface.co/moonshotai/Kimi-K2.5/blob/main/kimi_k25_vision_processing.py#L63-L98 。
具体地,就是首先根据视频的原始帧率与采样帧率计算出待采样帧的索引,然后采样真实的视频帧,接着每4个连续的采样帧作为一个 video_chunk 以备后续处理。
而压缩策略的具体代码位于 https://huggingface.co/moonshotai/Kimi-K2.5/blob/main/modeling_kimi_k25.py#L623-L625 。
在经过 MoonViT 处理后,得到的视觉信息序列的 shape 为 [L, D]。此时根据 grid_thws 拿回原本的时间信息、高度方向的 patch 数目,宽度方向的 patch 数目,就可以将patch 长度信息重新解析回时-空信息,从而对时间维度进行平均。相关处理函数如下:
时间维度 patch 平均代码
def tpool_patch_merger(
        x: torch.Tensor,
        grid_thws: torch.Tensor,
        merge_kernel_size: tuple[int, int] = (2, 2),
) -> list[torch.Tensor]:
    d_model = x.size(-1)

    outputs = []
    pre_sum = 0
    for t, h, w in grid_thws.tolist():
        # Get the current sequence
        seq = x[pre_sum:pre_sum + t * h * w]
        # Reshape along self.merge_kernel_size and concat to the last dimension
        kernel_height, kernel_width = merge_kernel_size
        new_height, new_width = h // kernel_height, w // kernel_width
        reshaped_seq = seq.view(t, new_height, kernel_height, new_width,
                                kernel_width, d_model)
        reshaped_seq = reshaped_seq.permute(0, 1,
                                            3, 2, 4, 5).contiguous().mean(
                                                dim=0)  # temporal pooling
        padded_seq = reshaped_seq.view(new_height * new_width,
                                       kernel_height * kernel_width, -1)
        outputs.append(padded_seq)
        pre_sum += t * h * w

return outputs训练策略
预训练
如下表所示,Kimi-K2.5 的预训练基于 Kimi-K2,使用了约 15T tokens。首先,单独训练 ViT;其次,联合训练,增强语言-视觉能力;最后,用高质量数据和长文本数据进一步提升能力,并拓展上下文窗口。
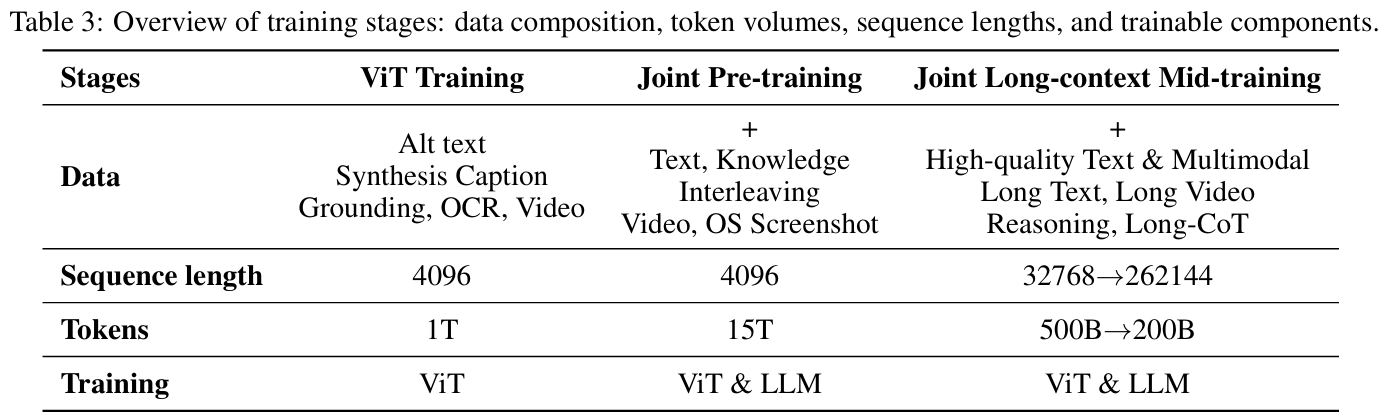
MoonViT-3D 从 SigLIP 继续预训练而来,训练数据包括图像替代文本、图像视频的合成标签、检测框和 OCR 文本。在第一阶段,通过描述损失函数将 MoonViT-3D 与 Moonlight-16B-A3B 进行对齐,主要让 ViT 理解高分辨率图像和视频。在第二阶段,只开放连接 MoonViT-3D 与 1T 参数的 LLM 的 projector 的训练。
在联合训练阶段,首先通过引入独特的 token,调整数据比例和增加代码数据,以拓展预训练分布。
在预训练的第三阶段(高质量&长文本)时,通过 YaRN 来拓展上下文窗口。
后训练
SFT 训练阶段主要通过一系列模型(K2、K2 Thinking、内部模型)构造了高质量的回复。最终构造了一个大规模指令优化数据集,以让模型优先关注互动推理和精确的工具调用。
在 RL 阶段,优化目标为:
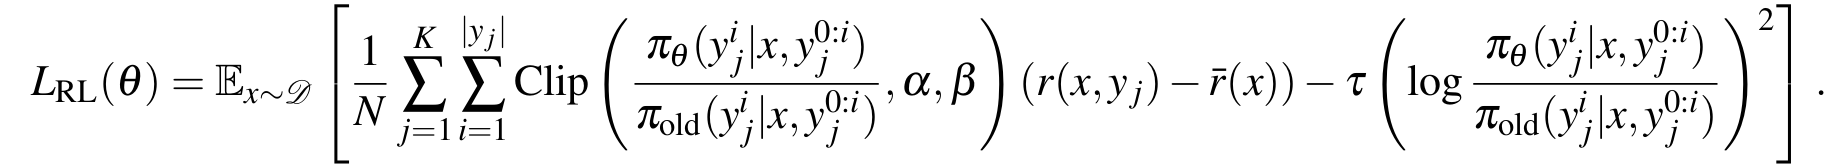
具体地,引入了一个 token 级的剪裁机制来缓解训练与推理不一致的问题,只计算策略比例落在 $[\alpha, \beta]$ 范围的 token 的梯度。不同于 PPO,该方案只考虑比例范围,而不考虑优势的符号。
在奖励函数方面,通用任务使用生成式奖励模型(Generative Reward Model);视觉定位和点定位任务,使用 F1-score 和软匹配;分割任务,使用 IoU;OCR 任务使用归一化编辑距离;计数任务使用预测值与真实值的绝对差值。此外,还合成了复杂的视觉 puzzle,并使用 Kimi-K2 作为验证。
此外,Kimi-K2.5 还应用了 Token Efficient RL,以激励模型生成更简洁的推理过程。具体地,对于 iteration $t$ ,奖励函数为
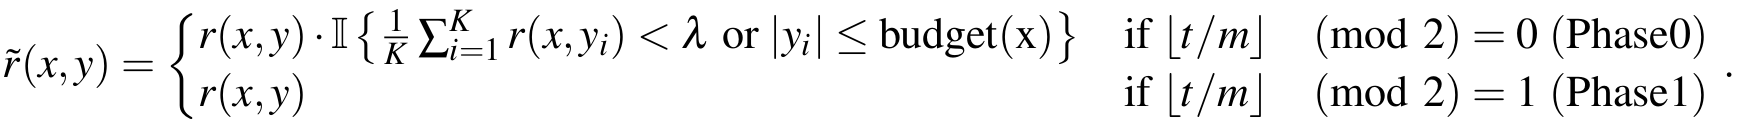
其中, $\lambda$ 和 $m$ 是超参数, $K$ 是采样次数,算法每隔 $m$ 个 iteration 交替阶段。
在阶段0,当模型的准确率超过阈值时,鼓励模型在 token budget 内完成。在阶段1,鼓励模型使用更多的计算资源提升表现。Token budget 具体为正确的响应的长度集合的第 $\rho$ 百分位。
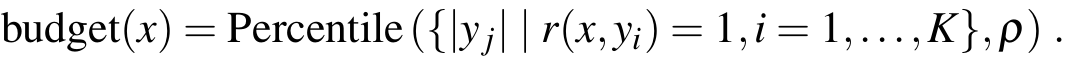
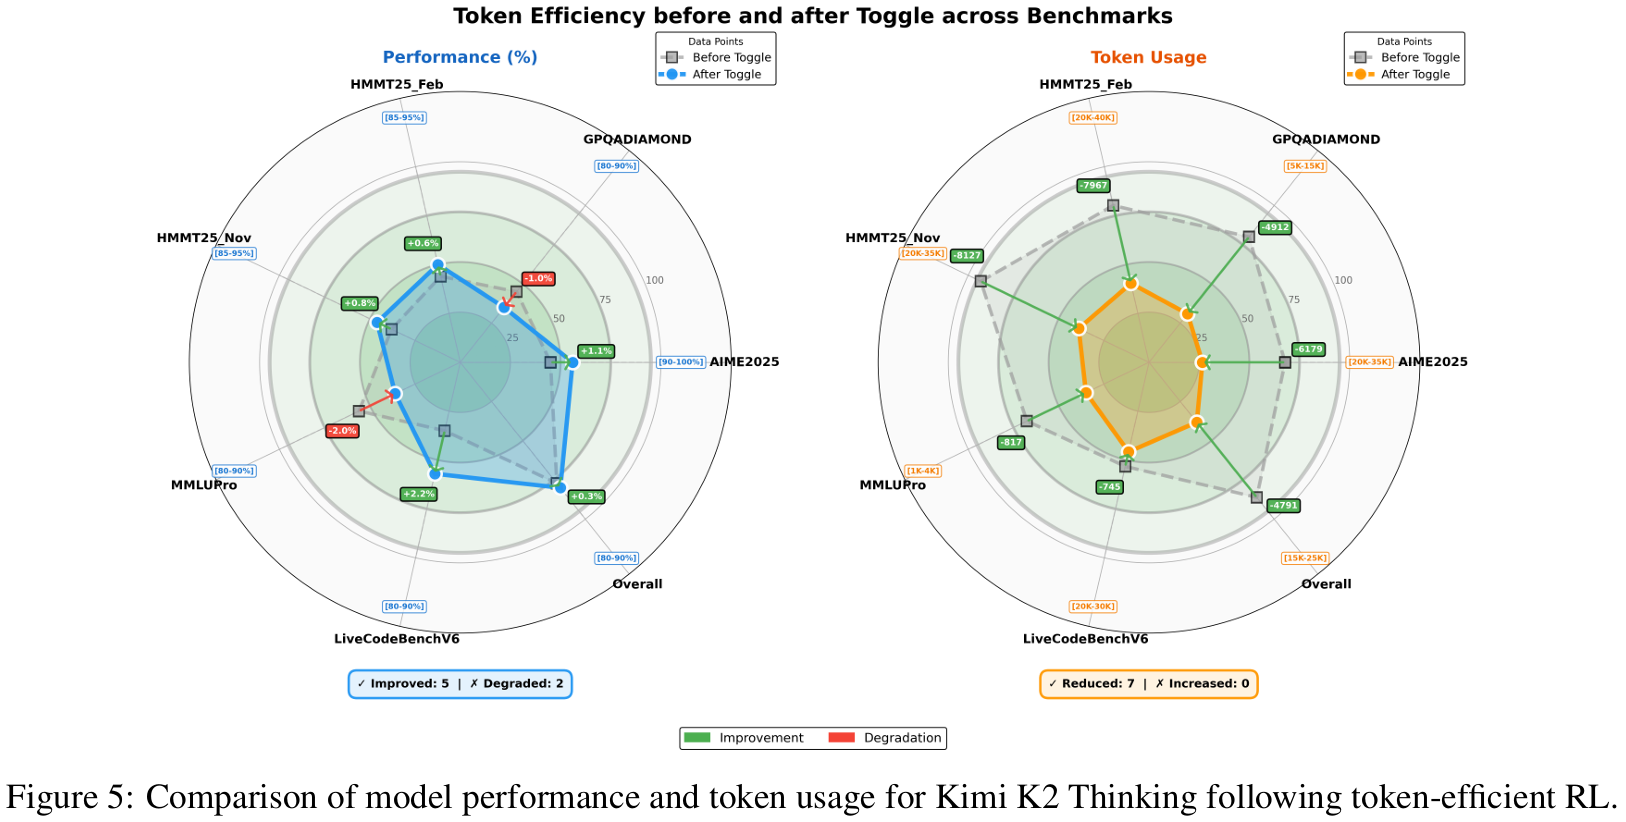
如下图所示,经过 token efficient RL 后,模型表现几乎没有变化,而模型的 token 使用量有明显下降。
02-KiMi-2.5 vLLM 部署调用
vLLM 简介
vLLM 框架是一个高效的大语言模型推理和部署服务系统,具备以下特性:
高效的内存管理:通过 PagedAttention 算法,vLLM 实现了对 KV 缓存的高效管理,减少了内存浪费,优化了模型的运行效率。
高吞吐量:vLLM 支持异步处理和连续批处理请求,显著提高了模型推理的吞吐量,加速了文本生成和处理速度。
易用性:vLLM 与 HuggingFace 模型无缝集成,支持多种流行的大型语言模型,简化了模型部署和推理的过程。兼容 OpenAI 的 API 服务器。
分布式推理:框架支持在多 GPU 环境中进行分布式推理,通过模型并行策略和高效的数据通信,提升了处理大型模型的能力。
开源共享:vLLM 由于其开源的属性,拥有活跃的社区支持,这也便于开发者贡献和改进,共同推动技术发展。
环境准备
本文基础环境如下:
----------------
ubuntu 22.04
python 3.12
cuda 12.8
pytorch 2.8.0
----------------本文默认学习者已配置好以上
Pytorch (cuda)环境,如未配置请先自行安装。
首先 pip 换源加速下载并安装依赖包
python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

pip install modelscope
pip install vllm考虑到部分同学配置环境可能会遇到一些问题,我们在 AutoDL 平台准备了 KiMi-2.5 的环境镜像,点击下方链接并直接创建 Autodl 示例即可。 datawhalechina/self-llm/KIMI-2.5-vllm | AutoDL
模型下载
使用 modelscope 中的 snapshot_download 函数下载模型,第一个参数为模型名称,参数 cache_dir 为模型的下载路径。
新建 model_download.py 文件并在其中输入以下内容,粘贴代码后记得保存文件。
from modelscope import snapshot_download

model_dir = snapshot_download('moonshotai/Kimi-K2.5', cache_dir='/root/autodl-tmp', revision='master')然后在终端中输入 python model_download.py 执行下载,这里需要耐心等待一段时间直到模型下载完成。
注意:记得修改
cache_dir为你的模型下载路径哦~
代码准备
Python 脚本
新建 vllm_model.py 文件并在其中输入以下内容,粘贴代码后请及时保存文件。下面的代码有很详细的注释,如有不理解的地方,欢迎大家提 issue。
首先从 vLLM 库中导入 LLM 和 SamplingParams 类。LLM 类是使用 vLLM 引擎运行离线推理的主要类。SamplingParams 类指定采样过程的参数,用于控制和调整生成文本的随机性和多样性。
vLLM 提供了非常方便的封装,我们直接传入模型名称或模型路径即可,不必手动初始化模型和分词器。
然后,通过使用分词器的 apply_chat_template 函数,将我们的 prompt(提示词)格式化为模型所需的输入格式。
我们可以通过这个代码示例熟悉下 vLLM 引擎的使用方式。被注释的部分内容可以丰富模型的能力,但不是必要的,大家可以按需选择,自己多多动手尝试 ~
from vllm import LLM, SamplingParams
from transformers import AutoTokenizer
import os
import json

# 自动下载模型时,指定使用modelscope; 否则,会从HuggingFace下载
os.environ['VLLM_USE_MODELSCOPE']='True'

def get_completion(prompts, model, tokenizer=None, temperature=0.6, top_p=0.95, top_k=20, min_p=0, max_tokens=4096, max_model_len=8192):
    stop_token_ids = [151645, 151643]
    # 创建采样参数。temperature 控制生成文本的多样性,top_p 控制核心采样的概率,top_k 通过限制候选词的数量来控制生成文本的质量和多样性, min_p 通过设置概率阈值来筛选候选词,从而在保证文本质量的同时增加多样性
    sampling_params = SamplingParams(temperature=temperature, top_p=top_p, top_k=top_k, min_p=min_p, max_tokens=max_tokens, stop_token_ids=stop_token_ids)  # max_tokens 用于限制模型在推理过程中生成的最大输出长度
    # 初始化 vLLM 推理引擎
    llm = LLM(model=model, tokenizer=tokenizer, max_model_len=max_model_len,trust_remote_code=True, tensor_parallel_size=8)  # max_model_len 用于限制模型在推理过程中可以处理的最大输入和输出长度之和。
    outputs = llm.generate(prompts, sampling_params)
    return outputs


if __name__ == "__main__":
    # 初始化 vLLM 推理引擎
    model='/root/autodl-fs/moonshotai/Kimi-K2.5' # 指定模型路径
    tokenizer = AutoTokenizer.from_pretrained(model) # 加载分词器

    prompt = "给我一个关于大模型的简短介绍。"
    messages = [
        {"role": "user", "content": prompt}
    ]
    text = tokenizer.apply_chat_template(
        messages,
        tokenize=False,
        add_generation_prompt=True,
        enable_thinking=True  # 是否开启思考模式,默认为 True
    )

    outputs = get_completion(text, model, tokenizer=None, temperature=0.6, top_p = 0.95, top_k=20, min_p=0)  # 对于思考模式,官方建议使用以下参数:temperature = 0.6,TopP = 0.95,TopK = 20,MinP = 0。

    # 输出是一个包含 prompt、生成文本和其他信息的 RequestOutput 对象列表。
    # 打印输出。
    for output in outputs:
        prompt = output.prompt
        generated_text = output.outputs[0].text
print(f"Prompt: {prompt!r}, \nResponse: {generated_text!r}")运行代码
python vllm_model.py结果如下:
Prompt: '<|im_user|>user<|im_middle|>给我一个关于大模型的简短介绍。<|im_end|><|im_assistant|>assistant<|im_middle|><think>',
Response: ' 用户要求一个关于大模型的简短介绍。我需要提供一个简洁、准确且全面的概述,涵盖大模型的基本概念、特点和应用。\n\n关键点应该包括:\n1. 什么是大模型(Large Language Models/LLMs或Foundation Models)\n2. 核心特点(参数规模大、训练数据多、涌现能力等)\n3. 主要应用领域\n4. 简要的技术背景(Transformer架构、预训练+微调范式)\n5. 当前主流代表(GPT、Claude、文心一言等)\n\n需要保持简短,控制在200-300字左右,语言通俗易懂但专业准确。\n\n结构建议:\n- 定义(1-2句)\n- 技术特点(1-2句)\n- 能力表现(1-2句)\n- 应用场景(1句)\n- 局限性提示(可选,简要)\n\n让我组织一下内容:\n\n大模型(Large Language Models,LLM)是基于深度学习技术的人工智能系统,通常包含数十亿至数千亿参数,通过海量文本数据训练而成。它们以Transformer架构为基础,采用"预训练+微调"的技术路线,具备强大的语言理解、生成和推理能力。\n\n这类模型的核心特征包括规模效应(参数越多能力越强)、上下文学习(In-context Learning)和涌现能力(Emergent Abilities)。典型代表如GPT-4、Claude、文心一言等,已广泛应用于智能客服、内容创作、代码生成、知识问答等领域。\n\n尽管大模型展现出接近人类的语言交互能力,但仍存在幻觉(生成虚假信息)、知识时效性等局限,通常需要结合检索增强(RAG)等技术来提升可靠性。\n\n字数检查:约200字,符合"简短介绍"的要求。内容涵盖了定义、技术、应用和局限,比较全面。 </think> 大模型(Large Language Models,LLM)是基于深度学习的人工智能系统,通常包含数十亿至数千亿参数,通过海量文本数据训练而成。它们以Transformer架构为基础,采用"预训练+微调"的技术路线,具备强大的语言理解、生成和推理能力。\n\n这类模型的核心特征包括**规模效应**(参数越多能力越强)、**上下文学习**(无需微调即可适应新任务)和**涌现能力**(复杂能力的突然出现)。典型代表如GPT-4、Claude、文心一言等,已广泛应用于智能客服、内容创作、代码生成、知识问答等领域。\n\n尽管大模型展现出接近人类的语言交互能力,但仍存在**幻觉**(生成虚假信息)、知识时效性等局限,实际应用中常需结合检索增强(RAG)等技术提升可靠性。'模型的 response 由两部分组成,一部分是思考过程,用\和\包裹住,另一部分是最终答案,在\标识符之后。
创建兼容 OpenAI API 接口的服务器
KiMi-2.5 兼容 OpenAI API 协议,所以我们可以直接使用 vLLM 创建 OpenAI API 服务器。vLLM 部署实现 OpenAI API 协议的服务器非常方便。默认会在 http://localhost:8000 启动服务器。服务器当前一次托管一个模型,并实现列表模型、completions 和 chat completions 端口。
completions:是基本的文本生成任务,模型会在给定的提示后生成一段文本。这种类型的任务通常用于生成文章、故事、邮件等。
chat completions:是面向对话的任务,模型需要理解和生成对话。这种类型的任务通常用于构建聊天机器人或者对话系统。
在创建服务器时,我们可以指定模型名称、模型路径、聊天模板等参数。
--host 和 --port 参数指定地址。
--model 参数指定模型名称。
--chat-template 参数指定聊天模板。
--served-model-name 指定服务模型的名称。
--max-model-len 指定模型的最大长度。
--enable-reasoning 开启思考模式
--reasoning-parser 指定如何解析模型生成的推理内容。设置 --enable-reasoning 参数时,--reasoning-parser 是必需的。推理模型会在输出中包含一个额外的 reasoning_content 字段,该字段包含导致最终结论的推理步骤。通过指定合适的解析器,可以正确提取和格式化这些推理内容。
我们复制以下命令到终端上,就可以成功启动 KiMi-2.5 模型的 API 接口
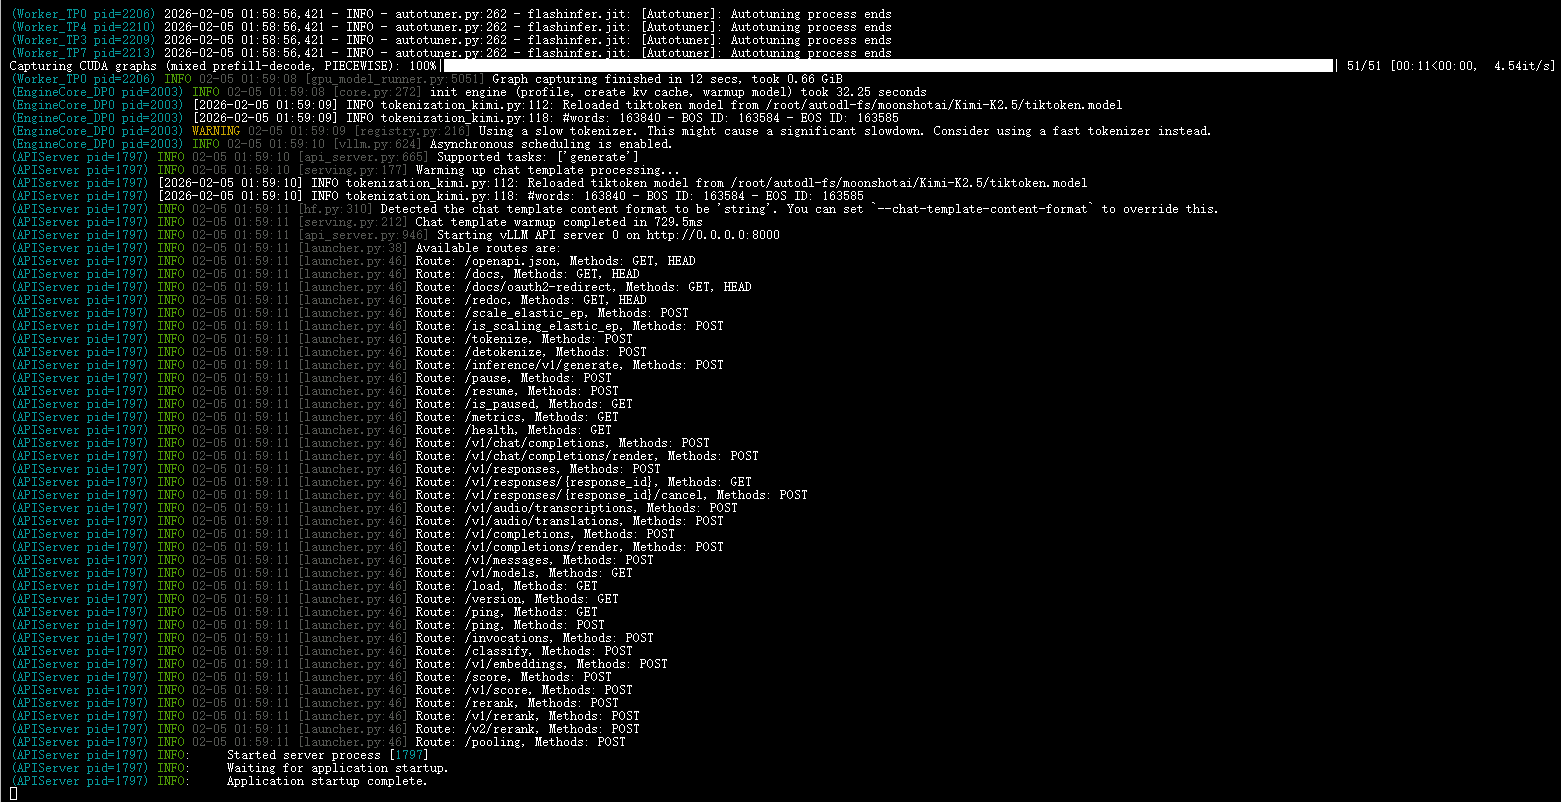
VLLM_USE_MODELSCOPE=true vllm serve /root/autodl-fs/moonshotai/Kimi-K2.5 -tp 8 --max_model_len 8192 --trust-remote-code --tool-call-parser kimi_k2 --reasoning-parser kimi_k2加载完毕后出现如下信息说明服务成功启动
通过 curl 命令查看当前的模型列表
curl http://localhost:8000/v1/models得到的返回值如下所示
{
    "object": "list",
    "data": [
        {
            "id": "/root/autodl-fs/moonshotai/Kimi-K2.5",
            "object": "model",
            "created": 1770228068,
            "owned_by": "vllm",
            "root": "/root/autodl-fs/moonshotai/Kimi-K2.5",
            "parent": null,
            "max_model_len": 8192,
            "permission": [
                {
                    "id": "modelperm-91d23e09c5068ccb",
                    "object": "model_permission",
                    "created": 1770228068,
                    "allow_create_engine": false,
                    "allow_sampling": true,
                    "allow_logprobs": true,
                    "allow_search_indices": false,
                    "allow_view": true,
                    "allow_fine_tuning": false,
                    "organization": "*",
                    "group": null,
                    "is_blocking": false
                }
            ]
        }
    ]
}用 curl 命令测试 OpenAI Chat Completions API
curl http://localhost:8000/v1/completions \
    -H "Content-Type: application/json" \
    -d '{
        "model": "/root/autodl-fs/moonshotai/Kimi-K2.5",
        "prompt": "我想问你,什么是深度学习算法?<think>\n",
        "max_tokens": 1024,
        "temperature": 0
}'得到的返回值如下所示
{
    "id": "cmpl-899843517a844968",
    "object": "text_completion",
    "created": 1770228473,
    "model": "/root/autodl-fs/moonshotai/Kimi-K2.5",
    "choices": [
        {
            "index": 0,
            "text": "深度学习算法是机器学习的一个子集,它基于人工神经网络,特别是具有多个隐藏层的神经网络(因此称为“深度”)。这些算法通过模拟人脑处理信息的方式来学习数据的复杂模式和表示。\n\n## 核心特点\n\n| 特点 | 说明 |\n|------|------|\n| **多层结构** | 包含输入层、多个隐藏层和输出层 |\n| **自动特征提取** | 无需人工设计特征,自动从原始数据中学习 |\n| **端到端学习** | 直接从输入映射到输出 |\n| **大数据需求** | 通常需要大量训练数据 |\n| **计算密集** | 依赖GPU等硬件加速 |\n\n## 主要架构类型\n\n1. **卷积神经网络 (CNN)** — 图像处理、计算机视觉\n2. **循环神经网络 (RNN/LSTM)** — 序列数据、自然语言处理\n3. **Transformer** — 现代NLP主流(如GPT、BERT)\n4. **生成对抗网络 (GAN)** — 生成新数据\n5. **自编码器 (Autoencoder)** — 降维、特征学习\n\n## 简单比喻\n\n> 想象教小孩认猫:传统机器学习需要你先告诉它\"猫有尖耳朵、胡须、毛茸茸\";而深度学习只需给它看成千上万张猫的照片,它自己就能总结出\"猫\"的概念。\n\n## 典型应用\n\n- 语音识别(Siri、Alexa)\n- 图像识别(人脸识别、医学影像)\n- 自然语言处理(机器翻译、ChatGPT)\n- 自动驾驶\n- 推荐系统\n\n你想深入了解哪个具体方面?比如训练过程、某种网络结构,或者实际应用?",
            "logprobs": null,
            "finish_reason": "stop",
            "stop_reason": 163586,
            "token_ids": null,
            "prompt_logprobs": null,
            "prompt_token_ids": null
        }
    ],
    "service_tier": null,
    "system_fingerprint": null,
    "usage": {
        "prompt_tokens": 9,
        "total_tokens": 352,
        "completion_tokens": 343,
        "prompt_tokens_details": null
    },
    "kv_transfer_params": null
}用 Python 脚本请求 OpenAI Chat Completions API
from openai import OpenAI
openai_api_key = "sk-xxx" # 随便填写,只是为了通过接口参数校验
openai_api_base = "http://localhost:8000/v1"

client = OpenAI(
    api_key=openai_api_key,
    base_url=openai_api_base,
)

chat_outputs = client.chat.completions.create(
    model="/root/autodl-fs/moonshotai/Kimi-K2.5",
    messages=[
        {"role": "user", "content": "什么是大模型?"},
    ]
)
print(chat_outputs)python vllm_openai_chat_completions.py得到的返回值如下所示
ChatCompletion(id='chatcmpl-af0cb04e8460c288', choices=[Choice(finish_reason='stop', index=0, logprobs=None, message=ChatCompletionMessage(content=' **大模型**(Large Models,通常指大语言模型LLM)是指参数量巨大(通常数十亿到数千亿级别)、训练数据海量、计算资源需求极高的机器学习模型,尤其是基于深度学习的模型。\n\n以下是核心要点解析:\n\n## 1. 本质特征:「大」在哪里?\n- **参数规模大**:从数十亿(如GPT-3有1750亿参数)到万亿级别(如GPT-4据传超过1万亿),这些参数是模型学习到的"知识"的数学表示\n- **训练数据大**:需要TB甚至PB级别的文本、图像、代码等数据(相当于阅读了人类大部分公开知识)\n- **计算资源大**:训练一次需要数千张高端GPU/TPU运行数周至数月,成本可达数百万美元\n\n## 2. 技术基础\n主要基于**Transformer架构**(2017年Google提出),通过"注意力机制"(Attention)理解文本中词语之间的长距离关联,突破传统RNN的顺序处理限制。\n\n## 3. 核心能力(涌现现象)\n当模型达到特定规模后,会突然表现出小模型不具备的能力:\n- **上下文理解**:理解复杂指令和长篇对话\n- **推理能力**:数学计算、逻辑推演、代码生成\n- **知识整合**:跨领域知识迁移和综合\n- **少样本学习**(Few-shot):仅需几个示例就能掌握新任务\n\n## 4. 典型代表\n- **国外**:GPT-4/4o(OpenAI)、Claude(Anthropic)、Gemini(Google)、Llama(Meta)\n- **国内**:文心一言(百度)、通义千问(阿里)、讯飞星火、智谱ChatGLM、DeepSeek等\n\n## 5. 与中小模型的区别\n| 维度 | 大模型 | 传统小模型 |\n|------|--------|------------|\n| 参数 | 十亿级以上 | 百万-千万级 |\n| 训练方式 | 预训练+微调 | 针对特定任务训练 |\n| 泛化能力 | 通用性强,跨领域 | 专用性强,领域狭窄 |\n| 使用方式 | 提示词(Prompt)驱动 | 需要特征工程 |\n\n## 6. 局限性\n- **幻觉**(Hallucination):可能生成看似合理但错误的信息\n- **计算成本高**:推理需要大量算力\n- **数据偏见**:可能继承训练数据中的偏见\n- **可解释性差**:内部决策机制如同"黑箱"\n\n**简单比喻**:如果把AI比作大脑,传统模型是专精某科的"专科生"(如只会识别猫狗的视觉模型),大模型则是博览群书的"通才博士",能通过语言理解并处理各种复杂任务,但偶尔也会"一本正经地胡说八道"。', refusal=None, role='assistant', annotations=None, audio=None, function_call=None, tool_calls=[], reasoning=' 用户问的是"什么是大模型?"这是一个关于人工智能领域的基础概念问题。我需要用中文清晰、准确地解释这个概念。\n\n 大模型(Large Language Models 或 Large Models)的关键点包括:\n 1. 定义:参数量巨大的机器学习模型,通常是深度学习模型\n 2. 规模:数十亿到数千亿甚至万亿级别的参数\n 3. 技术基础:基于Transformer架构的神经网络\n 4. 训练数据:海量的文本、图像等多模态数据\n 5. 能力:涌现能力(Emergent abilities),如推理、生成、理解上下文等\n 6. 代表:GPT系列、BERT、文心一言、通义千问等\n 7. 应用:聊天机器人、代码生成、内容创作等\n\n 我应该从基础到深入,用通俗易懂的方式解释,同时保持技术准确性。\n\n 结构建议:\n 1. 简单定义(是什么)\n 2. 核心特征(为什么"大")\n 3. 工作原理(简要技术解释)\n 4. 主要能力(能做什么)\n 5. 典型代表(举例)\n 6. 局限性(平衡视角)\n\n 避免过于技术化的术语,但关键概念如"参数"、"Transformer"、"预训练"等需要提及并简要解释。 ', reasoning_content=' 用户问的是"什么是大模型?"这是一个关于人工智能领域的基础概念问题。我需要用中文清晰、准确地解释这个概念。\n\n 大模型(Large Language Models 或 Large Models)的关键点包括:\n 1. 定义:参数量巨大的机器学习模型,通常是深度学习模型\n 2. 规模:数十亿到数千亿甚至万亿级别的参数\n 3. 技术基础:基于Transformer架构的神经网络\n 4. 训练数据:海量的文本、图像等多模态数据\n 5. 能力:涌现能力(Emergent abilities),如推理、生成、理解上下文等\n 6. 代表:GPT系列、BERT、文心一言、通义千问等\n 7. 应用:聊天机器人、代码生成、内容创作等\n\n 我应该从基础到深入,用通俗易懂的方式解释,同时保持技术准确性。\n\n 结构建议:\n 1. 简单定义(是什么)\n 2. 核心特征(为什么"大")\n 3. 工作原理(简要技术解释)\n 4. 主要能力(能做什么)\n 5. 典型代表(举例)\n 6. 局限性(平衡视角)\n\n 避免过于技术化的术语,但关键概念如"参数"、"Transformer"、"预训练"等需要提及并简要解释。 '), stop_reason=163586, token_ids=None)], created=1770228828, model='/root/autodl-fs/moonshotai/Kimi-K2.5', object='chat.completion', service_tier=None, system_fingerprint=None, usage=CompletionUsage(completion_tokens=847, prompt_tokens=12, total_tokens=859, completion_tokens_details=None, prompt_tokens_details=None), prompt_logprobs=None, prompt_token_ids=None, kv_transfer_params=None)用 Python 脚本请求 OpenAI Chat Completions API
from openai import OpenAI

client = OpenAI(
    api_key="a", # 随便填
    base_url="http://localhost:8000/v1"
)

def add(a: float, b: float):
    return a + b

def mul(a: float, b: float):
    return a * b

def compare(a: float, b: float):
    if a > b:
        return f'{a} is greater than {b}'
    elif a < b:
        return f'{b} is greater than {a}'
    else:
        return f'{a} is equal to {b}'

def count_letter_in_string(a: str, b: str):
    string = a.lower()
    letter = b.lower()

    count = string.count(letter)
    return(f"The letter '{letter}' appears {count} times in the string.")


tools = [
{
    'type': 'function',
    'function': {
        'name': 'add',
        'description': 'Compute the sum of two numbers',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'int',
                    'description': 'A number',
                },
                'b': {
                    'type': 'int',
                    'description': 'A number',
                },
            },
            'required': ['a', 'b'],
        },
    }
},
{
    'type': 'function',
    'function': {
        'name': 'mul',
        'description': 'Calculate the product of two numbers',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'int',
                    'description': 'A number',
                },
                'b': {
                    'type': 'int',
                    'description': 'A number',
                },
            },
            'required': ['a', 'b'],
        },
    }
},
{
    'type': 'function',
    'function': {
        'name': 'count_letter_in_string',
        'description': 'Count letter number in a string',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'str',
                    'description': 'source string',
                },
                'b': {
                    'type': 'str',
                    'description': 'letter',
                },
            },
            'required': ['a', 'b'],
        },
    }
},
{
    'type': 'function',
    'function': {
        'name': 'compare',
        'description': 'Compare two number, which one is bigger',
        'parameters': {
            'type': 'object',
            'properties': {
                'a': {
                    'type': 'float',
                    'description': 'A number',
                },
                'b': {
                    'type': 'float',
                    'description': 'A number',
                },
            },
            'required': ['a', 'b'],
        },
    }
}
]

def function_call_playground(prompt):
    messages = [{'role': 'user', 'content': prompt}]
    response = client.chat.completions.create(
        model="/root/autodl-fs/moonshotai/Kimi-K2.5",
        messages = messages,
        temperature=0.01,
        top_p=0.95,
        stream=False,
        tools=tools)

    # print(response)
    func1_name = response.choices[0].message.tool_calls[0].function.name
    func1_args = response.choices[0].message.tool_calls[0].function.arguments
    func1_out = eval(f'{func1_name}(**{func1_args})')
    # print(func1_out)

    messages.append(response.choices[0].message)
    messages.append({
        'role': 'tool',
        'content': f'{func1_out}',
        'tool_call_id': response.choices[0].message.tool_calls[0].id
    })
    # print(messages)
    response = client.chat.completions.create(
        model="/root/autodl-fs/moonshotai/Kimi-K2.5",
        messages=messages,
        temperature=0.01,
        top_p=0.95,
        stream=False,
        tools=tools)
    return response.choices[0].message.content

prompts = [
    "用中文回答:strawberry中有多少个r?",
    "用中文回答:9.11和9.9,哪个小?"
]

for prompt in prompts:
print(function_call_playground(prompt))python vllm_openai_chat_completions.py得到的返回值如下所示
在字符串"strawberry"中,字母'r'出现了3次。
9.11比9.9小。

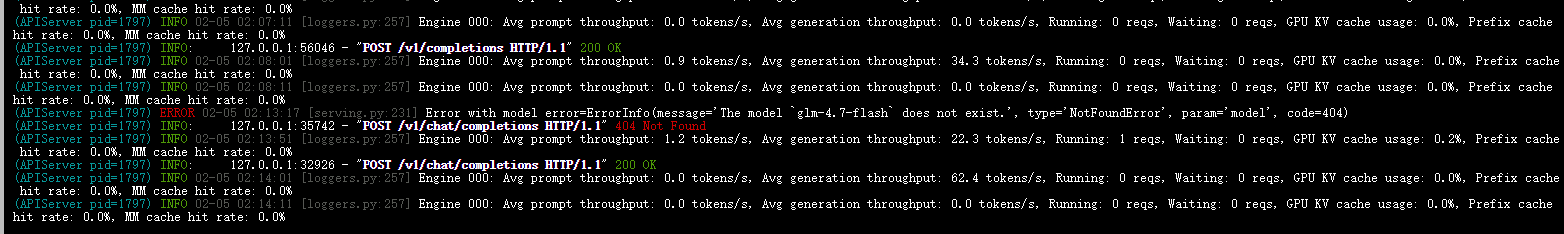
根据比较结果,9.9比9.11大,所以9.11更小。另外,在以上所有的在请求处理过程中, API 后端都会打印相对应的日志和统计信息:
03-Kimi-2.5-SGLang部署应用
本教程旨在帮助学习者在本地环境上,利用 SGLang 框架高效部署最新的 Kimi 2.5 (K2.5) 模型。
本地部署的必要性
数据隐私与安全:无需将敏感数据上传至云端,所有对话和处理均在本地内网完成,确保数据合规性。
极低延迟:消除网络传输波动,满足高频实时交互或自动化 Agent 任务的性能需求。
长期成本优势:对于吞吐量极大的业务,本地部署能节省昂贵的 API 调用费用。
SGLang、vLLM 与 Ollama 的对比分析
SGLang是一种高性能本地部署框架,其支持企业级的高并发场景,其倾向于半精度(FP16),跨设备、分布式能力较强;Ollama则适合个人轻量化本地运行,适合单设备部署,其主要采用4-bit量化,精度损失较大;而vLLM则介于二者之间,是工业级本地部署框架,支持较高的吞吐量,一般采用8-bit量化,是经济和精度的折中选择。本教程我们采用SGLang框架对于Kimi-2.5进行本地部署。
实验环境
硬件:NVIDIA RTX PRO 6000 (96GB) × 8卡
操作系统:Ubuntu 22.04
CUDA 版本:12.8
Python 版本:3.12
PyTorch 版本:2.8.0
模型下载
使用 ModelScope 提供的工具进行高速下载,确保模型文件的完整性。
from modelscope import snapshot_download

# 下载 Kimi-K2.5 模型
model_dir = snapshot_download(
    'moonshotai/Kimi-K2.5',
    cache_dir='./kimi_models',
    revision='master'
)

print(f"模型下载完成,存储路径为: {model_dir}")虚拟环境配置与 SGLang 启动
虚拟环境准备
# 创建并激活环境,明确 python 版本和安装 pip, -y则跳过各种确认
conda create -n sglang python=3.12 pip -y
conda activate sglang

# 更新 pip 版本
python -m pip install --upgrade pipTips:学术加速
在AutoDL中,如果下载源码缓慢,可使用以下加速指令:
开启加速:source /etc/network_turbo
关闭加速:unset http_proxy; unset https_proxy
SGLang 与特定依赖安装
# 源码安装 SGLang
pip install "sglang @ git+https://github.com/sgl-project/sglang.git#subdirectory=python"

# 安装特定的 cudnn 版本以优化性能
pip install nvidia-cudnn-cu12==9.16.0.29启动命令
# 请将 $MODEL_PATH 替换为您实际的文件夹路径
sglang serve --model-path /your/path/to/Kimi-K2.5 --tp 8 --trust-remote-code --tool-call-parser kimi_k2 --reasoning-parser kimi_k2参数详解:
--model-path: 指向含有 config.json 和权重文件(./bin或者./safetensors)的文件夹。
--tp 8: 使用 8 张卡进行张量并行(Tensor Parallelism)。
--trust-remote-code: 信任并执行模型中的自定义代码。
--tool-call-parser kimi_k2: 针对 Kimi 的工具调用功能进行特定解析。
--reasoning-parser kimi_k2: 针对 Kimi 的逻辑推理输出进行特定解析。
启动的一些细节详见附录部分。
调用示例
注意:启动服务的终端需保持开启,请打开一个新的终端运行以下脚本。
- 聊天功能 (chat.py)
场景:适用于短指令、一次性任务,返回完整结果。
import openai

client = openai.Client(
    base_url="http://127.0.0.1:30000/v1",
    api_key="empty"
)

response = client.chat.completions.create(
    model="default",
    messages=[
        {"role": "user", "content": "你好 Kimi,请介绍一下你自己,并确认一下你现在的版本。"}
    ],
    temperature=0.7
)

print(f"Kimi 的回答:\n{response.choices[0].message.content}")Kimi 的回答:
你好!我是 **Kimi**,由 **月之暗面科技有限公司**(Moonshot AI)开发的人工智能助手。
关于我目前的版本:**我现在运行的是 Kimi K2.5**(知识截止于 2025 年 1 月)。
作为一名 AI 助手,我能够:
- **多语言交流**:流利使用中文、英文等多种语言进行对话
- **长文本处理**:支持超长上下文窗口(最高可达 200 万字级别),能够阅读和分析长篇文档、论文、书籍等
- **文件理解**:可以解析 PDF、Word、图片等多种格式的文件内容
- **联网搜索**:获取最新信息(取决于当前功能配置)
- **代码与技术**:协助编程、调试、解释技术概念
- **创意与写作**:帮助撰写文章、润色文本、头脑风暴等
如果你有任何问题、需要分析文档、写代码,或者只是想聊聊天,随时告诉我!今天有什么我可以帮你的吗?
- 流式输出 (stream.py)
场景:适用于长文本生成或交互式对话,提升用户感知速度(打字机效果)。核心区别在于设置 stream=True。
import sys
from openai import OpenAI

client = OpenAI(
    base_url="http://127.0.0.1:30000/v1",
    api_key="empty"
)

def chat_stream(prompt):
    print(f"User: {prompt}")
    print("Kimi: ", end="", flush=True)

    try:
        response = client.chat.completions.create(
            model="default",
            messages=[
                {"role": "system", "content": "你是由月之暗面开发的Kimi2.5,现在运行在高性能的SGLang后端。"},
                {"role": "user", "content": prompt}
            ],
            temperature=0.7,
            stream=True  # 核心参数:开启流式传输
        )

        for chunk in response:
            content = chunk.choices[0].delta.content
            if content is not None:
                print(content, end="", flush=True)

        print("\n" + "-"*30)
    except Exception as e:
        print(f"\n[错误]: {e}")

if __name__ == "__main__":
chat_stream("请详细介绍一下 SGLang 的 RadixAttention 技术及其优势。")User: 请详细介绍一下 SGLang 的 RadixAttention 缓存技术,并分点说明它的优势。
Kimi:
SGLang 的 **RadixAttention** 是一种基于**基数树(Radix Tree)**的 KV 缓存(Key-Value Cache)管理技术,专为高效处理大型语言模型(LLM)推理中的**前缀复用**而设计。它是 SGLang runtime 的核心优化之一,能够自动识别和共享不同请求间相同的 token 序列前缀,从而避免重复计算。
以下是详细的技术解析及其优势:
---
### 一、核心技术原理
#### 1. **基数树(Radix Tree)索引结构**
RadixAttention 将 KV 缓存组织成一棵基数树(压缩前缀树):
- **节点(Node)**:代表一个 token 序列段(通常对应一个固定大小的缓存块,如 16/32/64 个 token)。
- **边(Edge)**:标记为具体的 token ID 序列。
- **叶节点到根节点的路径**:构成完整的 token 序列及其对应的 KV 缓存块。
#### 2. **块级(Block-level)缓存管理**
- 将连续的 KV 缓存划分为固定大小的**物理块**(Physical Blocks)。
- 每个块通过其包含的 token 内容的哈希值在基数树中索引。
- 支持**细粒度共享**:不同请求可以共享树中的部分路径(前缀),而独占后续分支。
#### 3. **自动前缀匹配(Automatic Prefix Matching)**
当新请求到达时:
- 系统遍历基数树,寻找与输入序列**最长的公共前缀**。
- **完全匹配**的节点对应的 KV 缓存块被直接复用("命中")。
- **未匹配部分**触发新的计算,并动态插入树中作为新分支。
#### 4. **动态内存管理**
- **引用计数(Reference Counting)**:跟踪每个缓存块被多少个活跃请求或历史会话引用。
- **LRU 驱逐策略**:当 GPU 内存不足时,自动驱逐最近最少使用的叶节点块,释放内存。
---
### 二、主要优势(分点说明)
#### 1. **显著减少重复计算,提升吞吐量**
- **场景**:多轮对话(历史上下文作为前缀)、批量推理(共享 System Prompt)、Agent 工作流(重复的工具调用模板)。
- **效果**:公共前缀只需计算一次 KV 缓存,后续请求直接复用。实测可将多轮对话的**首 token 延迟(TTFT)降低 5-10 倍**,整体吞吐量提升 2-5 倍。
#### 2. **透明化的自动缓存复用**
- **零配置**:开发者无需手动管理缓存键(cache key)或显式指定哪些部分需要缓存。
- **智能匹配**:自动处理部分匹配、重叠序列,甚至支持非连续前缀的复用(通过树的结构特性)。
#### 3. **高效的内存共享与隔离**
- **写时复制(Copy-on-Write)**:当某个请求需要修改共享前缀后的内容时,系统仅复制必要的块,保持前缀部分的共享状态,避免内存浪费。
- **细粒度隔离**:不同会话的后缀部分独立存储,互不干扰,确保逻辑正确性。
#### 4. **优化长上下文(Long Context)性能**
- 对于超长文档问答或代码仓库级推理,RadixAttention 能缓存文档本身的 KV 表示。
- 当用户针对同一文档提出不同问题时,只需计算问题部分的 KV,文档部分的缓存即时可用,极大缓解长上下文带来的计算压力。
#### 5. **降低 GPU 内存碎片**
- 基于块的分配策略(类似操作系统的分页)减少了动态内存分配产生的碎片。
- 基数树的压缩特性(合并单 child 节点)减少了索引本身的内存开销。
#### 6. **与解码优化协同工作**
- 与 **Continous Batching** 结合:在等待新请求时,已缓存的前缀可立即用于构造新 batch,减少 GPU 空闲时间。
- 与 **Speculative Decoding** 结合:草稿模型和主模型可共享前缀缓存,进一步加速。
---
### 三、典型应用场景
| 场景 | 优化效果 |
|------|---------|
| **多轮对话系统** | 第 N 轮对话直接复用前 N-1 轮的 KV 缓存,仅计算最新一轮的增量。 |
| **批量 API 调用** | 一批请求共享相同的 System Prompt 和工具描述,只需计算一次前缀。 |
| **Agent 工作流** | 重复的 ReAct 模式(Thought -> Action -> Observation)中,固定模板部分被自动缓存。 |
| **代码补全/生成** | 同一文件内的多次补全请求共享文件前缀的 KV 缓存。 |
---
### 四、与类似技术的区别
- **vs. vLLM PagedAttention**:PagedAttention 主要解决**显存碎片化和动态 batching** 问题(通过块表映射虚拟/物理块);而 **RadixAttention 专注于前缀复用和共享**(通过基数树索引)。两者正交,SGLang 实际上也借鉴了分页思想来实现 RadixAttention 的底层存储。
- **vs. 手动 Prompt Cache**:RadixAttention 是自动的、细粒度的(块级),而传统手动缓存通常是整个 prompt 级别的,灵活性低。
总结来说,RadixAttention 通过基数树实现了 KV 缓存的**结构化复用**,在保持完全自动化的同时,显著提升了 LLM 服务在处理交互式、长上下文和批量任务时的效率和响应速度。3.工具调用(use_tool.py)
Kimi 2.5 的工具调用机制(Function Calling)是主要是指其调用其它API的机制。一般情况下,要进行两次API调用:第一次是获取信息,但是并非自然语言查询,而是结构化的工具调用;第二次是将 API 的结果进行总结,给出最终的自然语言的回答。
import openai
import json
import requests

# --- !!! 请在这里替换你的真实 API KEY !!! ---
OPENWEATHERMAP_API_KEY = ""

## 调用API 获取实时天气信息的函数
def get_weather_realtime(location: str, unit: str) -> str:
    units_map = {"celsius": "metric", "fahrenheit": "imperial"}
    url = "http://api.openweathermap.org/data/2.5/weather"
    params = {
        "q": location,
        "appid": OPENWEATHERMAP_API_KEY,
        "units": units_map.get(unit, "metric") # 默认使用摄氏度
    }

    try:
        # 发起请求
        response = requests.get(url, params=params, timeout=5)
        response.raise_for_status()
        data = response.json()

        # 提取关键信息 (API 返回格式)
        if data.get("cod") == 200:
            temp = data["main"]["temp"]
            description = data["weather"][0]["description"]
            city_name = data["name"]

            result = {
                "location": city_name,
                "temperature": f"{temp}",
                "unit": unit,
                "condition": description,
                "source": "OpenWeatherMap"
            }
            # 返回 JSON 字符串给 LLM
            return json.dumps(result, ensure_ascii=False)
        else:
            return json.dumps({"error": f"城市 '{location}' 未找到", "code": data.get("cod")})

    except requests.exceptions.HTTPError as e:
        return json.dumps({"error": f"HTTP错误: {e.response.status_code}. 城市名称可能不正确。", "location": location})
    except requests.exceptions.RequestException as e:
        return json.dumps({"error": "网络连接或超时失败。", "details": str(e), "location": location})
    except Exception as e:
        return json.dumps({"error": "数据解析失败。", "details": str(e), "location": location})


## 初始化 OpenAI 客户端和工具

client = openai.Client(
    base_url="http://127.0.0.1:30000/v1",
    api_key="empty"
)
tool_functions = {"get_weather": get_weather_realtime}

tools = [{
    "type": "function",
    "function": {
        "name": "get_weather",
        "description": "获取一个给定地点的当前实时天气情况,如查询不到则返回错误信息。",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {"type": "string", "description": "城市名,例如:北京, Tokyo, London"},
                "unit": {"type": "string", "enum": ["celsius", "fahrenheit"]}
            },
            "required": ["location", "unit"]
        }
    }
}]

## 第一次 API 调用:Kimi 规划——获得天气信息,但是并非自然语言查询,而是结构化的工具调用
user_query = "What's the weather like in Baoji? use celsius."
response = client.chat.completions.create(
    model="default",
    messages=[{"role": "user", "content": user_query}],
    tools=tools,
    tool_choice="auto"
)

response_message = response.choices[0].message

tool_call = response_message.tool_calls[0].function
function_name = tool_call.name
arguments_str = tool_call.arguments
print(f"Kimi 规划: 函数 {function_name}, 参数 {arguments_str}")

args_dict = json.loads(arguments_str)
real_result_str = tool_functions[function_name](**args_dict)
print(f"API 真实返回结果: {real_result_str}")

## 第二次 API 调用:Kimi 总结——将 API 的结果进行总结,给出最终的自然语言的回答
messages = [
    {"role": "user", "content": user_query},
    response_message,
    {
        "tool_call_id": response_message.tool_calls[0].id,
        "role": "tool",
        "name": function_name,
        "content": real_result_str,
    }
]

final_response = client.chat.completions.create(
    model="default",
    messages=messages
)

final_answer = final_response.choices[0].message.content
print("\n✅ Kimi 的最终回答:\n", final_answer)Kimi 规划: 函数 get_weather, 参数 {"location": "Baoji", "unit": "celsius"}
API 真实返回结果: {"location": "Baoji", "temperature": "-0.67", "unit": "celsius", "condition": "overcast clouds", "source": "OpenWeatherMap"}
✅ Kimi 的最终回答:
In Baoji (宝鸡), it's currently **-0.7°C** with **overcast clouds**.
That's right around freezing, so it's quite chilly! Make sure to bundle up if you're heading out.附录(加载与资源占用说明)
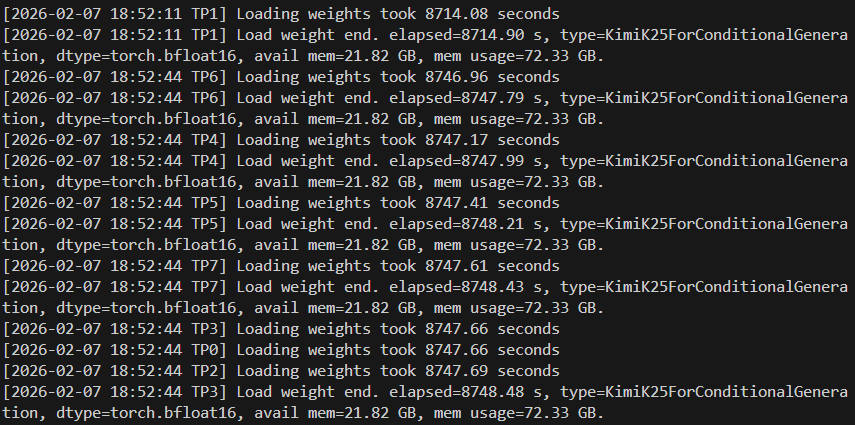
启动耗时分析
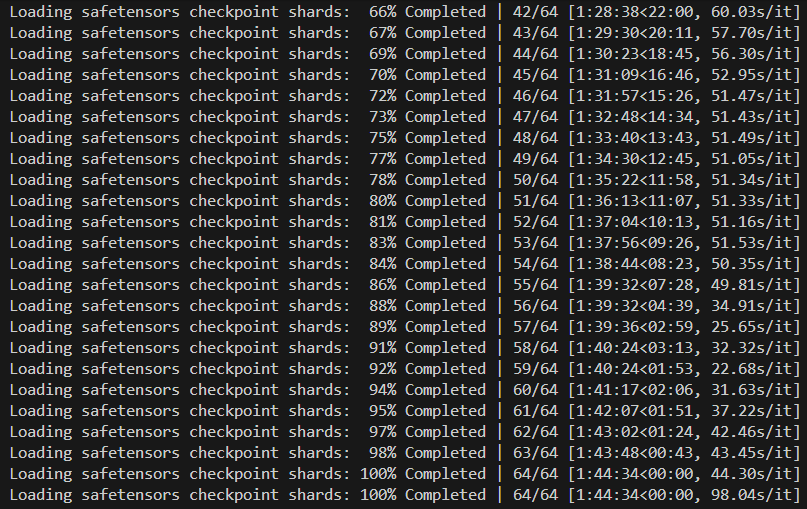
加载阶段:单纯从磁盘读取模型权重耗时约 1小时45分钟,整体权重读取还是比较耗时的。
初始化阶段:权重加载完后,终端会有较长时间(数十分钟)无日志输出。此时系统正在进行多卡间的 P2P 通信、张量切分以及 MoE(混合专家模型)专家的排列。
总时长:实测总启动时间为 8714秒(约2小时25分钟)。
显存占用情况
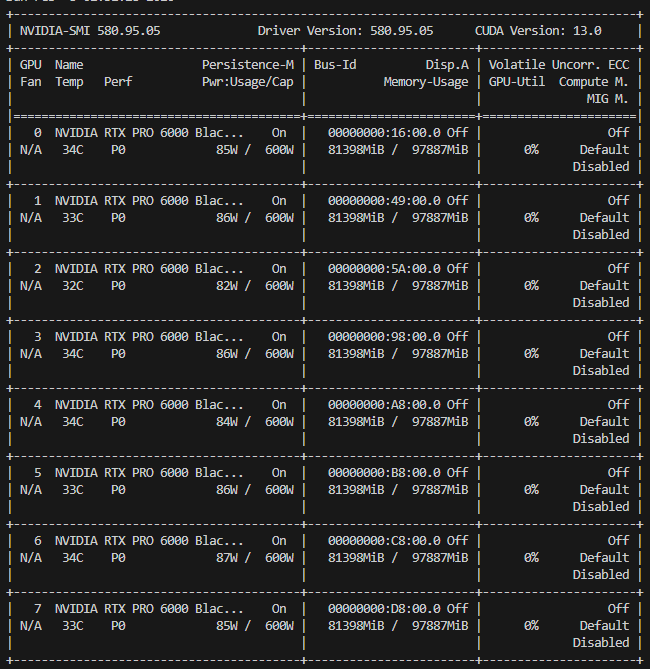
SGLang 报告 (mem_usage):约 72.33G / 卡。这是模型权重和必要缓冲区的实际占用。
nvidia-smi 报告:约 81.4G / 卡。这是由于 SGLang 预先分配了静态图和巨大的 KV Cache 显存池 以保证极致性能。
部署成功验证
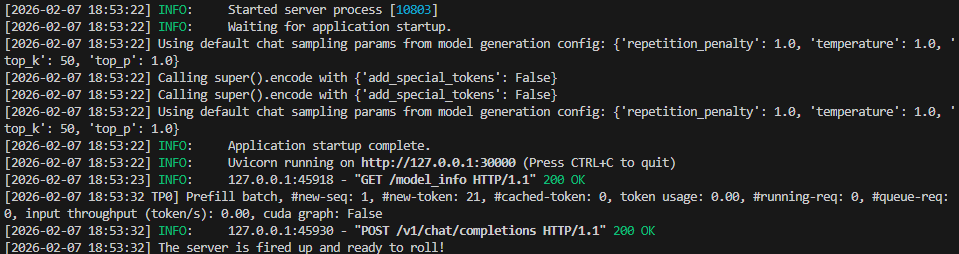
当您在终端看到类似 HTTP 200 响应及 API 成功被调用的日志时,即表示 Kimi 2.5 部署成功。