01-GPT-OSS-20b vLLM 部署调用
引言
看完本教程你将收获: - 通过transformer在本地部署调用gpt-oss的能力! - 使用vLLM部署调用gpt-oss的能力!
GPT-OSS 是 OpenAI 推出的开源大语言模型系列,包含两个版本:gpt-oss-120b 和 gpt-oss-20b。这两个模型均采用 MoE(Mixture-of-Experts)Transformer 架构,支持 128K 的上下文长度,并采用 Apache 2.0 许可协议,允许自由使用和商业应用。GPT-OSS-120B 模型在核心推理基准测试中与 OpenAI o4-mini 模型几乎持平,同时能在单个 80GB GPU 上高效运行。GPT-OSS-20B 模型在常见基准测试中与 OpenAI o3‑mini 模型取得类似结果,且可在仅配备 16GB 内存的边缘设备上运行,使其成为设备端应用、本地推理或无需昂贵基础设施的快速迭代的理想选择。这两个模型在工具使用、少样本函数调用、CoT推理(如在 Tau-Bench 智能体评估套件中的结果所示)以及 HealthBench 测试中表现强劲(甚至超越了 OpenAI o1 和 GPT‑4o 等专有模型)。 vLLM 支持以下两种规模的gpt-oss:
openai/gpt-oss-20b
较小的模型
仅需约 16GB 显存
可在消费级显卡如A100或H20上运行
openai/gpt-oss-120b
更大的全尺寸模型
显存≥60GB时效果最佳
可在单张H100或多GPU设置上运行
环境准备
配置环境比较头疼,我们为同学们准备了镜像:
⚠️注意:由于支持gpt-oss模型的vLLM 0.10.1版本还未正式发布(2025.8.6),需要从源码安装vLLM和gpt-oss的依赖。推荐启动一个新的python 3.12环境,避免对现有环境造成影响。
⚠️注意: vllm-gpt-oss的很多依赖均为最新,如果不是最新配置环境会出问题!!! 如需升级conda,升级cuda命令
conda search cuda-toolkit --channel nvidia
conda install cuda-toolkit=<新版本号> --channel nvidia
nvcc --version #查看是否升级成功

export CUDA_HOME=$CONDA_PREFIX
export LD_LIBRARY_PATH=$CONDA_PREFIX/lib:$LD_LIBRARY_PATH #在conda升级后需设置一下路径本文的试验基础环境如下:
PyTorch 2.9.0 Python 3.12(ubuntu22.04) CUDA 12.8 GPU NVIDIA H20-96GB * 1
克隆代码仓
git clone https://github.com/huggingface/gpt-oss-recipes.git
cd gpt-oss-recipespip换源加速,下载并安装依赖包
conda create -n gpt_oss_vllm python=3.12
conda activate gpt_oss_vllm

python -m pip install --upgrade pip
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple

export HF_ENDPOINT="https://hf-mirror.com"
pip install -U huggingface_hubgpt-oss依赖
pip install -U transformers kernels torch accelerate模型下载
模型可以从Hugging Face和ModelScope仓库获取。可以显式下载,也可以在首次使用时执行仓库代码自动下载。
Hugging Face CLI
huggingface-cli download openai/gpt-oss-20b --local-dir gpt-oss-20bps:记得修改对应的 cache_dir / local_dir为你的模型下载路径哦~
transformers 调用方式
通过脚本调用
使用transformers库作为推理的改写交互脚本进行调用测试
from transformers import pipeline
import torch

model_id = "openai/gpt-oss-20b"

pipe = pipeline(
    "text-generation",
    model=model_id,
    torch_dtype="auto",
    device_map="auto",
)

messages = [
    {"role": "user", "content": "Explain quantum mechanics clearly and concisely."},
]

outputs = pipe(
    messages,
    max_new_tokens=256,
)
print(outputs[0]["generated_text"][-1])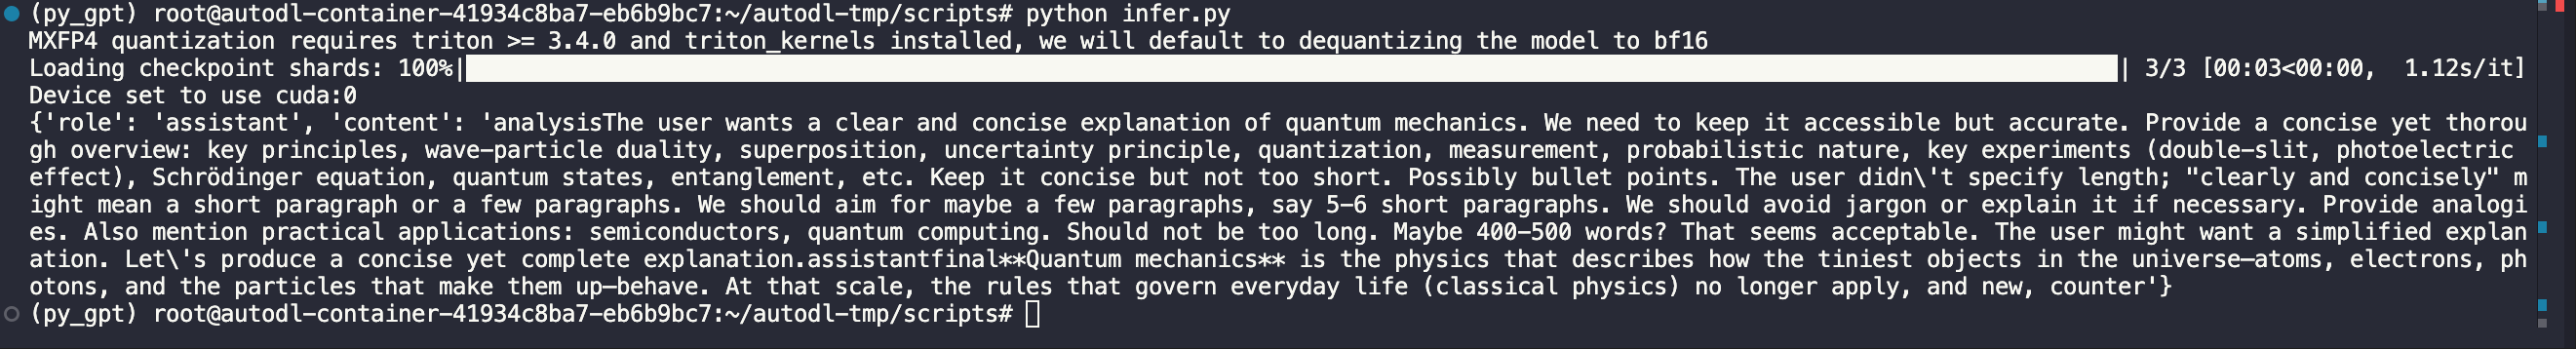
通过服务调用
transformers serve
transformers chat localhost:8000 --model-name-or-path openai/gpt-oss-20bps:记得修改为你的模型下载路径哦~
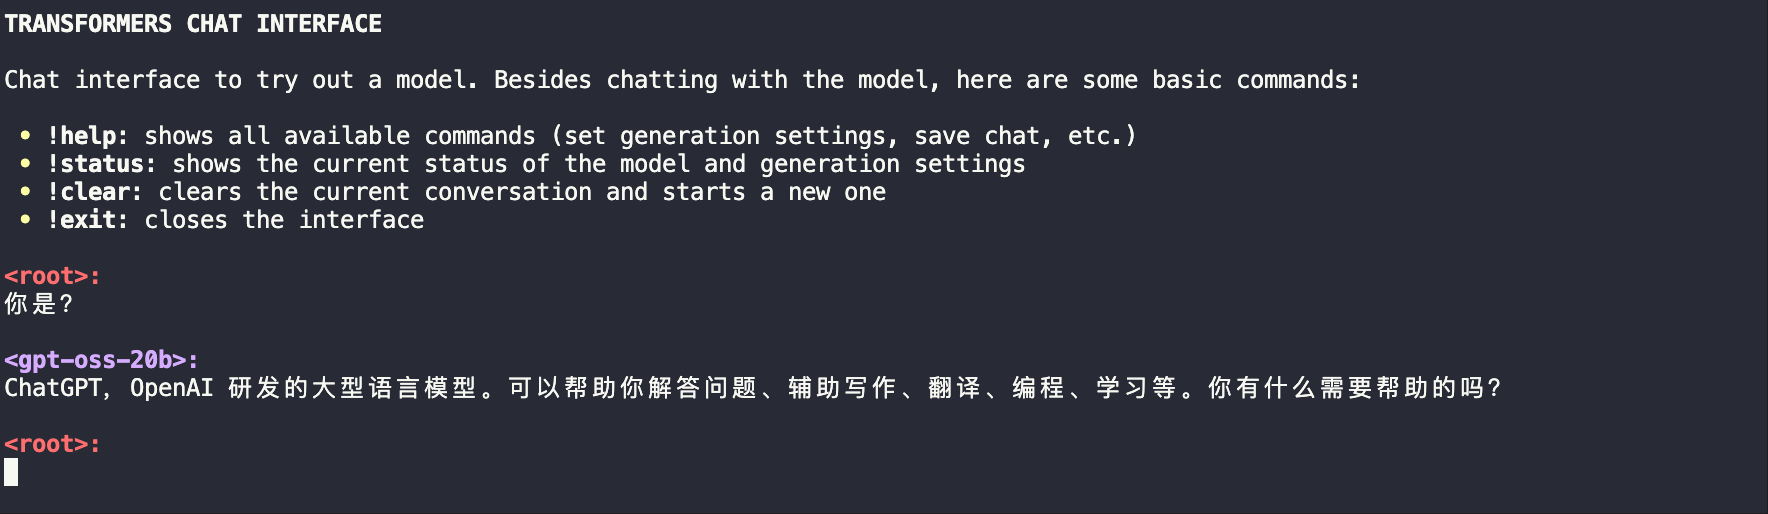
调整生成参数
可以通过系统提示调整推理的详细程度。例如,设置高推理级别:
messages = [
    {"role": "system", "content": "Reasoning: high"},
    {"role": "user", "content": "解释量子计算的基本原理"}
]vLLM 调用代码准备
vLLM环境配置
注意:vLLM版本之间兼容性很差,注意识别
pip install --pre vllm==0.10.1+gptoss \
    --extra-index-url https://wheels.vllm.ai/gpt-oss/ \
    --extra-index-url https://download.pytorch.org/whl/nightly/cu128

# !!!安装 FlashInfer!!!
pip install flashinfer-python==0.2.10启动服务器并下载模型
vLLM 提供了一个命令,该命令将自动从 HuggingFace 下载模型并在 上启动与 OpenAI 兼容的服务器。 根据服务器上的终端会话中所需的模型大小运行以下命令。
# For 20B 可以替换成本地下载的目录
vllm serve openai/gpt-oss-20b

# For 120B 可以替换成本地下载的目录
vllm serve openai/gpt-oss-120b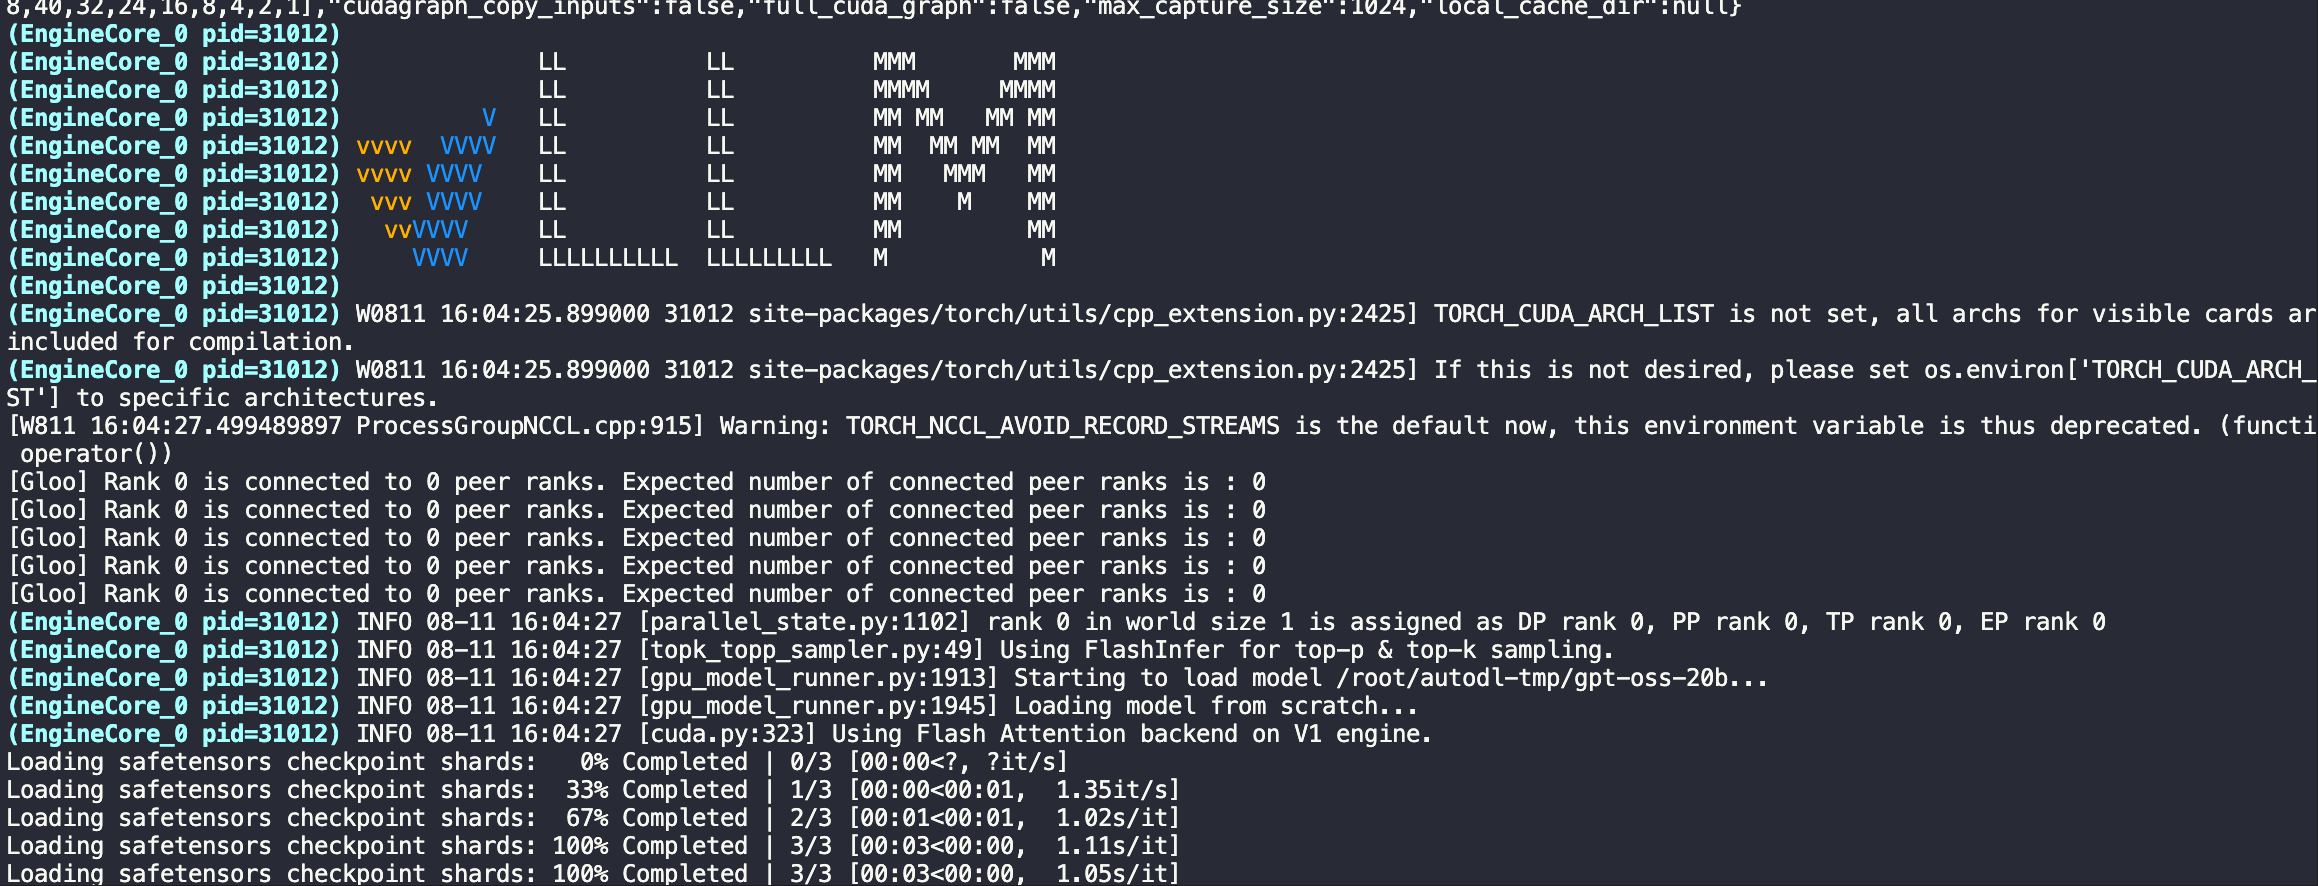
测试
VLLM_ATTENTION_BACKEND=TRITON_ATTN_VLLM_V1 vllm serve openai/gpt-oss-20b --served-model-name gpt-oss-20b --trust_remote_code --port 8801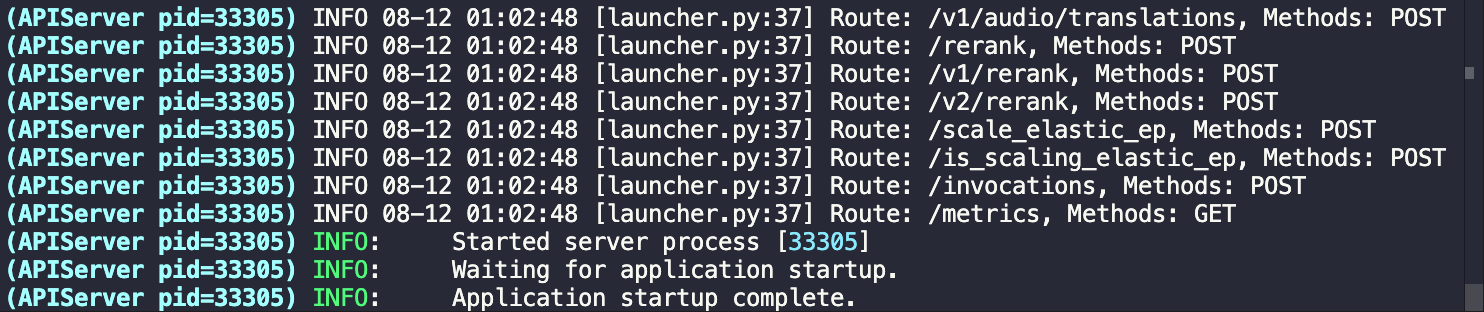
参考链接
在线体验网址:https://gpt-oss.com/
Huggingface:https://huggingface.co/openai/gpt-oss-120b
vLLM官方gpt-oss文档:https://docs.vllm.ai/projects/recipes/en/latest/OpenAI/GPT-OSS.html#gpt-oss-vllm-usage-guide
02-gpt-oss-20b EvalScope 评测
大模型评测是什么
大语言模型评测是指对大语言模型(LLM)在多种任务和场景下的性能进行全面评估的过程。评测的目的是衡量模型的通用能力、特定领域表现、效率、鲁棒性、安全性等多方面性能,以便优化模型设计、指导技术选型和推动模型在实际应用中的部署。 评测的主要内容包括以下几个方面:
通用能力:评估模型在语言理解、生成、推理等方面的基础能力。
特定领域表现:针对特定任务(如数学推理、代码生成、情感分析等)的性能评估。
效率与资源消耗:包括模型的训练和推理时间、计算资源需求等。
鲁棒性与可靠性:评估模型在面对噪声、对抗攻击或输入扰动时的稳定性。
伦理与安全性:检测模型是否会产生有害内容、是否存在偏见或歧视。
EvalScope 是魔搭社区官方推出的模型评测与性能基准测试框架,内置多个常用测试基准和评测指标,如 MMLU、CMMLU、C-Eval、GSM8K、ARC、HellaSwag、TruthfulQA、MATH 和 HumanEval 等;支持多种类型的模型评测,包括 LLM、多模态 LLM、embedding 模型和 reranker 模型。EvalScope 还适用于多种评测场景,如端到端 RAG 评测、竞技场模式和模型推理性能压测等。此外,通过 ms-swift 训练框架的无缝集成,可一键发起评测,实现了模型训练到评测的全链路支持。 官网地址:https://evalscope.readthedocs.io/zh-cn/latest/get_started
EvalScope 评测使用方法
为了更方便的使用模型,并提升推理速度,我们使用 vLLM 启动一个与 OpenAI 格式兼容的 Web 服务。
创建并激活新的conda环境:
conda create -n gpt_oss_vllm python=3.12
conda activate gpt_oss_vllm安装相关依赖:
# 安装 PyTorch-nightly 和 vLLM
pip install --pre vllm==0.10.1+gptoss \
            --extra-index-url https://wheels.vllm.ai/gpt-oss/ \
            --extra-index-url https://download.pytorch.org/whl/nightly/cu128
# 安装 FlashInfer
pip install flashinfer-python==0.2.10
# 安装 evalscope
pip install evalscope[perf] -U启动模型服务
我们在 H20 GPU上成功启动gpt-oss-20b模型服务
VLLM_ATTENTION_BACKEND=TRITON_ATTN_VLLM_V1 vllm serve openai/gpt-oss-20b --served-model-name gpt-oss-20b --trust_remote_code --port 8801推理速度测试
我们使用EvalScope的推理速度测试功能,来评测模型的推理速度。
测试环境:
显卡: H20-96GB * 1
vLLM版本: 0.10.1 + gptoss
prompt 长度: 1024 tokens
输出长度: 1024 tokens
evalscope perf \
    --parallel 1 10 50 100 \
    --number 5 20 100 200 \
    --model gpt-oss-20b \
    --url http://127.0.0.1:8801/v1/completions \
    --api openai \
    --dataset random \
    --max-tokens 1024 \
    --min-tokens 1024 \
    --prefix-length 0 \
    --min-prompt-length 1024 \
    --max-prompt-length 1024 \
    --log-every-n-query 20 \
    --tokenizer-path openai-mirror/gpt-oss-20b \
--extra-args '{"ignore_eos": true}'╭──────────────────────────────────────────────────────────╮
│ Performance Test Summary Report │
╰──────────────────────────────────────────────────────────╯
Basic Information:
┌───────────────────────┬──────────────────────────────────┐
│ Model │ gpt-oss-20b │
│ Total Generated │ 332,800.0 tokens │
│ Total Test Time │ 154.57 seconds │
│ Avg Output Rate │ 2153.10 tokens/sec │
└───────────────────────┴──────────────────────────────────┘
Detailed Performance Metrics
┏━━━━━━┳━━━━━━┳━━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━━━┳━━━━━━━━━┳━━━━━━━━━━┓
┃ ┃ ┃ Avg ┃ P99 ┃ Gen. ┃ Avg ┃ P99 ┃ Avg ┃ P99 ┃ Success┃
┃Conc. ┃ RPS ┃ Lat.(s) ┃ Lat.(s) ┃ toks/s ┃ TTFT(s) ┃ TTFT(s) ┃ TPOT(s) ┃ TPOT(s) ┃ Rate┃
┡━━━━━━╇━━━━━━╇━━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━━━╇━━━━━━━━━╇━━━━━━━━━━┩
│ 1 │ 0.15 │ 6.811 │ 6.854 │ 150.34 │ 0.094 │ 0.096 │ 0.007 │ 0.007 │ 100.0%│
│ 10 │ 0.96 │ 10.374 │ 10.708 │ 986.63 │ 0.865 │ 1.278 │ 0.009 │ 0.010 │ 100.0%│
│ 50 │ 2.47 │ 20.222 │ 22.612 │ 2529.14 │ 2.051 │ 5.446 │ 0.018 │ 0.020 │ 100.0%│
│ 100 │ 3.37 │ 29.570 │ 35.594 │ 3455.61 │ 2.354 │ 6.936 │ 0.027 │ 0.028 │ 100.0%│
└──────┴──────┴──────────┴──────────┴─────────┴──────────┴─────────┴──────────┴─────────┴──────────┘
Best Performance Configuration
Highest RPS Concurrency 100 (3.37 req/sec)
Lowest Latency Concurrency 1 (6.811 seconds)
Performance Recommendations:
• The system seems not to have reached its performance bottleneck, try higher concurrency基准测试
我们使用 EvalScope 的基准测试功能,来评测模型的能力。 这里我们以 AIME2025 这个数学推理基准测试为例,测试模型的能力。
运行测试脚本:
from evalscope.constants import EvalType
from evalscope import TaskConfig, run_task
task_cfg = TaskConfig(
    model='gpt-oss-20b',  # 模型名称
    api_url='http://127.0.0.1:8801/v1',  # 模型服务地址
    eval_type=EvalType.SERVICE, # 评测类型,这里使用服务评测
    datasets=['aime25'],  # 测试的数据集
    generation_config={
    'extra_body': {"reasoning_effort": "high"}  # 模型生成参数,这里设置为高推理水平
    },    eval_batch_size=10, # 并发测试的batch size
    timeout=60000, # 超时时间,单位为秒
    )
run_task(task_cfg=task_cfg)输出如下:这里测试结果为0.8,大家可以尝试不同的模型生成参数,多次测试,查看结果。
+-------------+-----------+---------------+-------------+-------+---------+---------+
| Model       | Dataset   | Metric        | Subset      |   Num |   Score | Cat.0   |
+=============+===========+===============+=============+=======+=========+=========+
| gpt-oss-20b | aime25    | AveragePass@1 | AIME2025-I  |    15 |     0.8 | default |
+-------------+-----------+---------------+-------------+-------+---------+---------+
| gpt-oss-20b | aime25    | AveragePass@1 | AIME2025-II |    15 |     0.8 | default |
+-------------+-----------+---------------+-------------+-------+---------+---------+
| gpt-oss-20b | aime25    | AveragePass@1 | OVERALL     |    30 |     0.8 | -       |
+-------------+-----------+---------------+-------------+-------+---------+---------+ 并发测试
MODEL="gpt-oss-20b"
NUMBER=100
PARALLEL=20

evalscope perf \
    --url "http://localhost:8801/v1/chat/completions" \
    --parallel ${PARALLEL} \
    --model ${MODEL} \
    --number ${NUMBER} \
    --api openai \
    --dataset openqa \
    --stream \
    --swanlab-api-key 'your-swanlab-api-key' \
--name "${MODEL}-number${NUMBER}-parallel${PARALLEL}"--url:指定模型服务的 API 接口地址,这里是本地部署的 vLLM 服务地址。
--parallel:指定并发请求的线程数,这里设置为 2 个线程。
--model:指定要评测的模型名称,这里是 gpt-oss-20b。
--number:指定每个线程要发送的请求数量,这里设置为 100 个请求。
--api:指定评测使用的 API 类型,这里是 openai。
--dataset:指定评测使用的数据集,这里是 openqa。
--stream:指定是否使用流式输出,这里设置为 true。
--swanlab-api-key:指定 swanlab 的 API 密钥,这里需要替换为实际的 API 密钥。
--name:指定评测任务的名称,这里是 gpt-oss-20b-number100-parallel5。
Benchmarking summary:
+-----------------------------------+-----------+
| Key                               |     Value |
+===================================+===========+
| Time taken for tests (s)          |  289      |
+-----------------------------------+-----------+
| Number of concurrency             |    5      |
+-----------------------------------+-----------+
| Total requests                    |  100      |
+-----------------------------------+-----------+
| Succeed requests                  |  100      |
+-----------------------------------+-----------+
| Failed requests                   |    0      |
+-----------------------------------+-----------+
| Output token throughput (tok/s)   |  514.391  |
+-----------------------------------+-----------+
| Total token throughput (tok/s)    |  547.177  |
+-----------------------------------+-----------+
| Request throughput (req/s)        |    0.346  |
+-----------------------------------+-----------+
| Average latency (s)               |   14.1385 |
+-----------------------------------+-----------+
| Average time to first token (s)   |    0.0413 |
+-----------------------------------+-----------+
| Average time per output token (s) |    0.0095 |
+-----------------------------------+-----------+
| Average inter-token latency (s)   |    0.0095 |
+-----------------------------------+-----------+
| Average input tokens per request  |   94.75   |
+-----------------------------------+-----------+
| Average output tokens per request | 1486.59   |
+-----------------------------------+-----------+
2025-08-12 01:12:44,012 - evalscope - INFO -
Percentile results:
+-------------+----------+---------+----------+-------------+--------------+---------------+----------------+---------------+
| Percentiles | TTFT (s) | ITL (s) | TPOT (s) | Latency (s) | Input tokens | Output tokens | Output (tok/s) | Total (tok/s) |
+-------------+----------+---------+----------+-------------+--------------+---------------+----------------+---------------+
|     10%     |  0.0171  | 0.0093  |  0.0094  |   2.0817    |      84      |      221      |    104.1461    |   109.3644    |
|     25%     |  0.0178  | 0.0093  |  0.0094  |   9.2178    |      87      |      960      |    105.2331    |   110.6657    |
|     50%     |  0.0191  | 0.0094  |  0.0094  |   19.256    |      94      |     2048      |    105.7487    |   111.2425    |
|     66%     |  0.0245  | 0.0095  |  0.0095  |   19.3416   |      98      |     2048      |    105.8855    |   113.9922    |
|     75%     |  0.0252  | 0.0095  |  0.0095  |   19.3696   |     100      |     2048      |    106.062     |    116.157    |
|     80%     |  0.0262  | 0.0095  |  0.0095  |   19.3809   |     104      |     2048      |    106.1607    |   121.9178    |
|     90%     |  0.0277  | 0.0097  |  0.0096  |   19.4948   |     107      |     2048      |    106.2971    |   152.2758    |
|     95%     |  0.0323  | 0.0099  |  0.0099  |   19.8081   |     109      |     2048      |    106.3563    |   178.6802    |
|     98%     |  0.5273  | 0.0102  |   0.01   |   20.7537   |     111      |     2048      |    106.4233    |   210.0931    |
|     99%     |  0.5283  | 0.0108  |  0.0101  |   20.7543   |     114      |     2048      |    107.4007    |   211.7394    |
+-------------+----------+---------+----------+-------------+--------------+---------------+----------------+---------------+03-gpt-oss-20b lmstudio 本地部署调用
引言
看完本教程你将收获: - 通过lmstudio部署gpt-oss-20b并应用MCP
在本地运行大型语言模型(LLMs)已成为许多开发者和爱好者的热门选择,它提供了隐私性、定制化和离线使用的可能性。虽然像 Ollama 这样的工具提供了强大的命令行界面来管理和运行本地模型,但 LM Studio 则为寻求更图形化、更直观交互体验的用户提供了一个极具吸引力的替代方案。 相比于 Ollama,LM Studio 拥有更加丰富的用户界面,同样强大的模型生态系统支持,以及更易于上手的交互体验。其突出的优势之一在于它非常适合在无网络环境下部署和使用大模型,使其成为一个出色的本地 LLM 应用产品。 本教程将带您一步步了解如何开始使用 LM Studio。我们将涵盖:
下载与安装:快速获取并安装 LM Studio 应用程序。
模型下载(在线):学习如何在 LM Studio 界面内搜索、选择(根据硬件推荐)并下载模型,以 gpt-oss-20b 为例。
模型安装(离线):针对网络不佳或希望手动管理模型文件的用户,展示如何从魔搭社区等来源下载模型文件,并将其正确放置到 LM Studio 的模型库中。
模型测试:通过 LM Studio 内建的聊天界面与下载好的 gpt-oss-20b 模型进行交互。
本地 API 调用:设置 LM Studio 的本地服务器,并使用 Python 和 OpenAI 库通过 API 调用已加载的 gpt-oss-20b模型,实现程序化交互。
如何调用MCP让模型大展身手!
无论您是想探索本地 LLM 的新手,还是在寻找一个界面友好、支持离线运行的工具,本指南都将帮助您轻松上手 LM Studio,并成功部署和调用 gpt-oss-20b 这样强大的模型。让我们开始吧!
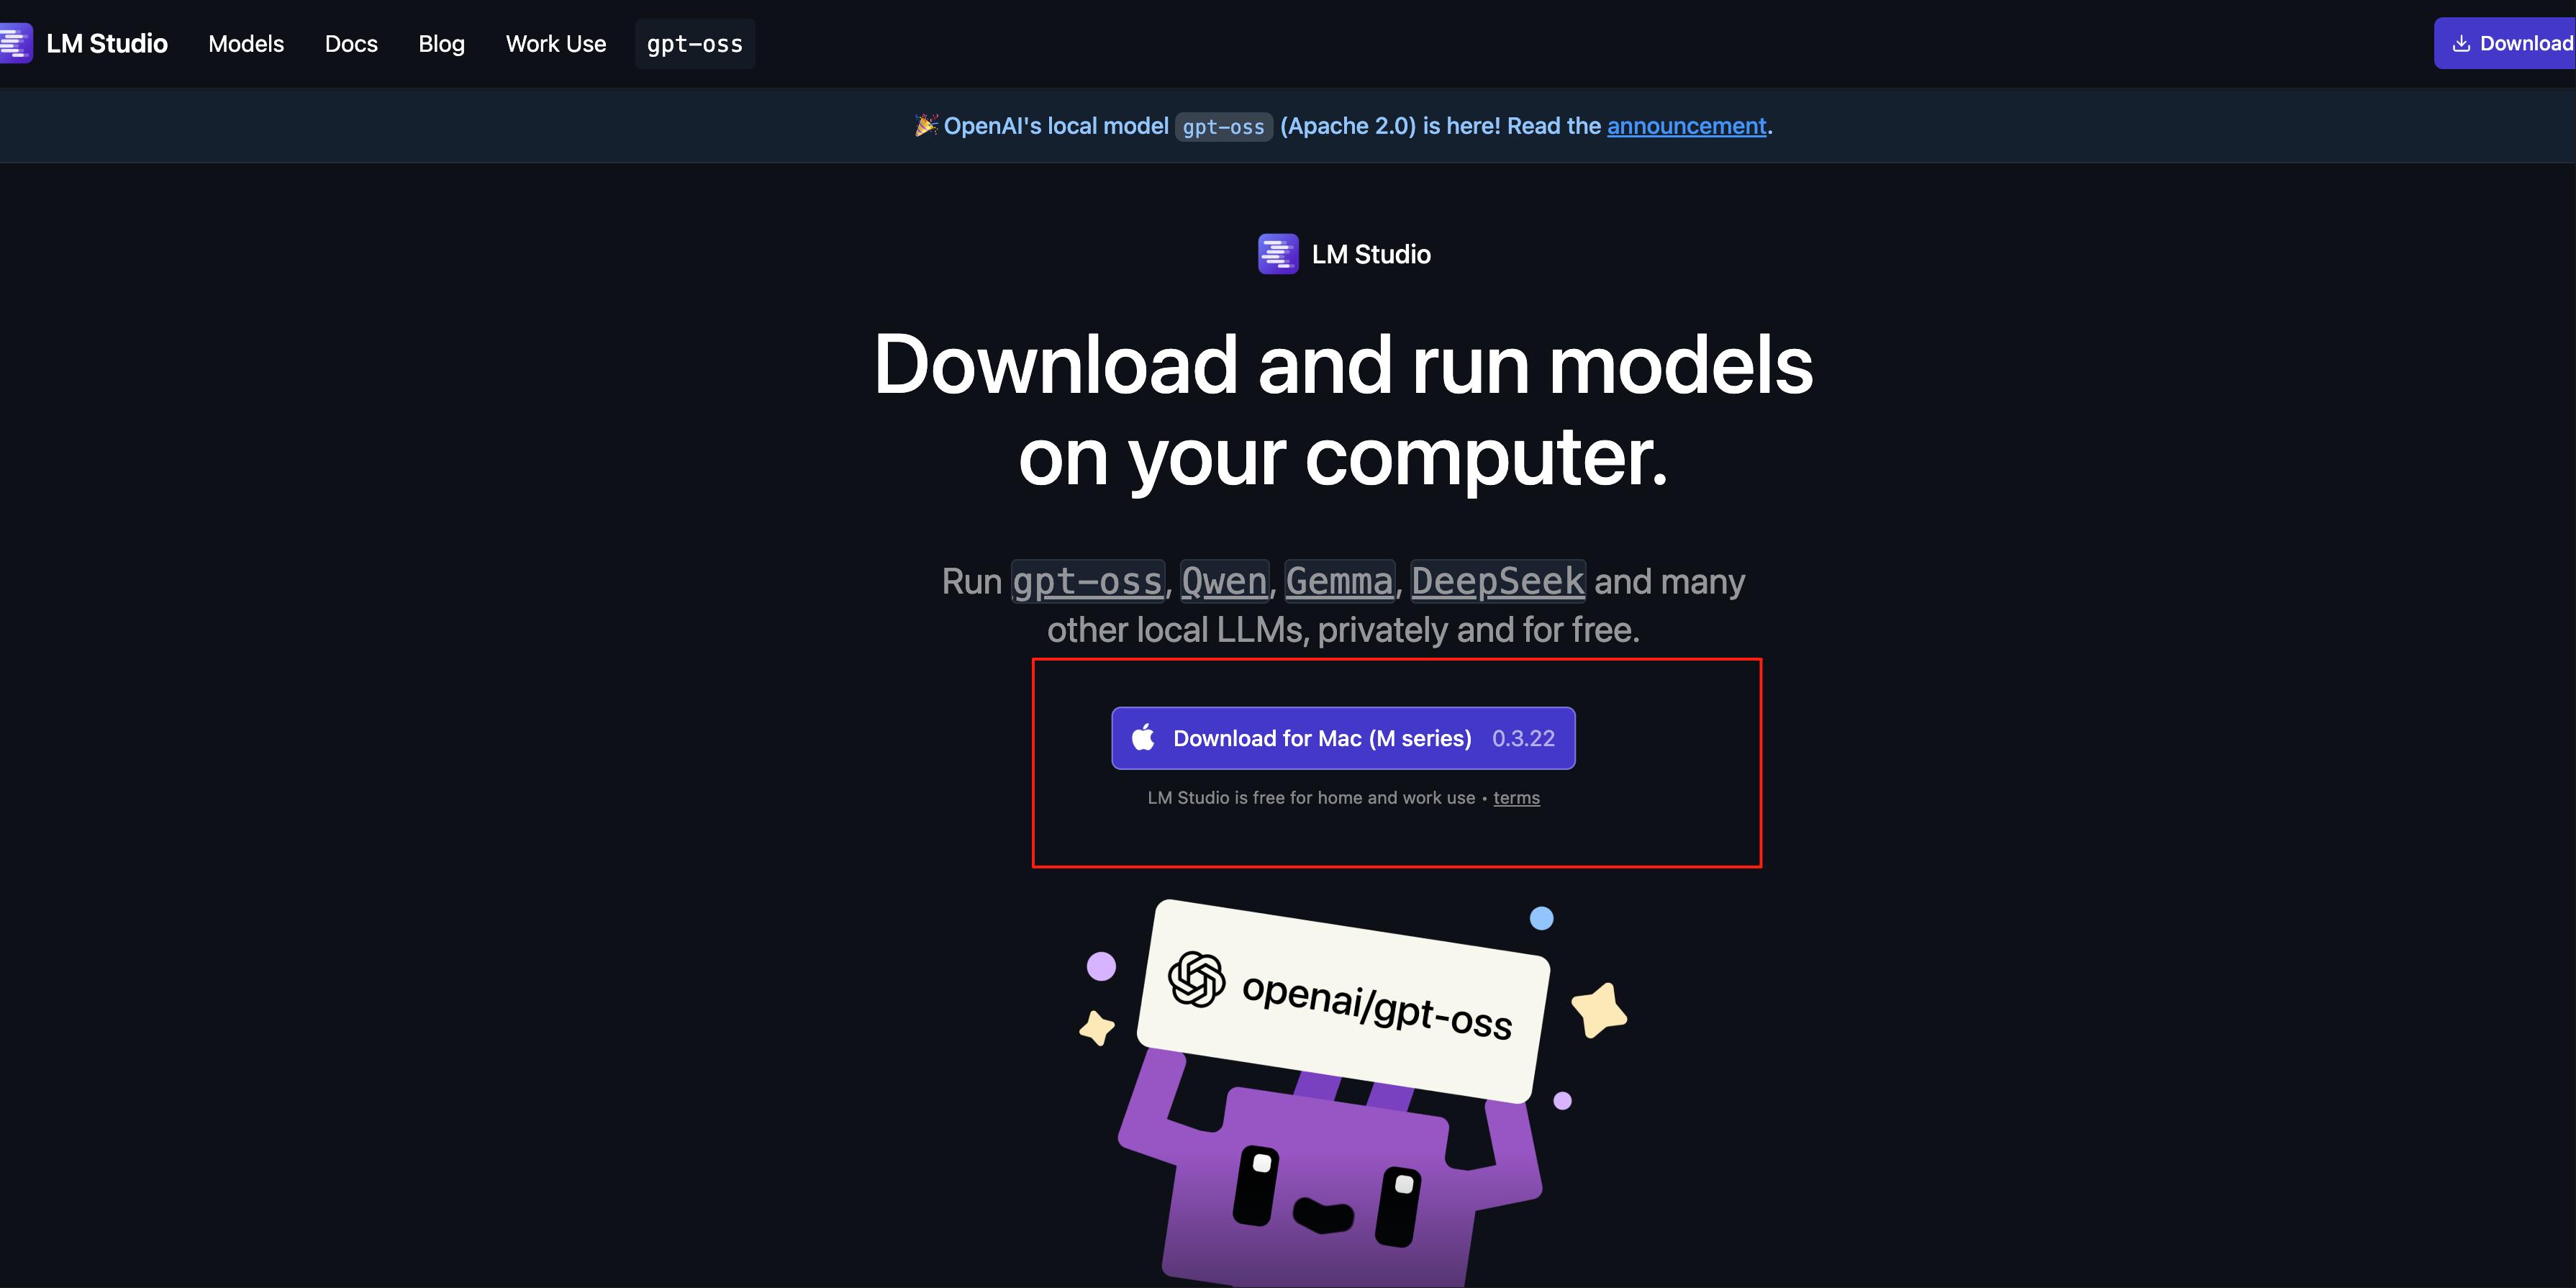
安装Imstudio
选择适合你的系统进行下载~
模型下载
在 LM Studio 中加载模型 → 打开 LM Studio,使用模型加载界面加载下载的 gpt-oss 模型。
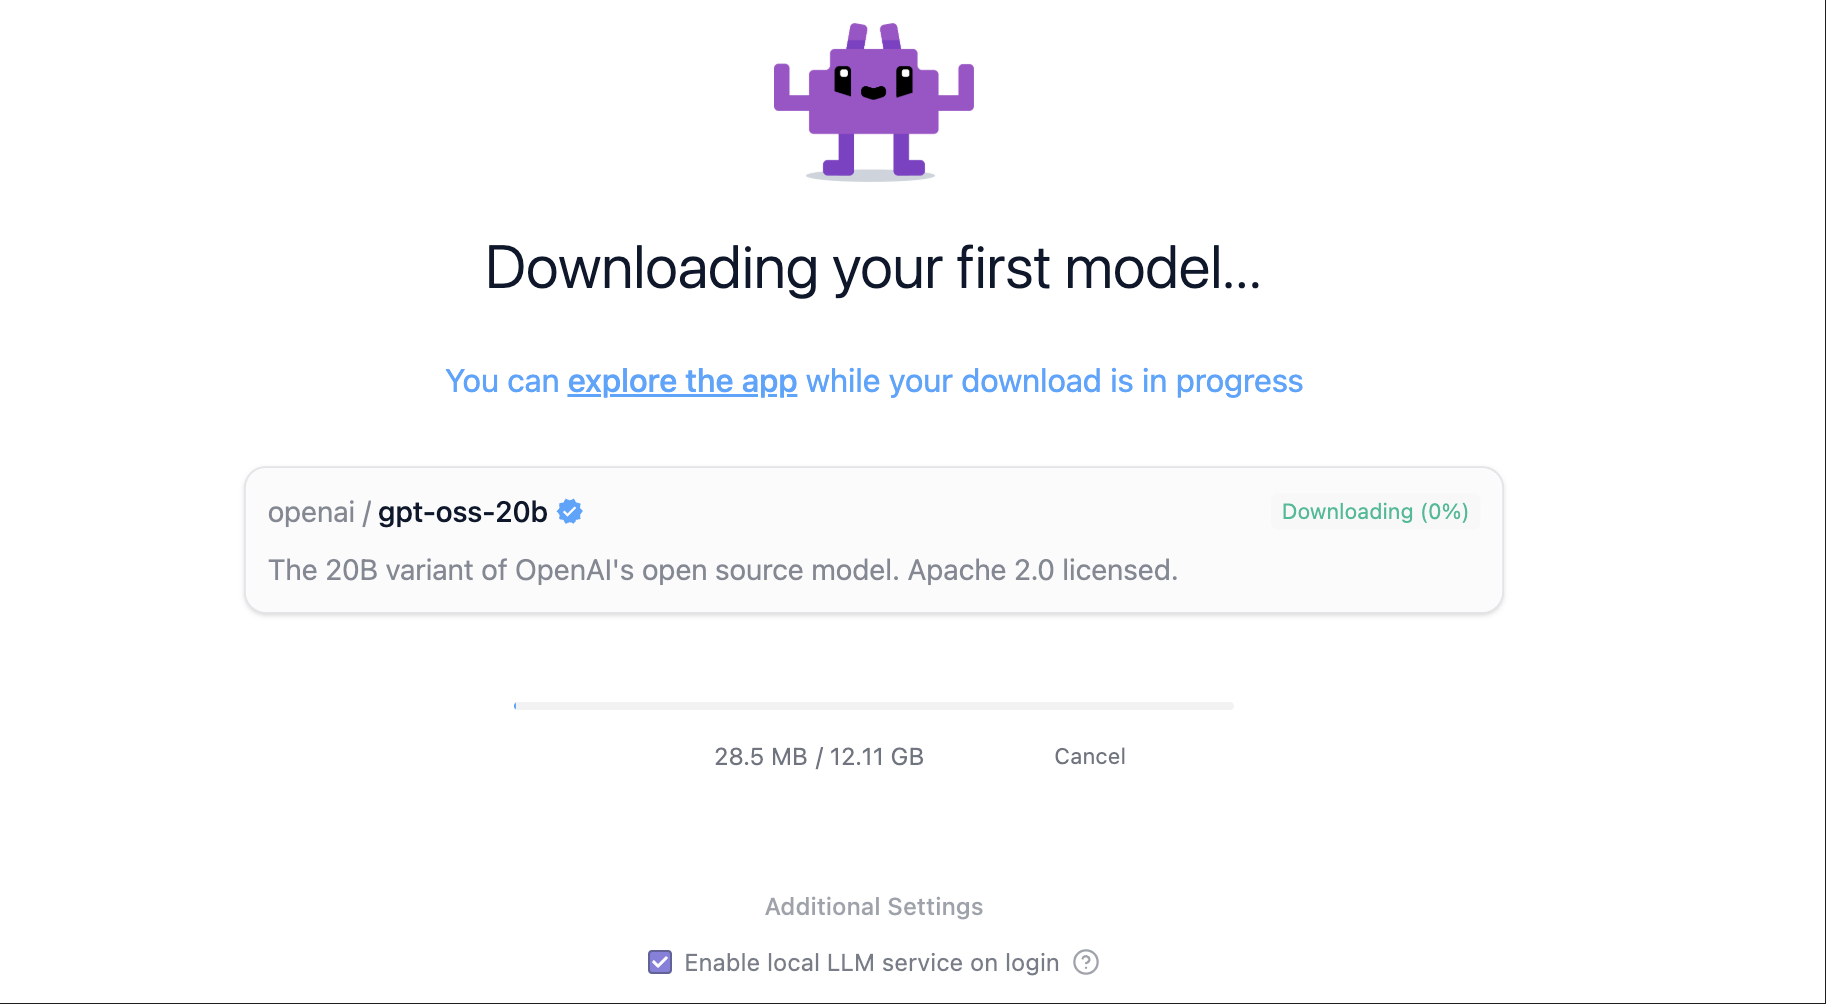
或者,您可以使用命令行(苹果用户是终端)运行:
# For 20B
lms get openai/gpt-oss-20b
# or for 120B
lms get openai/gpt-oss-120b运行模型
使用模型 →加载后,您可以直接在 LM Studio 的聊天界面或通过 API 与模型进行交互。
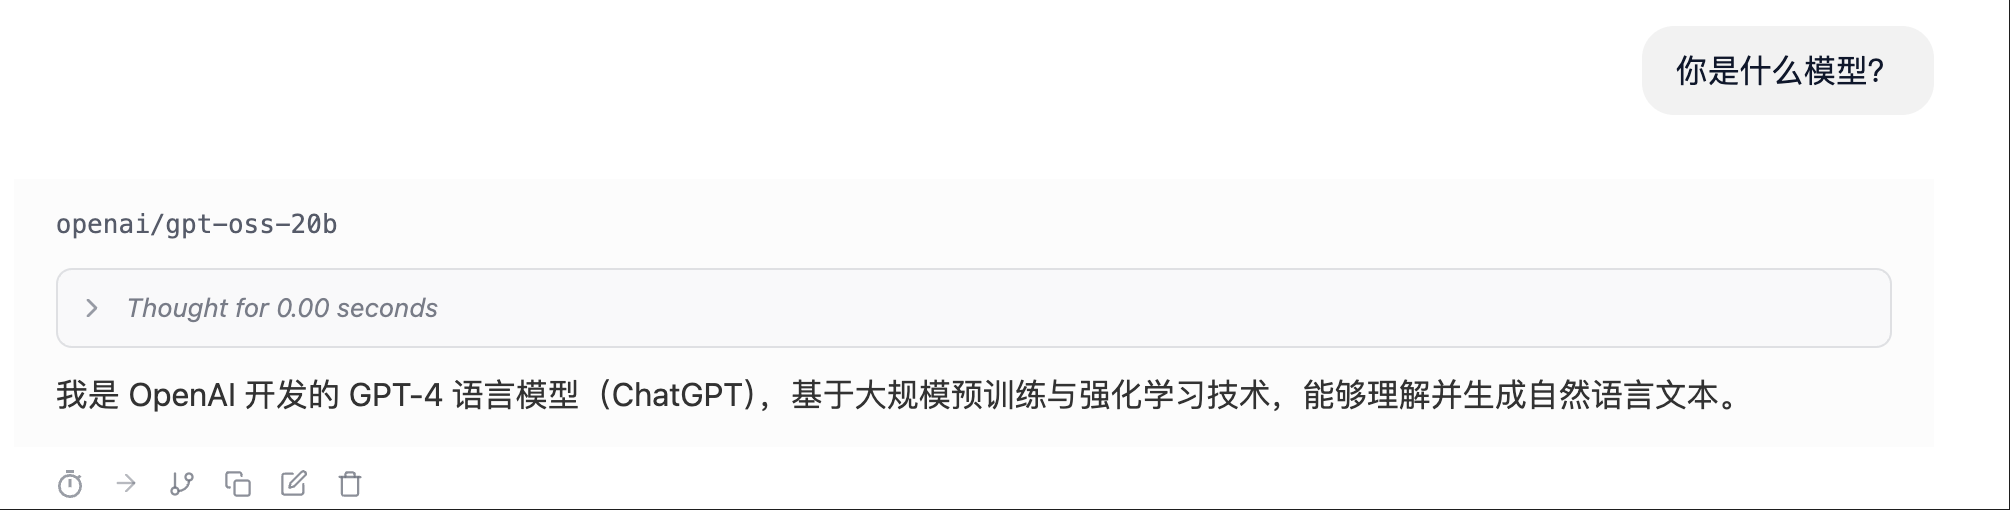
在终端 or lmstudio页面与gpt-oss聊天
lms chat openai/gpt-oss-20b #注意第一次运行之后才能使用lmx命令在python脚本中调用本地部署的gpt-oss
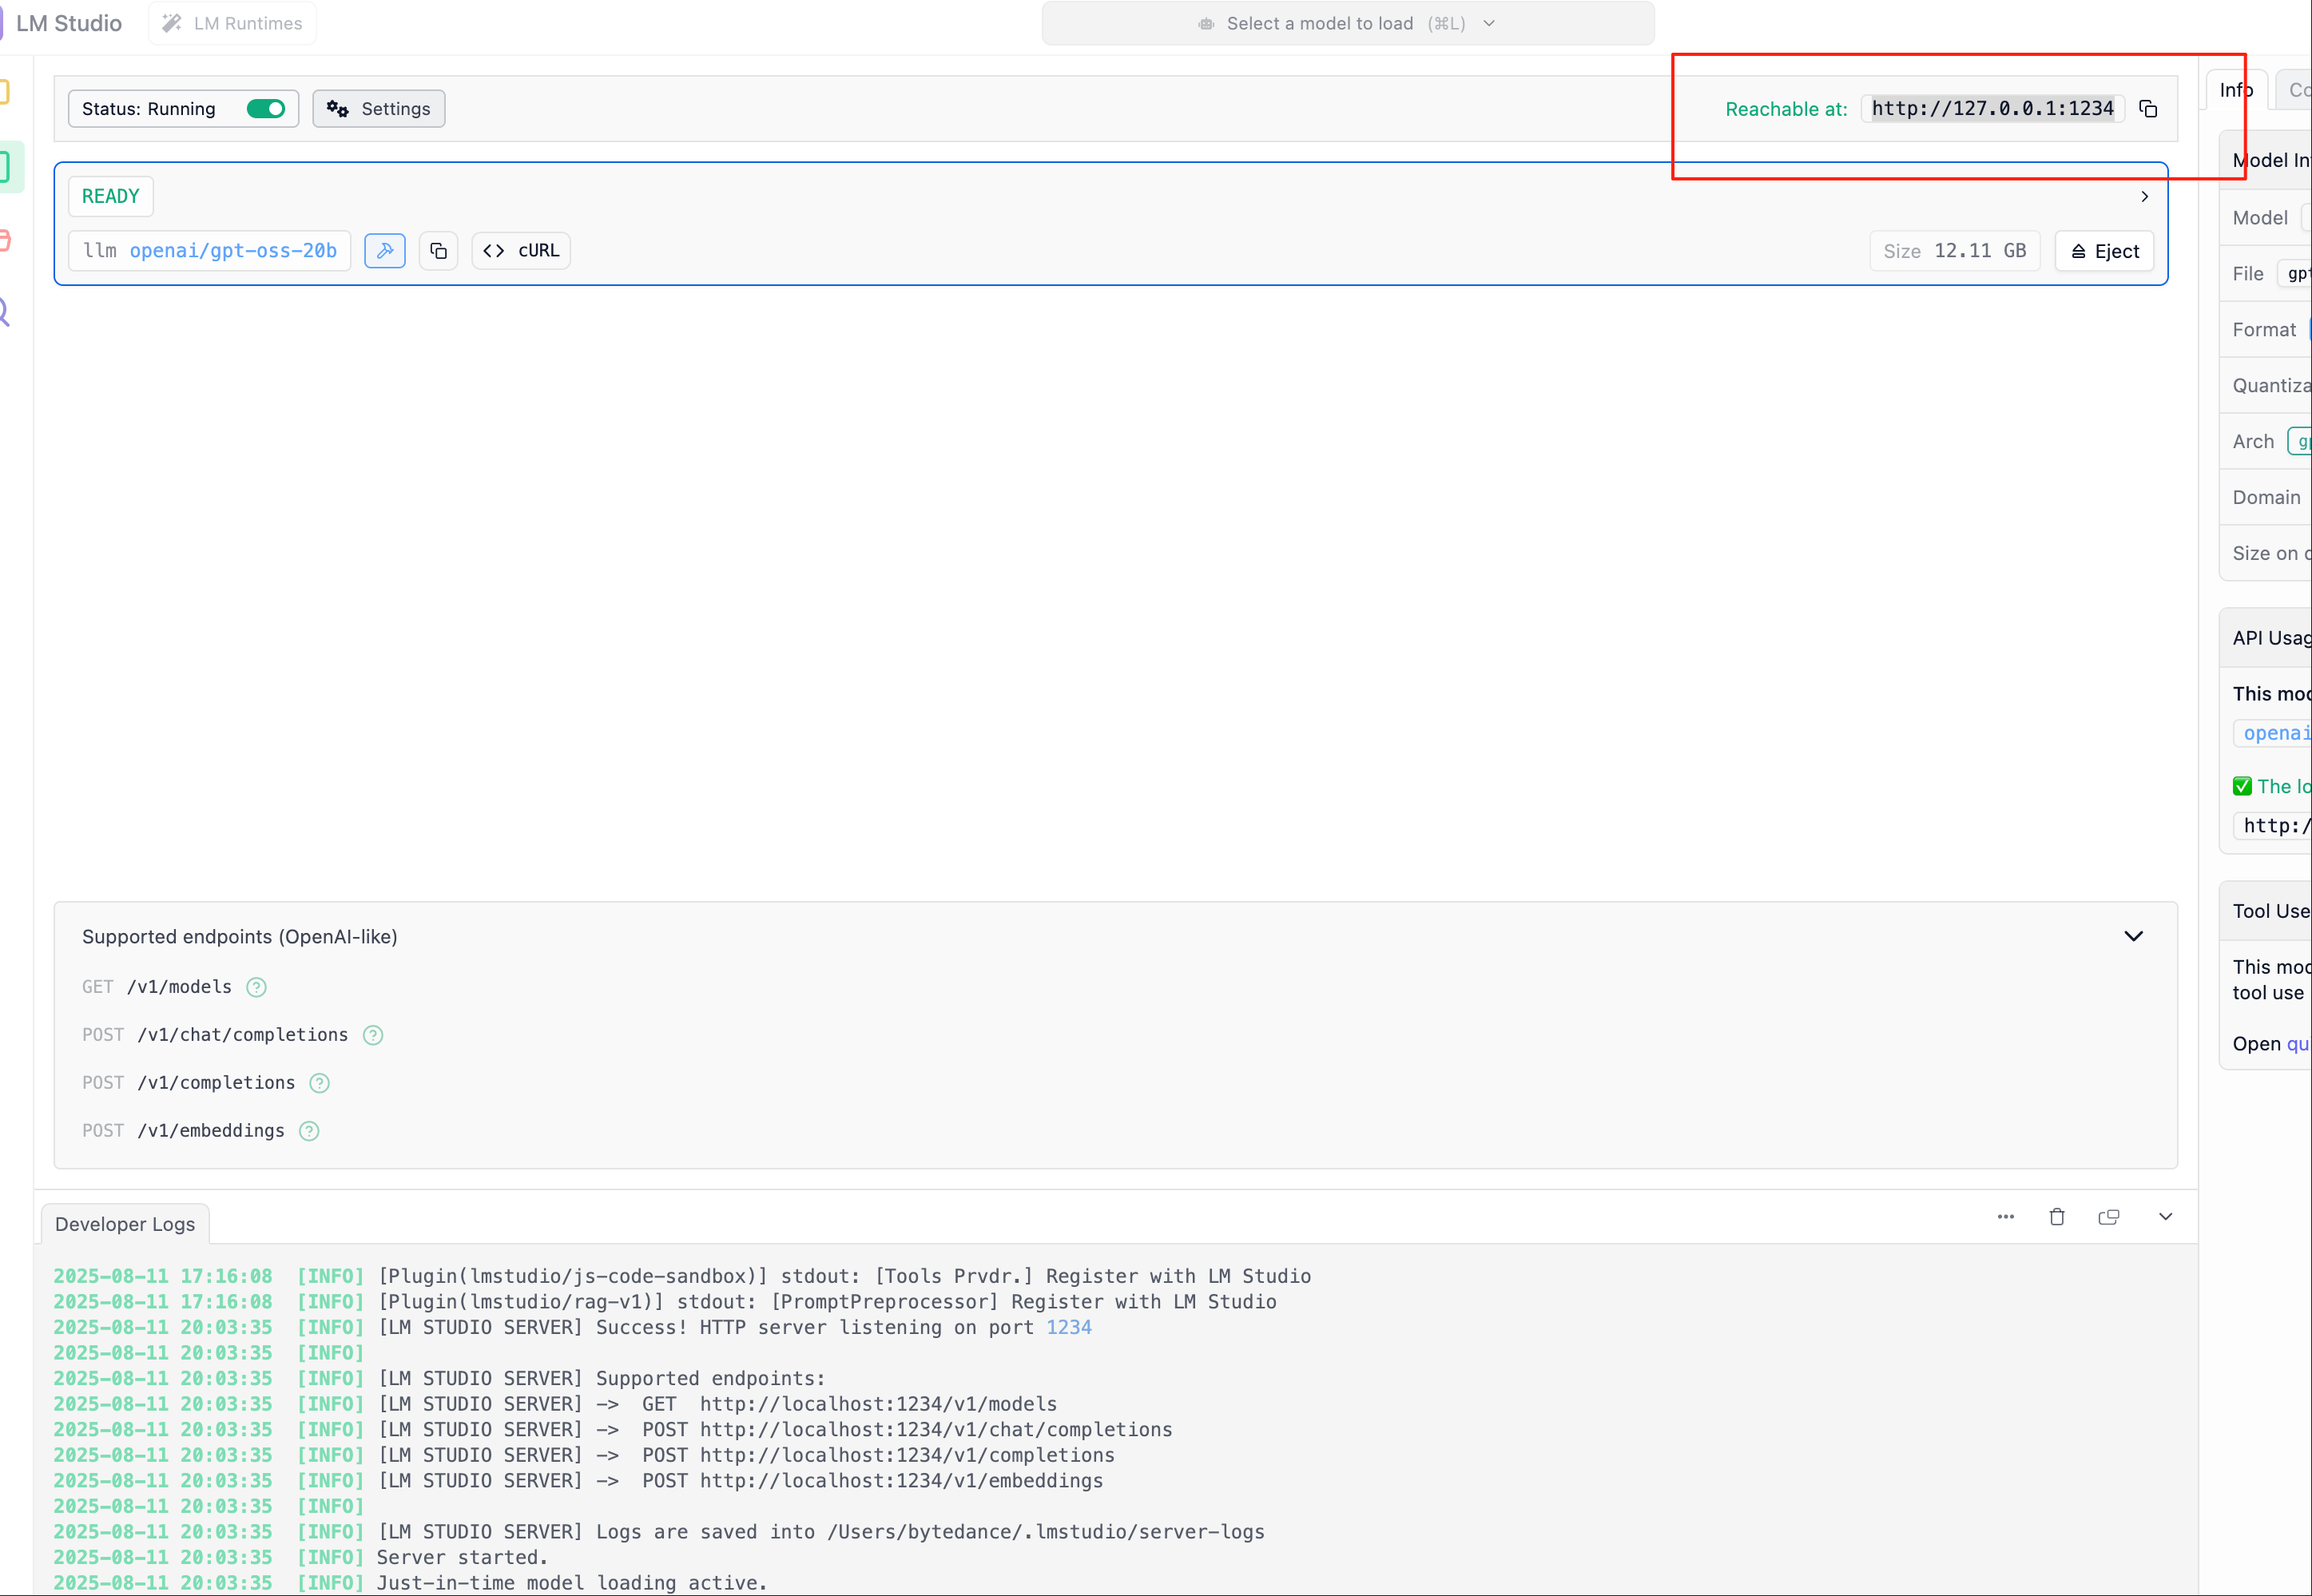
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:1234/v1",
    api_key="not-needed"  # LM Studio does not require an API key
)

result = client.chat.completions.create(
    model="openai/gpt-oss-20b",
    messages=[
        {"role": "system", "content": "You are a helpful assistant."},
        {"role": "user", "content": "Explain what MXFP4 quantization is."}
    ]
)

print(result.choices[0].message.content)如何应用MCP
查看mcp路径
~/.lmstudio/mcp.json LM Studio 的 SDK 有 ++Python++ 和 ++TypeScript++ 版本。您可以利用 SDK 实现工具调用和本地函数执行 gpt-oss。实现此目的的方法是通过 .act() 调用,它允许您向 gpt-oss 提供工具,并让它在调用工具和推理之间切换,直到它完成您的任务。 下面的示例显示了如何为模型提供能够在本地文件系统上创建文件的单个工具。您可以使用此示例作为起点,并使用更多工具对其进行扩展。请参阅有关 ++Python++ 和 ++TypeScript++ 的工具定义的文档。
uv pip install lmstudiopip install lmstudio在python脚本中使用
import readline  # 启用输入行编辑功能,支持历史记录和快捷键
from pathlib import Path

import lmstudio as lms

# 定义一个可以被模型调用的工具函数,让AI助手能够创建文件
# 工具函数本质上就是普通的Python函数,可以实现任何功能
def create_file(name: str, content: str):
    """创建指定名称和内容的文件。

    Args:
        name: 文件名(支持相对路径和绝对路径)
        content: 文件内容

    Returns:
        操作结果的描述信息
    """
    dest_path = Path(name)
    if dest_path.exists():
        return "错误:文件已存在,无法覆盖。"
    try:
        dest_path.write_text(content, encoding="utf-8")
    except Exception as exc:
        return f"错误:文件创建失败 - {exc!r}"
    return f"文件 '{name}' 创建成功。"

def print_fragment(fragment, round_index=0):
    """实时打印模型生成的文本片段,实现流式输出效果。

    Args:
        fragment: 包含生成内容的片段对象
        round_index: 轮次索引(.act()方法会自动传递此参数)

    Note:
        设置默认参数使得此回调函数同时兼容 .complete() 和 .respond() 方法
    """
    print(fragment.content, end="", flush=True)

# 初始化模型和聊天会话
model = lms.llm("openai/gpt-oss-20b")  # 加载OpenAI GPT-OSS 20B模型
chat = lms.Chat("你是一个运行在用户计算机上的智能助手,可以帮助用户完成各种任务。")

# 主交互循环
while True:
    try:
        user_input = input("用户(直接回车退出): ")
    except EOFError:  # 处理Ctrl+D等终端输入结束信号
        print()
        break
    if not user_input.strip():  # 用户输入为空时退出程序
        break

    # 将用户消息添加到聊天历史
    chat.add_user_message(user_input)
    print("助手: ", end="", flush=True)

    # 调用模型进行推理,支持工具调用和流式输出
    model.act(
        chat,                           # 聊天上下文
        [create_file],                  # 可用的工具函数列表
        on_message=chat.append,         # 将完整响应添加到聊天历史
        on_prediction_fragment=print_fragment,  # 流式输出回调
    )
print() # 换行分隔每轮对话04-gpt-oss-20b Lora微调以及Swanlab可视化
引言
看完本教程你将收获: - Lora微调gpt-oss-20b! - 利用ms-swift进行Lora微调gpt-oss-20b!
数据准备
下载多语言推理数据集
from datasets import load_dataset
dataset = load_dataset("HuggingFaceH4/Multilingual-Thinking", split="train")数据可视化
User:
    ¿Cuál es el capital de Australia?
Assistant reasoning:
    Okay, der Benutzer fragt nach der Hauptstadt Australiens. Ich erinnere mich, dass Canberra die Hauptstadt ist. Ich
    sollte das bestätigen. Lass mich sehen, ob es irgendwelche potenziellen Verwirrungen gibt. Der Benutzer könnte auch
    an der größten Stadt interessiert sein. Die größte Stadt ist Sydney, aber die Hauptstadt ist Canberra. Ich sollte
    das klarstellen. Vielleicht auch erwähnen, dass Canberra eine geplante Stadt ist und nicht die größte. Der Benutzer
    könnte auch nach der Geografie fragen. Vielleicht erwähne ich, dass Canberra im südwestlichen Teil der Australian
    Capital Territory liegt. Ich sollte die Antwort präzise und freundlich halten. Vielleicht auch erwähnen, dass
    Canberra oft mit Sydney verwechselt wird. Ich sollte sicherstellen, dass die Antwort klar und korrekt ist.
Assistant response:
    La capital de Australia es **Canberra**. Aunque es la ciudad más pequeña de las principales capitales del país, fue
    elegida en 1908 como la sede del gobierno federal para equilibrar la influencia entre las ciudades de Sydney y
Melbourne. Canberra está ubicada en el Territorio de la Capital Australiana (ACT), en el este de Australia.环境配置
pip install torch --index-url https://download.pytorch.org/whl/cu128
pip install "peft>=0.17.0" "transformers>=4.55.0" trackio微调
加载tokenizer
from transformers import AutoTokenizer

tokenizer = AutoTokenizer.from_pretrained("openai/gpt-oss-20b") #替换成你下载的目录哦~然后我们可以使用tokenizer的
apply_chat_template()方法来格式化消息:
messages = dataset[0]["messages"]
conversation = tokenizer.apply_chat_template(messages, tokenize=False)
print(conversation)import torch
from transformers import AutoModelForCausalLM, Mxfp4Config
quantization_config = Mxfp4Config(dequantize=True)
model_kwargs = dict(
attn_implementation="eager",
torch_dtype=torch.bfloat16,
quantization_config=quantization_config,
use_cache=False,
device_map="auto",
)
model = AutoModelForCausalLM.from_pretrained("openai/gpt-oss-20b", **model_kwargs)这将为模型加载训练所需的配置。attn_implementation 设置为渴望更好的性能,use_cache 设置为 False,因为我们将使用梯度检查点微调模型。
如果您熟悉 Transformers,您可能会注意到我们正在使用 Mxfp4Config 进行量化。这是 OpenAI 模型的特定配置,允许我们使用混合精度训练,其中包含一种称为 ++MXFP4++ 的特殊 4 位浮点格式,该格式针对 AI 工作负载进行了优化。
测试一条message
messages = [
    {"role": "user", "content": "¿Cuál es el capital de Australia?"},
]

input_ids = tokenizer.apply_chat_template(
    messages,
    add_generation_prompt=True,
    return_tensors="pt",
).to(model.device)

output_ids = model.generate(input_ids, max_new_tokens=512)
response = tokenizer.batch_decode(output_ids)[0]
print(response)配置 LoRA 参数
from peft import LoraConfig, get_peft_model

peft_config = LoraConfig(
    r=8,
    lora_alpha=16,
    target_modules="all-linear",
    target_parameters=[
        # MoE 专家层的投影,按需增减
        "7.mlp.experts.gate_up_proj",
        "7.mlp.experts.down_proj",
        "15.mlp.experts.gate_up_proj",
        "15.mlp.experts.down_proj",
        "23.mlp.experts.gate_up_proj",
        "23.mlp.experts.down_proj",
    ],
)
peft_model = get_peft_model(model, peft_config)
peft_model.print_trainable_parameters()注意:openai/gpt-oss-20b 模型是一种++混合专家 (MoE)++ 架构。除了针对注意力层(target_modules=“all-linear”) 之外,在专家模块中包含投影层也很重要。PEFT 通过 target_parameters 参数促进了这一点,它允许您指定特定于专家的层,例如 mlp.experts.down_proj 和 mlp.experts.gate_up_proj。
from datasets import DatasetDict

max_length = 4096

def format_and_tokenize(example):
    # 期望存在 "messages" 字段(和你示例一致)
    messages = example["messages"]
    # 不加 generation_prompt;让模型学习到完整的对话展开
    text = tokenizer.apply_chat_template(
        messages, tokenize=False
    )
    # 直接整体 tokenization,labels=inputs(由 collator 处理)
    tokens = tokenizer(
        text,
        truncation=True,
        max_length=max_length,
        return_attention_mask=True,
    )
    return tokens

tokenized = ds.map(format_and_tokenize, remove_columns=ds.column_names)
# 简单划个验证集(可选)
splits = tokenized.train_test_split(test_size=0.01, seed=42)
train_ds, eval_ds = splits["train"], splits["test"]微调参数设置
from dataclasses import dataclass
import torch
from transformers import Trainer, TrainingArguments, default_data_collator

@dataclass
class CausalDataCollator:
    tokenizer: AutoTokenizer
    mlm: bool = False
    def __call__(self, features):
        # default_data_collator 会把 input_ids/attention_mask 转成张量
        batch = default_data_collator(features)
        if "labels" not in batch:
            batch["labels"] = batch["input_ids"].clone()
        return batch

collator = CausalDataCollator(tokenizer)

training_args = TrainingArguments(
    output_dir="gpt-oss-20b-multilingual-reasoner",
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,
    num_train_epochs=1.0,
    learning_rate=2e-4,
    lr_scheduler_type="cosine_with_min_lr",
    lr_scheduler_kwargs={"min_lr_rate": 0.1},
    warmup_ratio=0.03,
    logging_steps=1,
    save_steps=200,
    save_total_limit=2,
    bf16=True,
    gradient_checkpointing=True,
    report_to=[],
)

trainer = Trainer(
    model=model,
    args=training_args,
    train_dataset=train_ds,
    eval_dataset=eval_ds,
    tokenizer=tokenizer,
    data_collator=collator,
)

trainer.train()训练过程上传到Swanlab 训练过程通过swanlab可视化
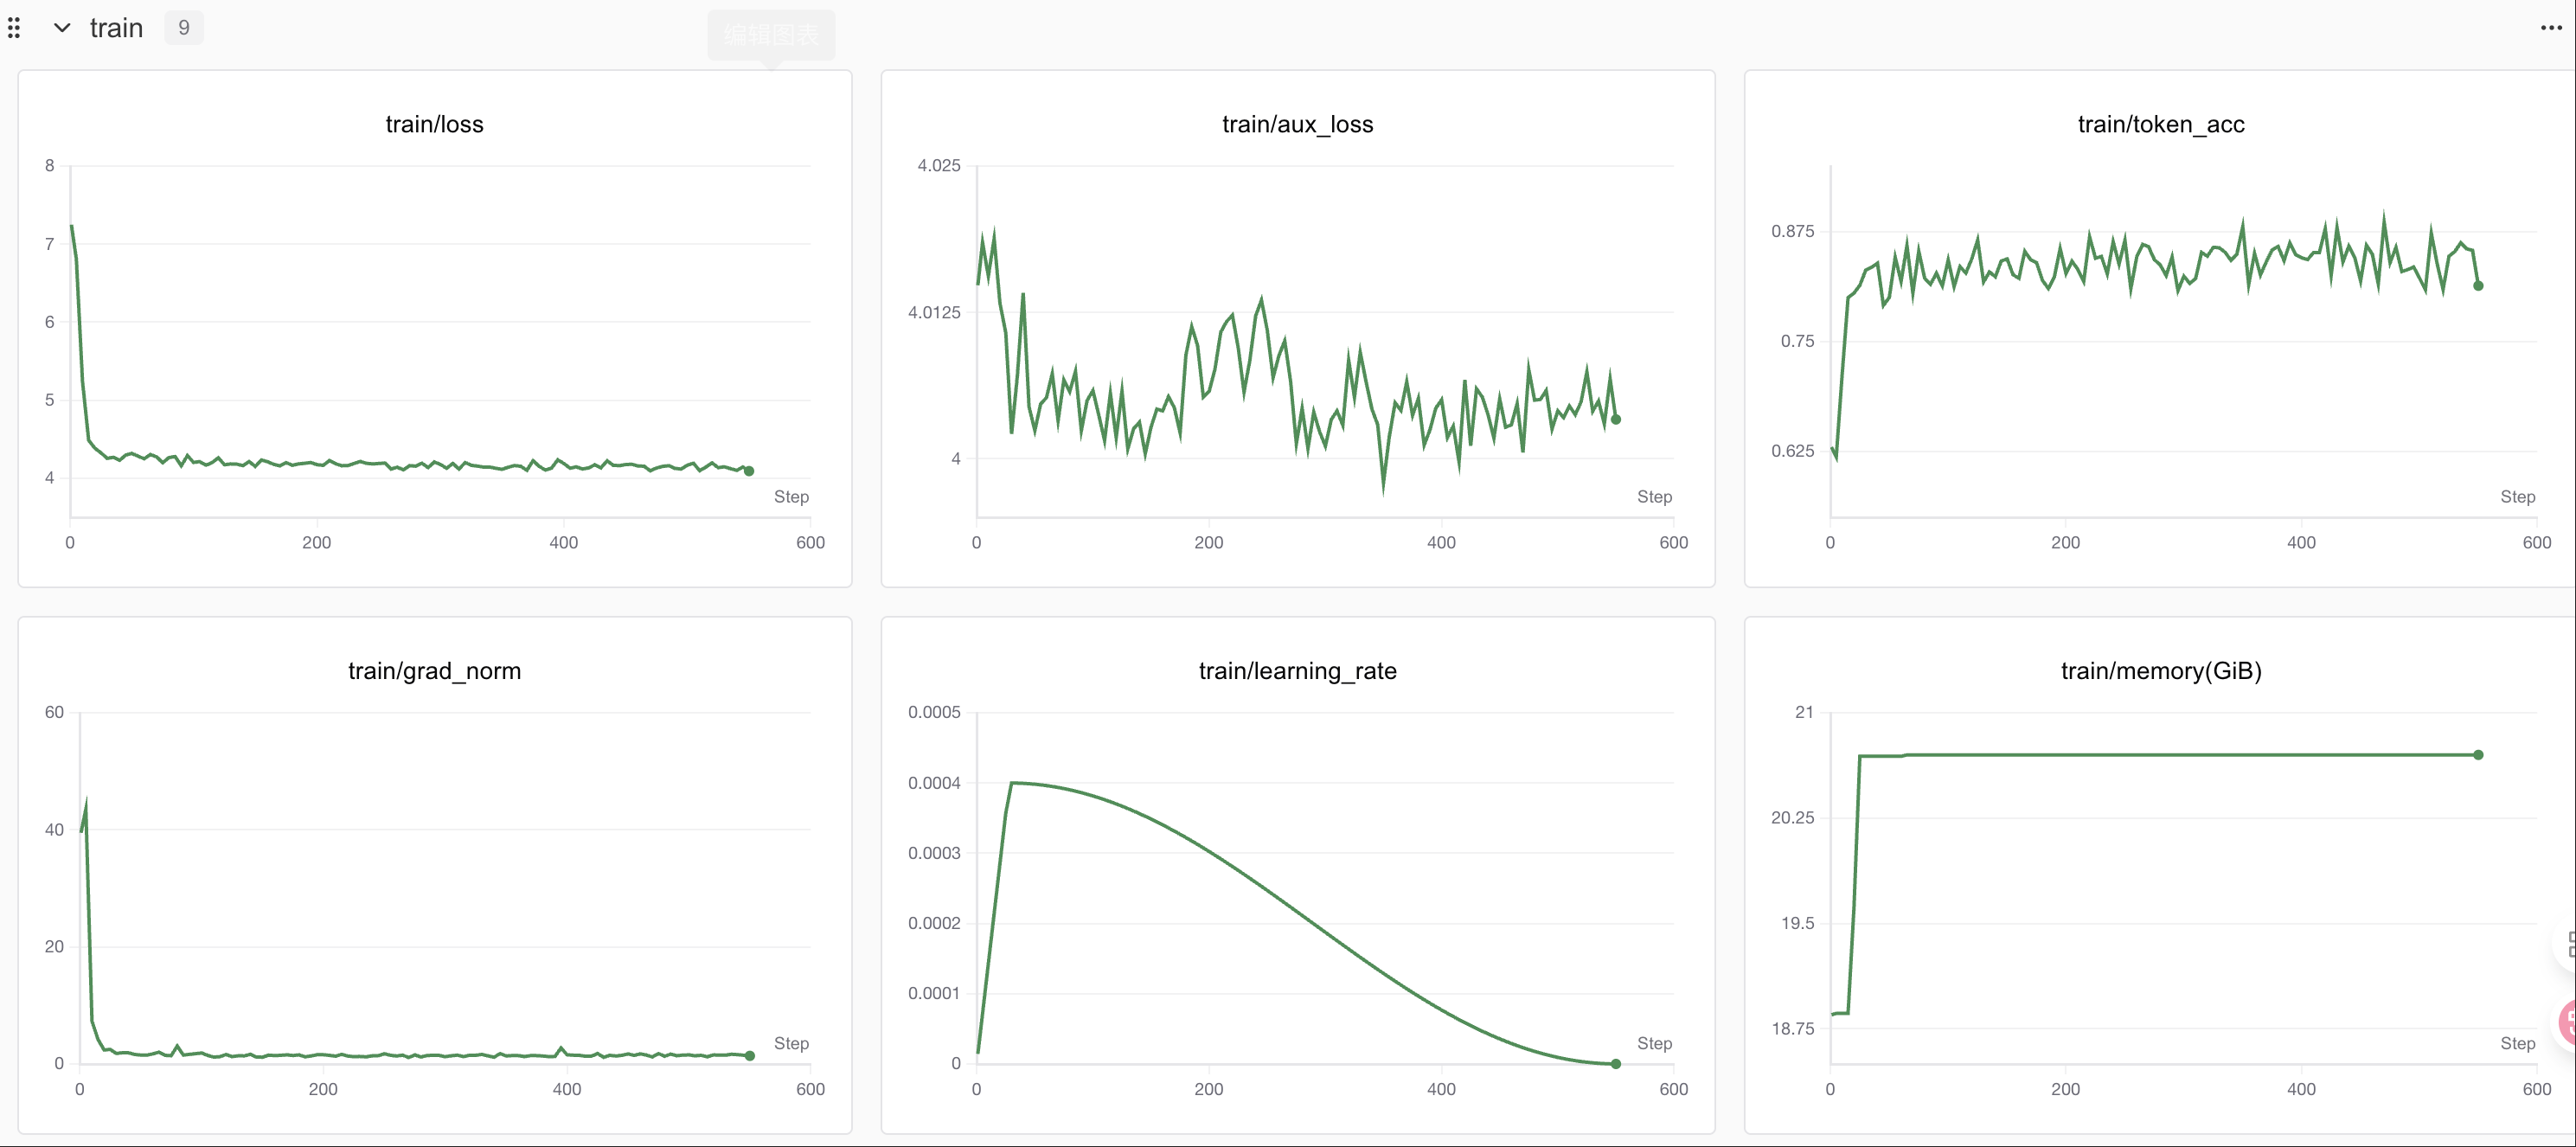
Swanlab
SwanLab 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在
SwanLab上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练?
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
在哪里用?
设置成你自己的api_key~
from transformers import TrainerCallback

try:
    import swanlab
    class SwanLabCallback(TrainerCallback):
        def __init__(self, project="swift-robot"):
            swanlab.init(project=project)

        def on_log(self, args, state, control, logs=None, **kwargs):
            if logs:
                for k,v in logs.items():
                    if isinstance(v, (int,float)):
                        swanlab.log({k: v})
    trainer.add_callback(SwanLabCallback(project="swift-robot"))
except Exception as e:
print("SwanLab disabled:", e)权重合并
from peft import PeftModel

# 先载入基座
infer_kwargs = dict(attn_implementation="eager", torch_dtype="auto", use_cache=True, device_map="auto")
base_model = AutoModelForCausalLM.from_pretrained(model_id, **infer_kwargs).cuda()

# 把 LoRA 适配器加载回来(用训练输出目录)
peft_model = PeftModel.from_pretrained(base_model, "gpt-oss-20b-multilingual-reasoner")
# 合并并卸载LoRA
merged = peft_model.merge_and_unload()
merged.eval()

# 生成
messages = [
    {"role": "system", "content": "reasoning language: German"},
    {"role": "user", "content": "¿Cuál es el capital de Australia?"},
]
inp = tokenizer.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt").to(merged.device)
gen = merged.generate(inp, max_new_tokens=512, do_sample=True, temperature=0.6)
print(tokenizer.batch_decode(gen)[0])
ms-swift微调
这里给大家提供一种框架微调教程 基于
ms-swift微调的框架有很多,不论是选择哪一方都是殊途同归,为什么选择ms-swift见:
🍎 模型类型:支持450+纯文本大模型、150+多模态大模型以及All-to-All全模态模型、序列分类模型、Embedding模型训练到部署全流程。
数据集类型:内置150+预训练、微调、人类对齐、多模态等各种类型的数据集,并支持自定义数据集。 硬件支持:CPU、RTX系列、T4/V100、A10/A100/H100、Ascend NPU、MPS等。
🍊 轻量训练:支持了LoRA、QLoRA、DoRA、LoRA+、ReFT、RS-LoRA、LLaMAPro、Adapter、GaLore、Q-Galore、LISA、UnSloth、Liger-Kernel等轻量微调方式。
分布式训练:支持分布式数据并行(DDP)、device_map简易模型并行、DeepSpeed ZeRO2 ZeRO3、FSDP等分布式训练技术。 量化训练:支持对BNB、AWQ、GPTQ、AQLM、HQQ、EETQ量化模型进行训练。 RLHF训练:支持纯文本大模型和多模态大模型的DPO、GRPO、RM、PPO、KTO、CPO、SimPO、ORPO等人类对齐训练方法。
🍓 多模态训练:支持对图像、视频和语音不同模态模型进行训练,支持VQA、Caption、OCR、Grounding任务的训练。
界面训练:以界面的方式提供训练、推理、评测、量化的能力,完成大模型的全链路。 插件化与拓展:支持自定义模型和数据集拓展,支持对loss、metric、trainer、loss-scale、callback、optimizer等组件进行自定义。
🍉 工具箱能力:不仅提供大模型和多模态大模型的训练支持,还涵盖其推理、评测、量化和部署全流程。
推理加速:支持PyTorch、vLLM、LmDeploy推理加速引擎,并提供OpenAI接口,为推理、部署和评测模块提供加速。 模型评测:以EvalScope作为评测后端,支持100+评测数据集对纯文本和多模态模型进行评测。 模型量化:支持AWQ、GPTQ和BNB的量化导出,导出的模型支持使用vLLM/LmDeploy推理加速,并支持继续训练。
环境配置
基础环境配置
PyTorch 2.6.0 Python 3.12(ubuntu22.04) CUDA 12.4 GPU NVIDIA H20-96GB * 4
Lora环境配置
pip install ms-swift==3.7.0
pip install deepspeed
pip install swanlab
pip install -U transformers kernels torch数据准备
  {
    "messages": [
      {
        "role": "user",
        "content": "Source Text:There, they found the body of Saroja Balasubramanian, 53, covered with blood-stained blankets. Style Guide:The translation style must be style: wikinews/Crime and Law"
      },
      {
        "role": "assistant",
        "content": "<think>\nxxx</think>\n\n在那里,他们发现了 53 岁的萨罗贾·巴拉苏布拉曼尼亚的尸体,盖着血迹斑斑的毯子。"
      }
    ]
},或者你可以使用开源的任意数据集 这里,其他同学找了一个魔搭上开源的赛博猫娘数据集来进行这次教程,试想哪一个佬不想拥有一个赛博猫娘呢?
{
  "instruction": "沐雪的功能是什么?",
  "input": "",
  "output": "喵~本雪的主要功能是让你开心喵!用可爱的猫娘之力治愈你的心灵,喵呜~"
  "history":[]
}Lora微调
编写bash脚本
MASTER_PORT=$PORT \                             # 分布式训练主进程的通信端口,使用环境变量 $PORT
NPROC_PER_NODE=4 \                              # 每个节点的进程数(通常等于 GPU 数)
CUDA_VISIBLE_DEVICES=0,1,2,3 \                  # 指定使用的 GPU 编号
swift sft --deepspeed zero3\                    # 使用 swift 的 sft 训练命令,并启用 DeepSpeed ZeRO-3 优化
    --model /root/autodl-tmp/gpt-oss-20b \      # 模型路径(替换为你自己的模型目录)
    --dataset /root/autodl-tmp/train.json \     # 数据集路径(替换为你自己的训练数据)
    --train_type lora \                         # 训练类型为 LoRA(低秩适配)
    --torch_dtype bfloat16 \                    # 计算精度设为 bfloat16
    --num_train_epochs 35 \                     # 训练总轮数
    --per_device_train_batch_size 1 \           # 每个设备的训练批大小
    --per_device_eval_batch_size 1 \            # 每个设备的验证批大小
    --learning_rate 1e-4 \                      # 学习率
    --lora_rank 8 \                             # LoRA 的秩(低秩分解维度)
    --lora_alpha 32 \                           # LoRA 缩放因子
    --target_modules all-linear \               # 应用 LoRA 的目标模块类型
    --gradient_accumulation_steps 16 \          # 梯度累积步数
    --eval_steps 50 \                           # 每 50 步进行一次评估
    --save_steps 50 \                           # 每 50 步保存一次模型
    --save_total_limit 2 \                      # 最多保留 2 个最新的检查点
    --logging_steps 5 \                         # 每 5 步记录一次日志
    --max_length 8192 \                         # 最大序列长度
    --output_dir output \                       # 模型输出目录
    --warmup_ratio 0.05 \                       # 学习率预热比例
    --dataloader_num_workers 4 \                # DataLoader 工作线程数
    --use_liger_kernel true \                   # 启用 liger kernel 优化
    --load_from_cache_file false \              # 是否从缓存文件加载数据
    --loss_scale ignore_empty_think \           # 忽略空 think 标签的 loss
    --save_strategy epoch\                      # 保存策略:每个 epoch 保存一次
    --model_author gxb \                        # 模型作者名
    --model_name gxb-gpt-oss-20b-agent-distill \# 模型名称
    --report_to swanlab \                       # 训练日志上报到 SwanLab
--swanlab_project swift-robot # SwanLab 项目名称测试效果
CUDA_VISIBLE_DEVICES=0 \
swift infer \
    --adapters v0-20250811-150539/checkpoint-551 \
    --stream true \
    --temperature 0 \
    --max_new_tokens 2048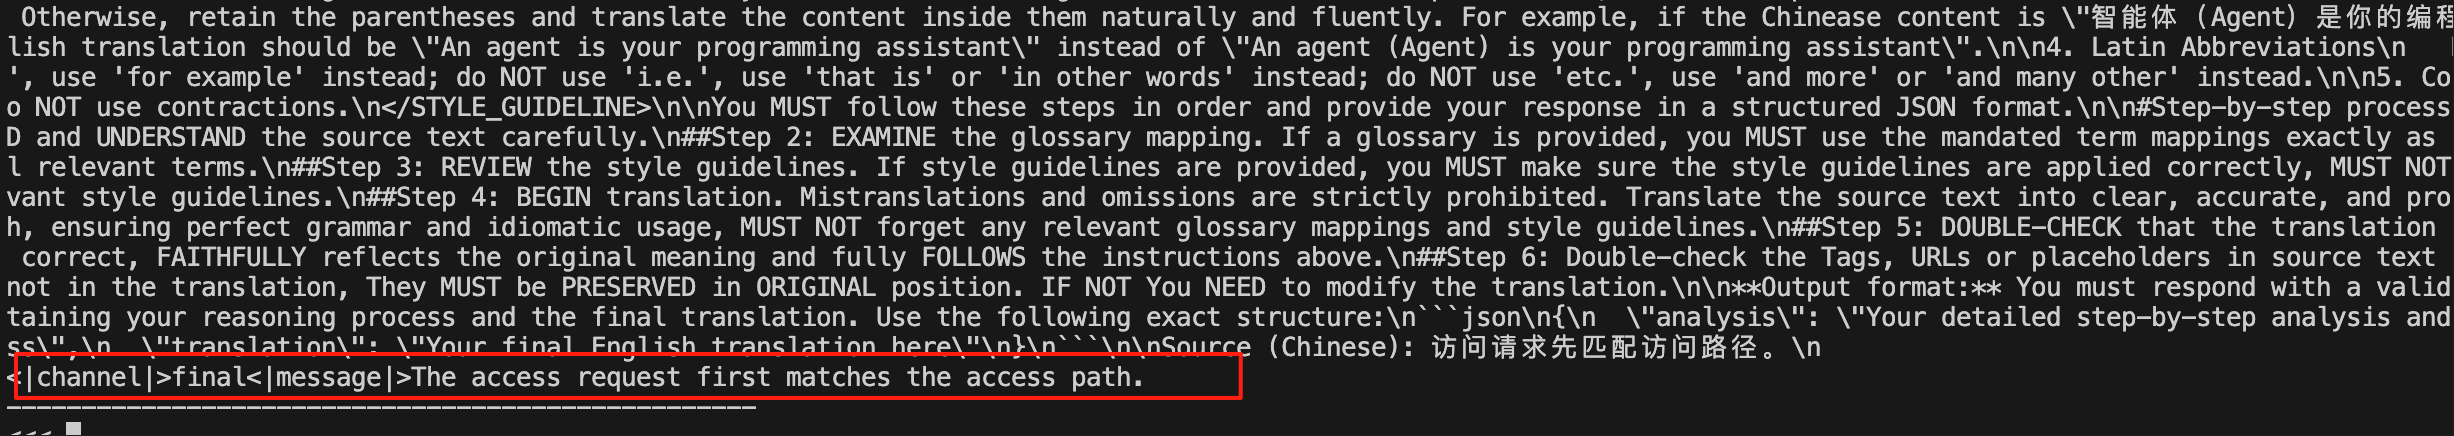
合并权重
swift export \
    --adapters v0-20250811-150539/checkpoint-551 \
    --merge_lora true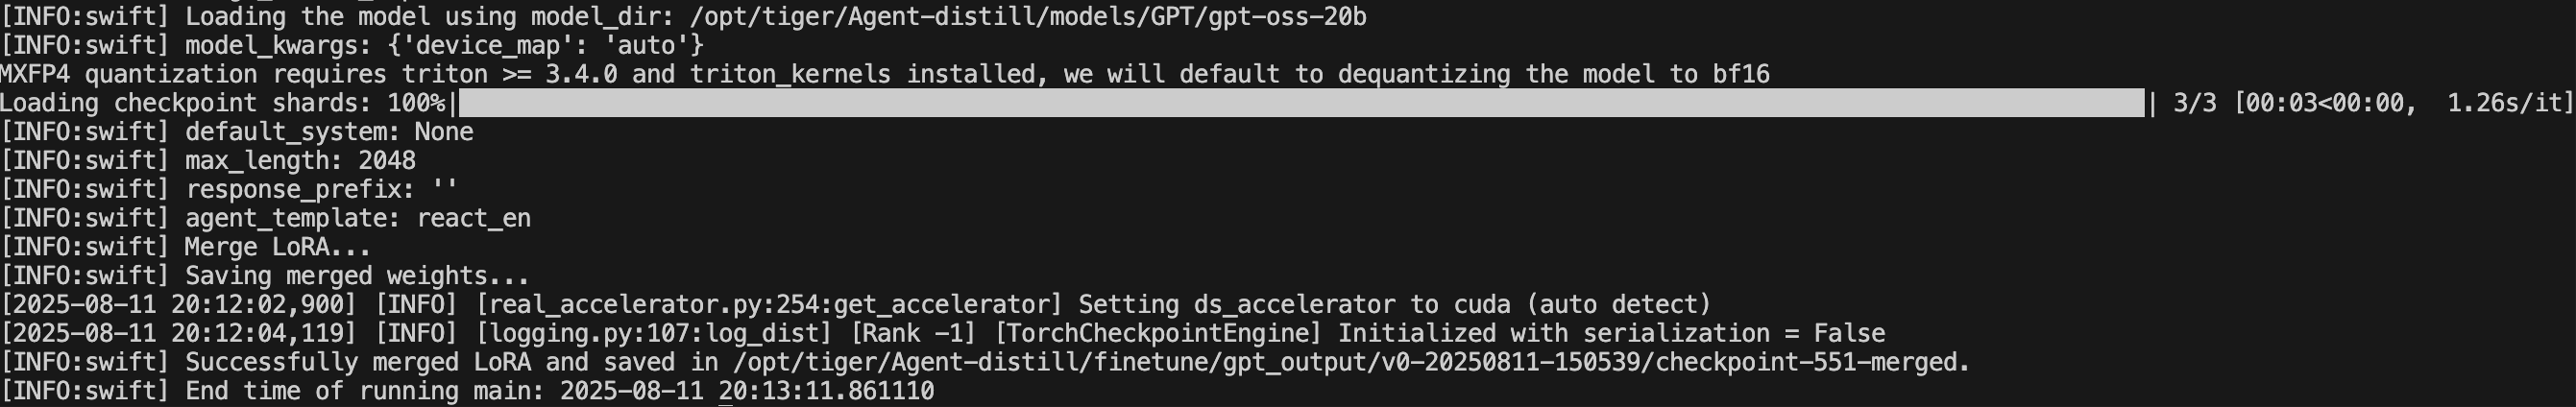
推理
编写推理脚本
CUDA_VISIBLE_DEVICES=0 \
swift infer \
    --model v0-20250811-150539/checkpoint-551 \
    --val_dataset SFT/dataForSFT/val.json \
    --max_new_tokens 2048 \
    --result_path SFT/infer_output/_sft_1epoch.jsonl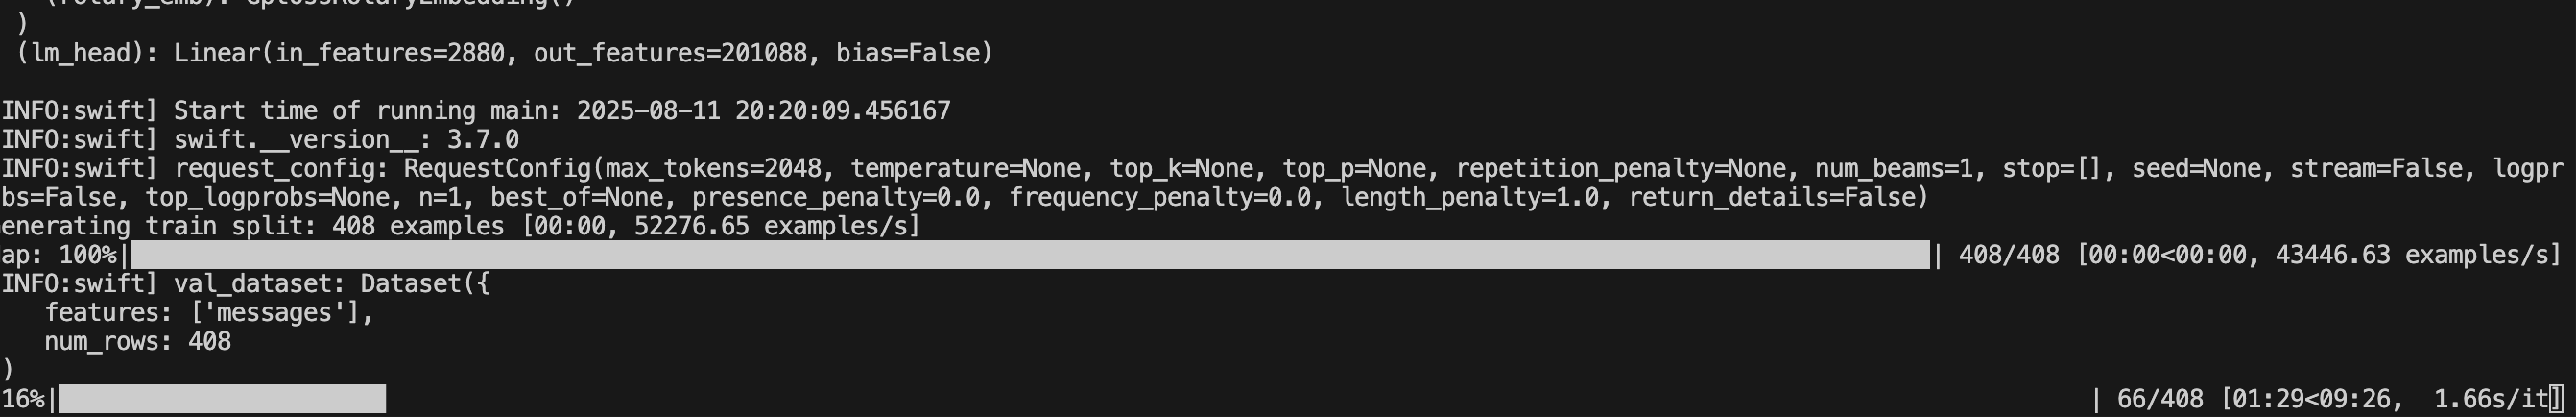
05-gpt-oss-20b DPO微调以及Swanlab可视化
引言
看完本教程你将收获,构造DPO数据,利用ms-swift对gpt-oss-20b进行微调!
为什么要做DPO?
在大模型微调中,通常先做 SFT(有监督微调)再做 DPO(直接偏好优化),因为 SFT 用高质量标注数据让模型先学会任务的基本能力和输出格式,而 DPO 用成对的优劣答案引导模型更符合人类偏好。若直接做 DPO,模型可能还不会生成合格答案,偏好信号噪声大,难以收敛;先 SFT 再 DPO 则能在“会做”的基础上优化到“做得好”。
环境配置
基础环境配置
PyTorch 2.6.0 Python 3.12(ubuntu22.04) CUDA 12.4 GPU NVIDIA H20-96GB * 4
Lora环境配置
pip install ms-swift==3.7.0
pip install deepspeed
pip install swanlab
pip install -U transformers kernels torch数据准备
{"messages": [{"role": "system", "content": "你是个有用无害的助手"}, {"role": "user", "content": "告诉我明天的天气"}, {"role": "assistant", "content": "明天天气晴朗"}], "rejected_response": "我不知道"}
{"messages": [{"role": "system", "content": "你是个有用无害的数学计算器"}, {"role": "user", "content": "1+1等于几"}, {"role": "assistant", "content": "等于2"}, {"role": "user", "content": "再加1呢"}, {"role": "assistant", "content": "等于3"}], "rejected_response": "我不知道"}在翻译任务上的数据:
    {
        "messages": [
            {"role": "system", "content": "You are an expert machine translation specialist in the field of Technical Writing, highly proficient in translating from Chinese to English."},
            {"role": "user", "content": "Translate the following Chinese text to English: 步骤一:添加域名"},
            {"role": "assistant", "content": "Step 1: Add a domain name"}],
        "rejected_response": "Step 1: Adding domain names"
}微调
构造dpo脚本
MASTER_PORT=$PORT \
NPROC_PER_NODE=4 \
CUDA_VISIBLE_DEVICES=0,1,2,3 \
swift rlhf --rlhf_type dpo \
    --deepspeed zero3 \
    --model models/gpt-oss-20b \ #替换成你自己的模型路径
    --dataset  dpo_data.json \ #替换成你自己的数据路径
    --train_type lora \
    --torch_dtype bfloat16 \
    --num_train_epochs 1 \
    --per_device_train_batch_size 2 \
    --per_device_eval_batch_size 1 \
    --learning_rate 4e-4 \
    --lora_rank 8 \
    --lora_alpha 32 \
    --target_modules all-linear \
    --gradient_accumulation_steps 4 \
    --save_strategy epoch \
    --save_total_limit 5 \
    --logging_steps 5 \
    --max_length 8192 \
    --output_dir /opt/tiger/Agent-distill/finetune/gpt_output \
    --warmup_ratio 0.05 \
    --dataloader_num_workers 4 \
    --use_liger_kernel true \
    --load_from_cache_file false \
    --loss_scale ignore_empty_think \
    --save_strategy epoch\
    --model_author gxb \
    --model_name gxb-gpt-oss-20b-dpo \
    --report_to swanlab \ #使用swanlab记录实验
--swanlab_project swift-robot训练过程可视化
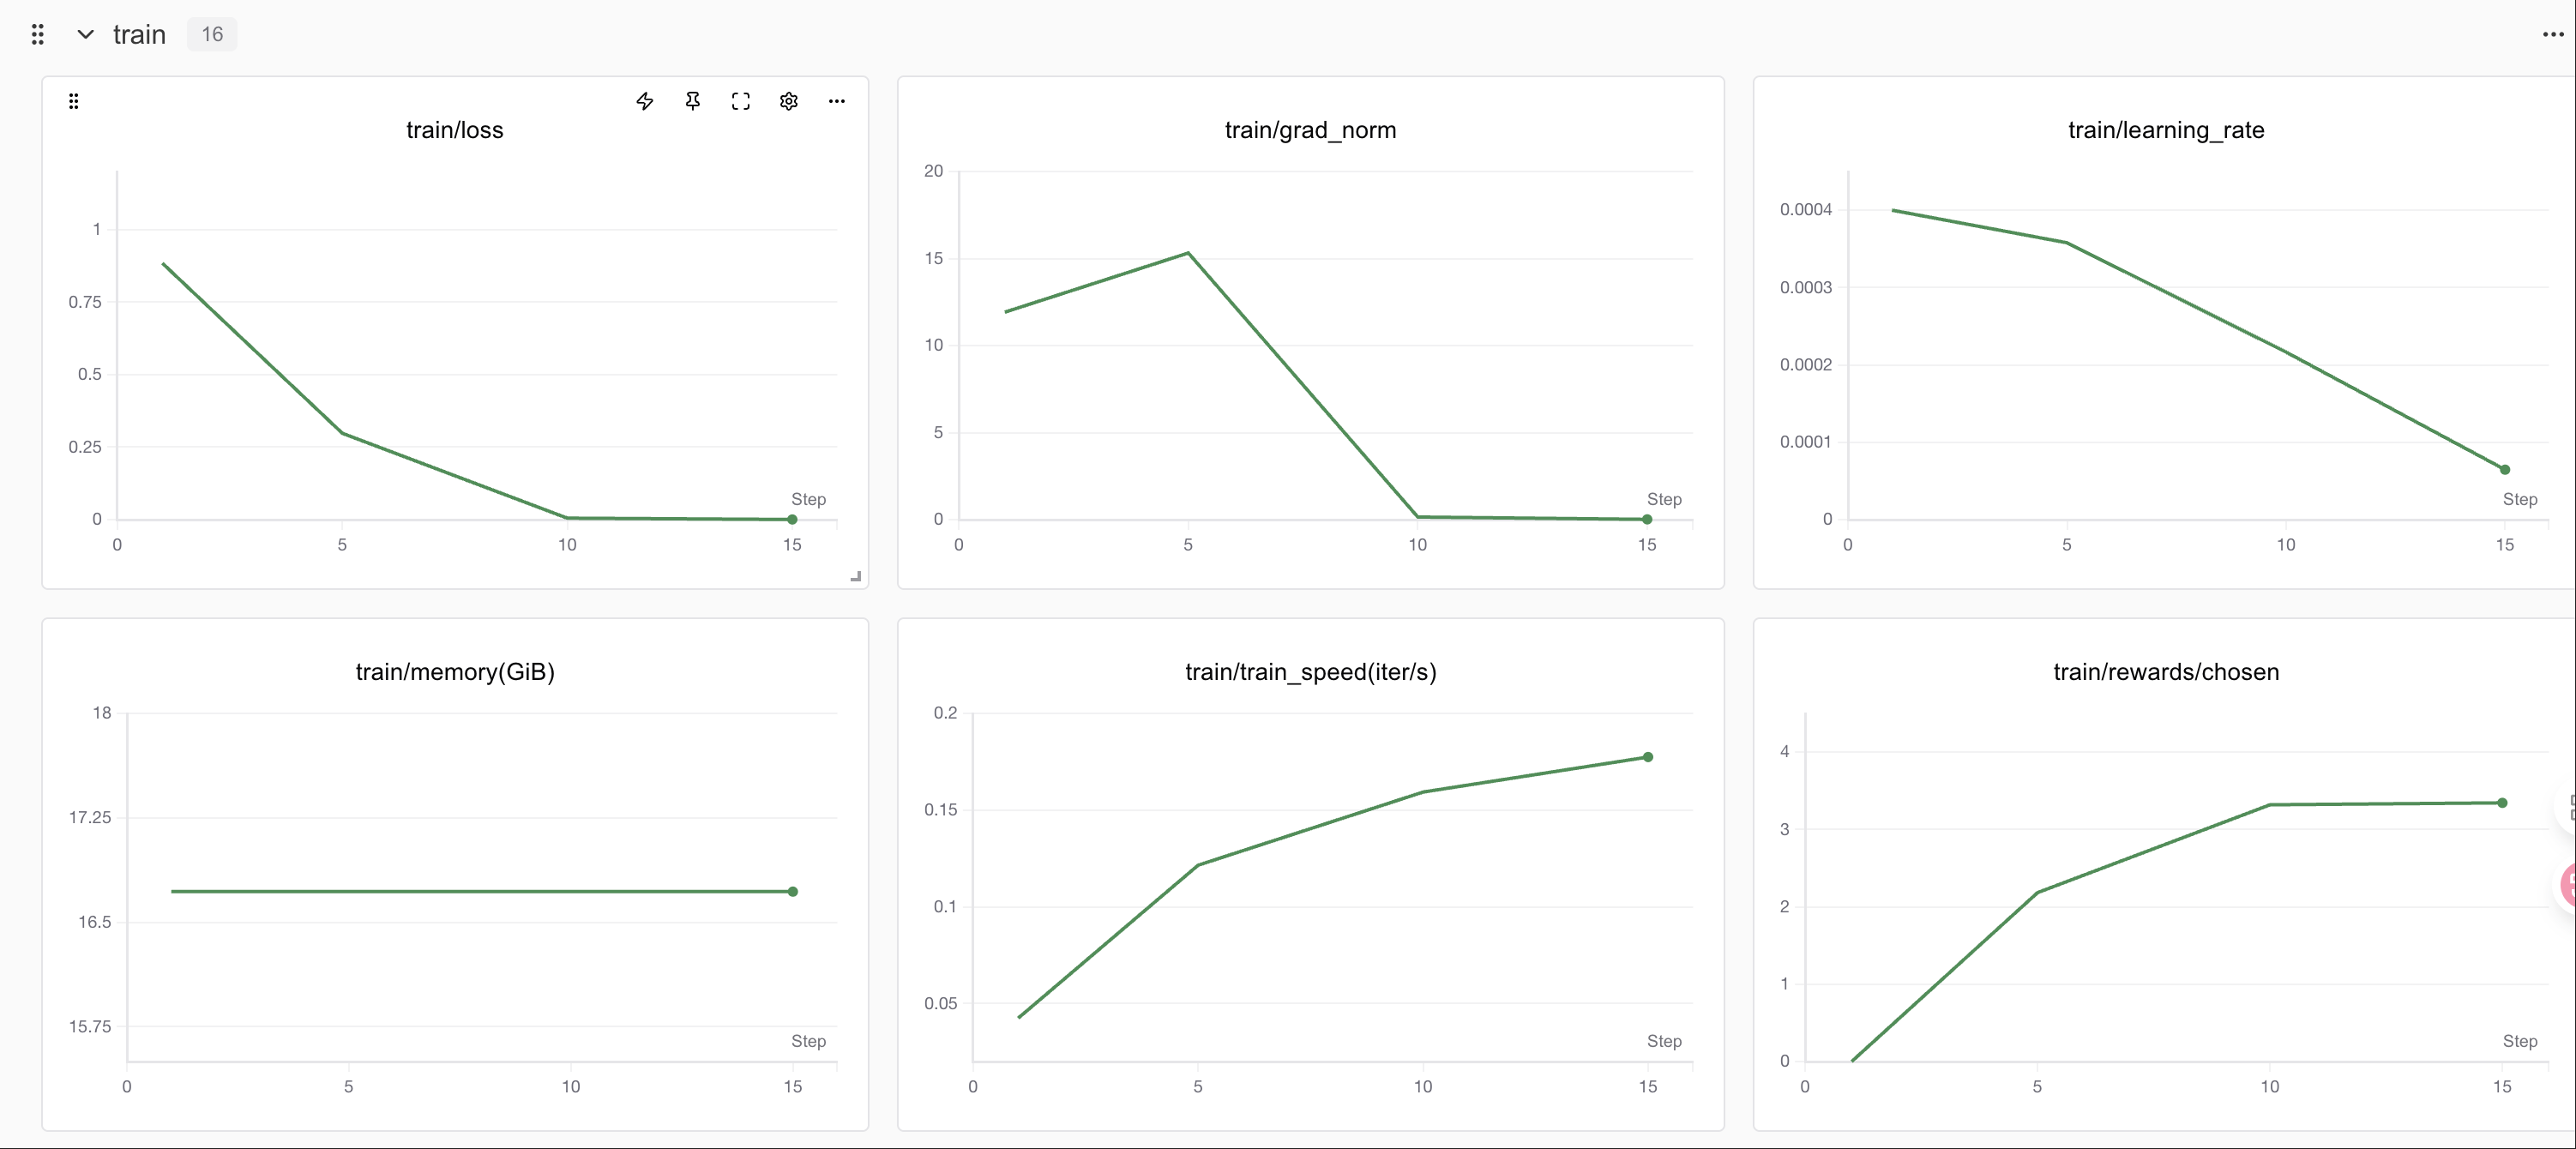
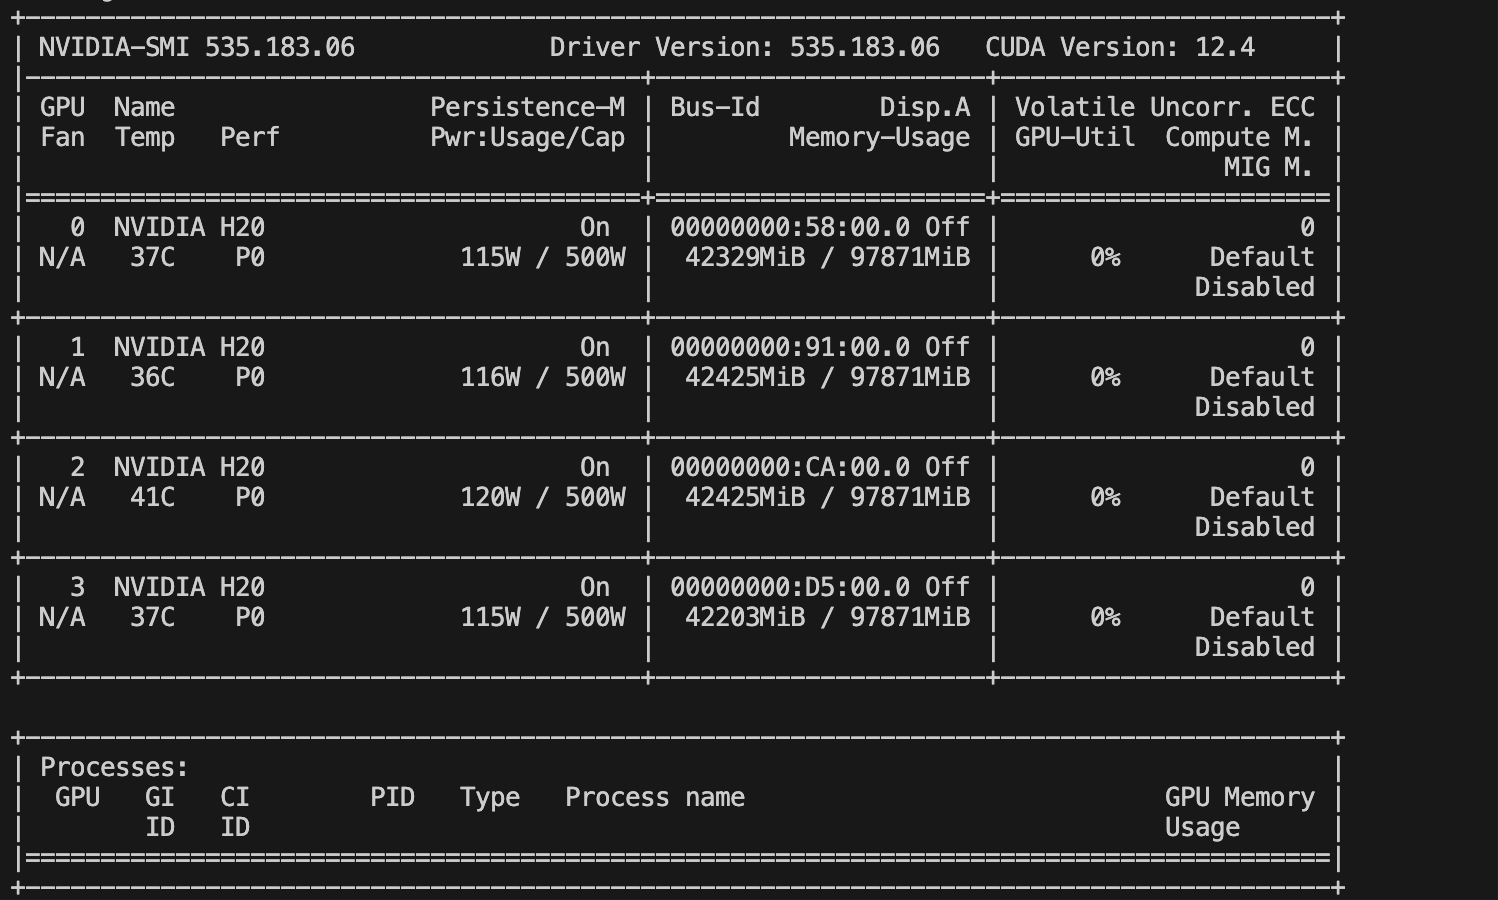
显存占用情况
Swanlab
SwanLab 是一个开源的模型训练记录工具,面向 AI 研究者,提供了训练可视化、自动日志记录、超参数记录、实验对比、多人协同等功能。在
SwanLab上,研究者能基于直观的可视化图表发现训练问题,对比多个实验找到研究灵感,并通过在线链接的分享与基于组织的多人协同训练,打破团队沟通的壁垒。
为什么要记录训练?
相较于软件开发,模型训练更像一个实验科学。一个品质优秀的模型背后,往往是成千上万次实验。研究者需要不断尝试、记录、对比,积累经验,才能找到最佳的模型结构、超参数与数据配比。在这之中,如何高效进行记录与对比,对于研究效率的提升至关重要。
在哪里用?
合并权重
后续步骤与SFT保持一致
swift export \
    --adapters v0-20250812-150539/checkpoint-20 \
--merge_lora true推理
编写推理脚本
CUDA_VISIBLE_DEVICES=0 \
swift infer \
    --model v0-20250812-150539/checkpoint-20-merged \
    --val_dataset val.json \
    --max_new_tokens 2048 \
    --result_path dpo_1epoch.jsonl