个人知识库助手项目
一、引言
1、项目背景介绍
2、目标与意义
3、主要功能
二、技术实现
1、环境依赖
1.1 技术资源要求
1.2 项目设置
1.3 项目运行
2、开发流程简述
2.1 当前的项目版本及未来规划
2.2 核心Idea
2.3 使用的技术栈
三、应用详解
1、核心架构
2、索引-indexing
2.1 知识库搭建-加载和读取
2.2 文本分割和向量化
2.3 向量数据库
3、检索-Retriver和生成-Generator
3.1 向量数据库检索
3.2 大模型llm的调用
3.3 prompt和构建问答链
3.总结与展望
3.1 个人知识库关键点总结
3.2 未来发展方向
4.致谢
一、引言
1、项目背景介绍
在数据量激增的当代社会,有效管理和检索信息成为了一项关键技能。为了应对这一挑战,本项目应运而生,旨在构建一个基于 Langchain 的个人知识库助手。该助手通过高效的信息管理系统和强大的检索功能,为用户提供了一个可靠的信息获取平台。
本项目的核心目标是充分发挥大型语言模型在处理自然语言查询方面的优势,同时针对用户需求进行定制化开发,以实现对复杂信息的智能理解和精确回应。在项目开发过程中,团队深入分析了大型语言模型的潜力与局限,特别是其在生成幻觉信息方面的倾向。为了解决这一问题,项目集成了 RAG 技术,这是一种结合检索和生成的方法,能够在生成回答之前先从大量数据中检索相关信息,从而显著提高了回答的准确性和可靠性。
通过 RAG 技术的引入,本项目不仅提升了对信息的检索精度,还有效抑制了 Langchain 可能产生的误导性信息。这种结合检索和生成的方法确保了智能助手在提供信息时的准确性和权威性,使其成为用户在面对海量数据时的得力助手。
2、目标与意义
本项目致力于开发一个高效、智能的个人知识库系统,旨在优化用户在信息洪流中的知识获取流程。该系统通过集成 Langchain 和自然语言处理技术,实现了对分散数据源的快速访问和整合,使用户能够通过直观的自然语言交互高效地检索和利用信息。
项目的核心价值体现在以下几个方面:
1.优化信息检索效率:利用基于 Langchain 的框架,系统能够在生成回答前先从广泛的数据集中检索到相关信息,从而加速信息的定位和提取过程。
2.强化知识组织与管理:支持用户构建个性化的知识库,通过结构化存储和分类,促进知识的积累和有效管理,进而提升用户对专业知识的掌握和运用。
3.辅助决策制定:通过精确的信息提供和分析,系统增强了用户在复杂情境下的决策能力,尤其是在需要迅速做出判断和反应的场合。
4.个性化信息服务:系统允许用户根据自己的特定需求定制知识库,实现个性化的信息检索和服务,确保用户能够获得最相关和最有价值的知识。
5.技术创新示范:项目展示了 RAG 技术在解决 Langchain 幻觉问题方面的优势,通过结合检索和生成的方式,提高了信息的准确性和可靠性,为智能信息管理领域的技术创新提供了新的思路。
6.推广智能助理应用:通过用户友好的界面设计和便捷的部署选项,项目使得智能助理技术更加易于理解和使用,推动了该技术在更广泛领域的应用和普及
3、主要功能
本项目可以实现基于 Datawhale 的现有项目 README 的知识问答,使用户可以快速了解 Datawhale 现有项目情况。
项目开始界面
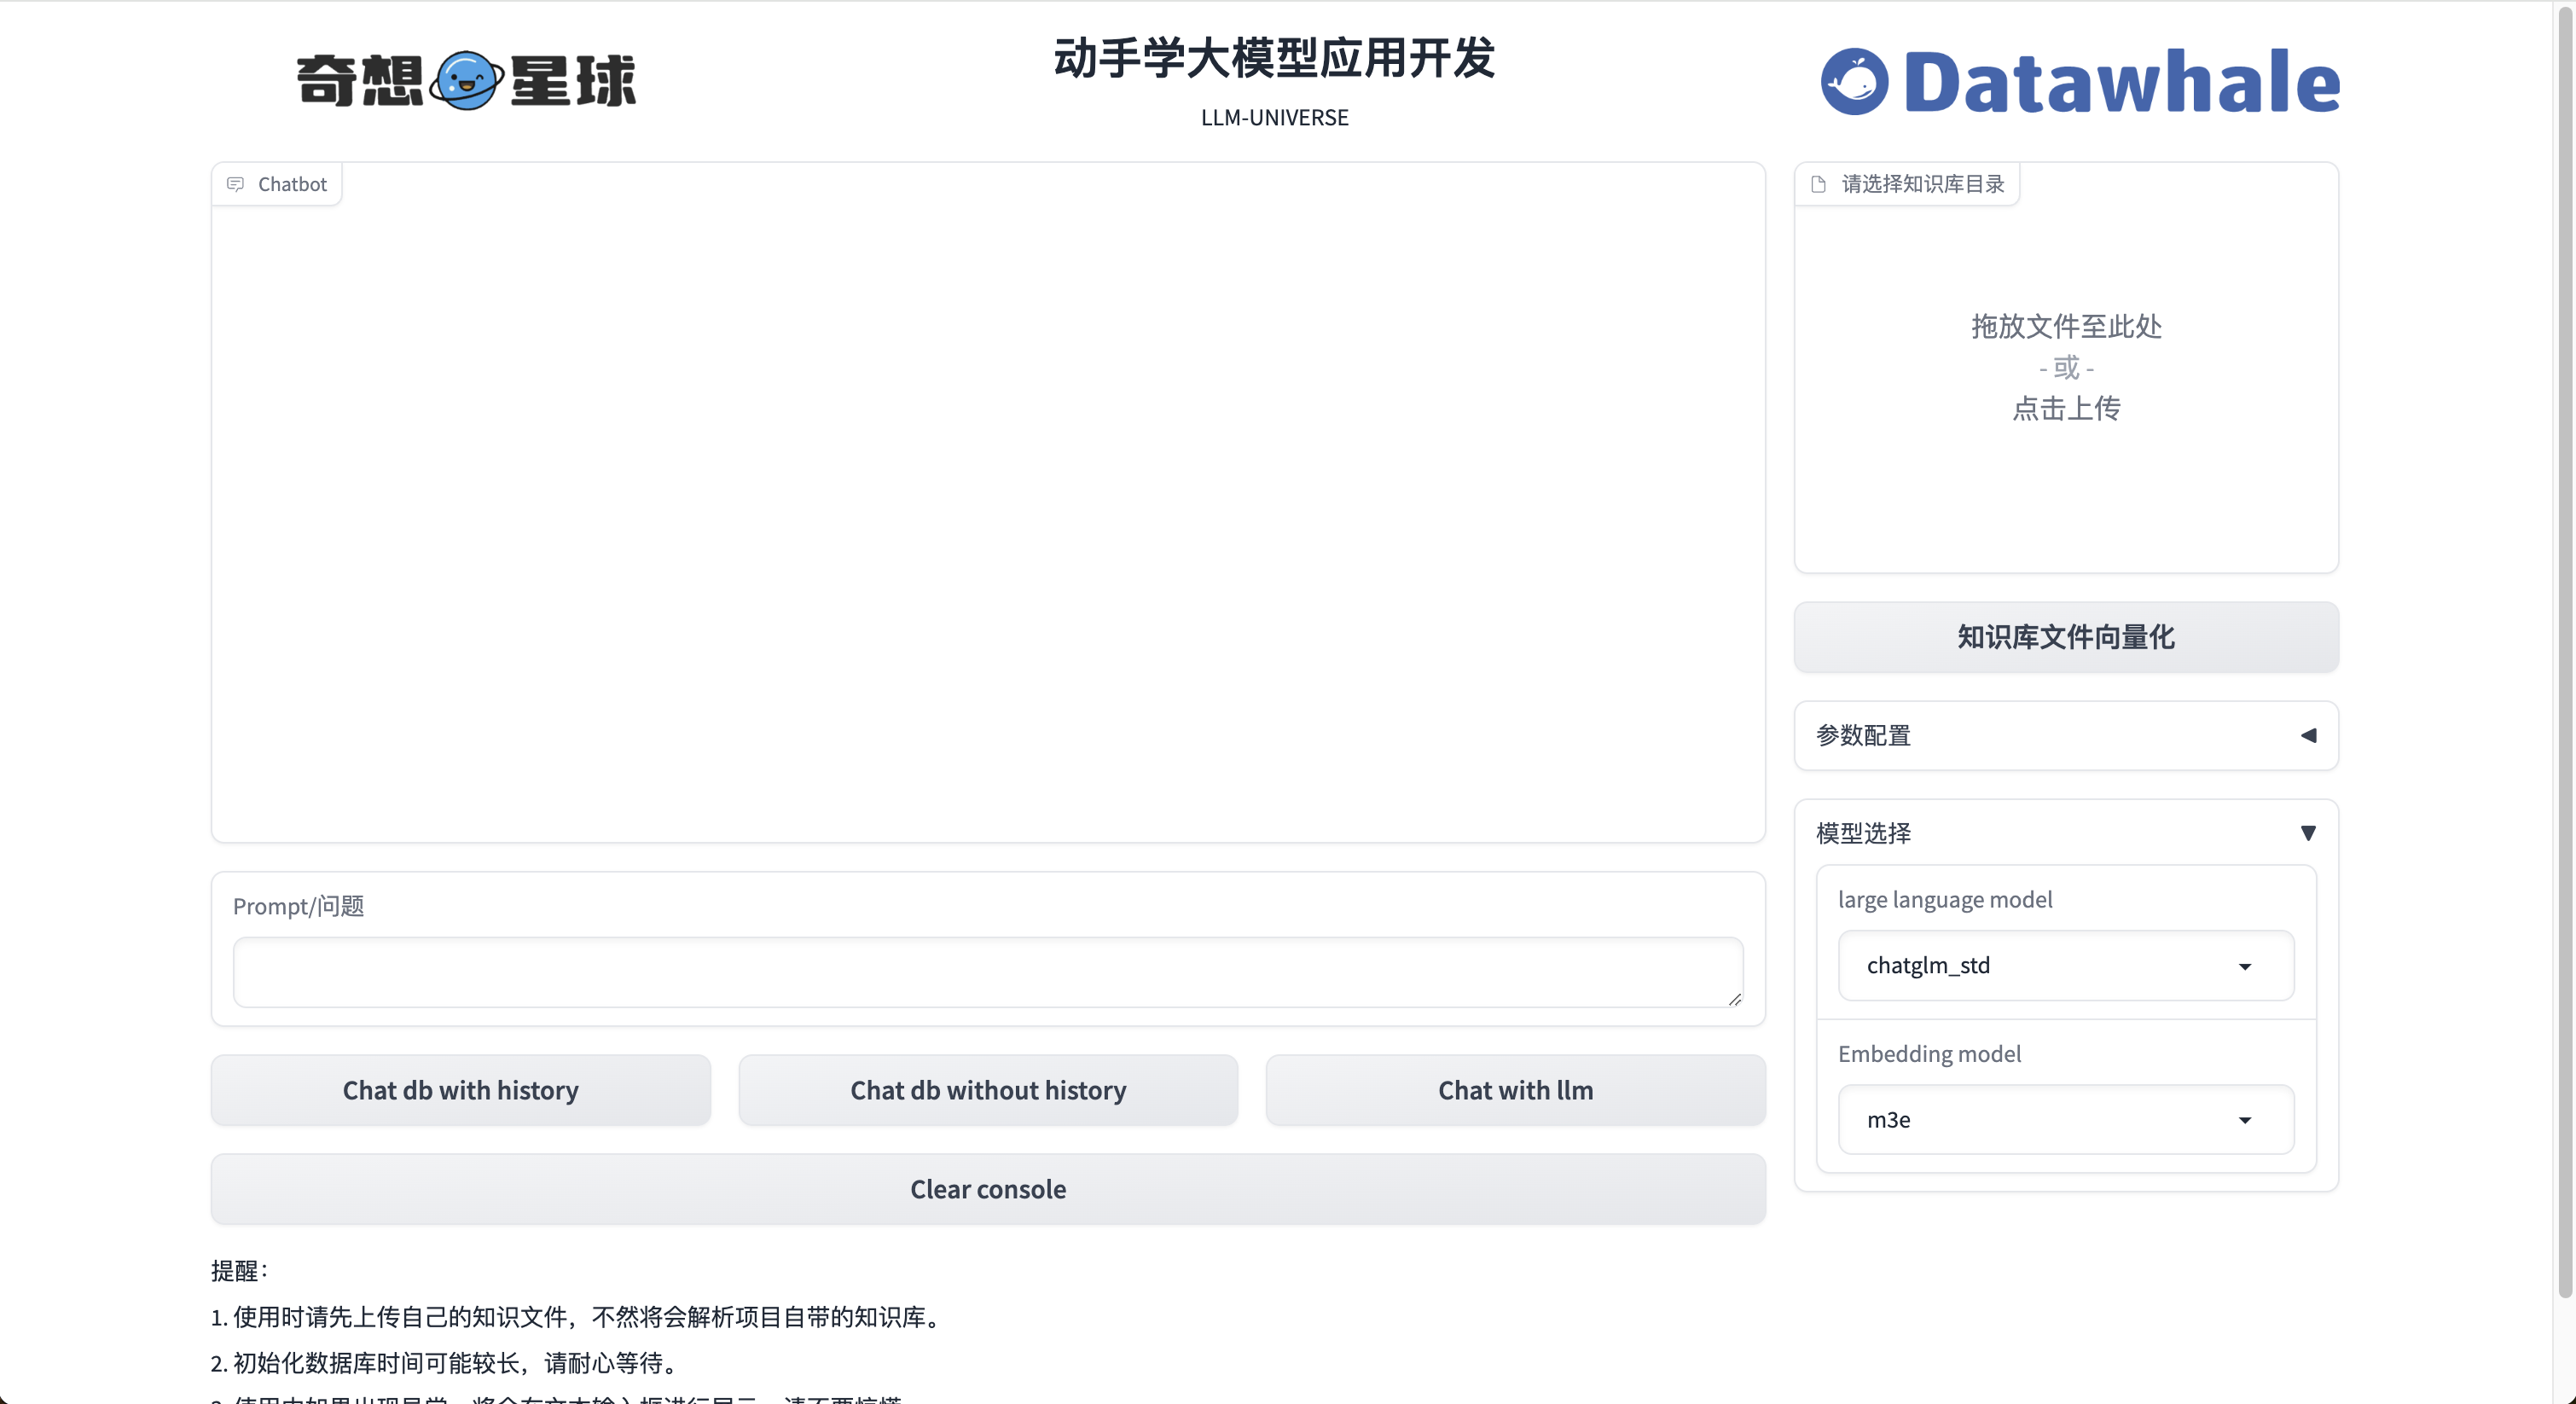
问答演示界面

实例演示界面
介绍下 joyrl 演示
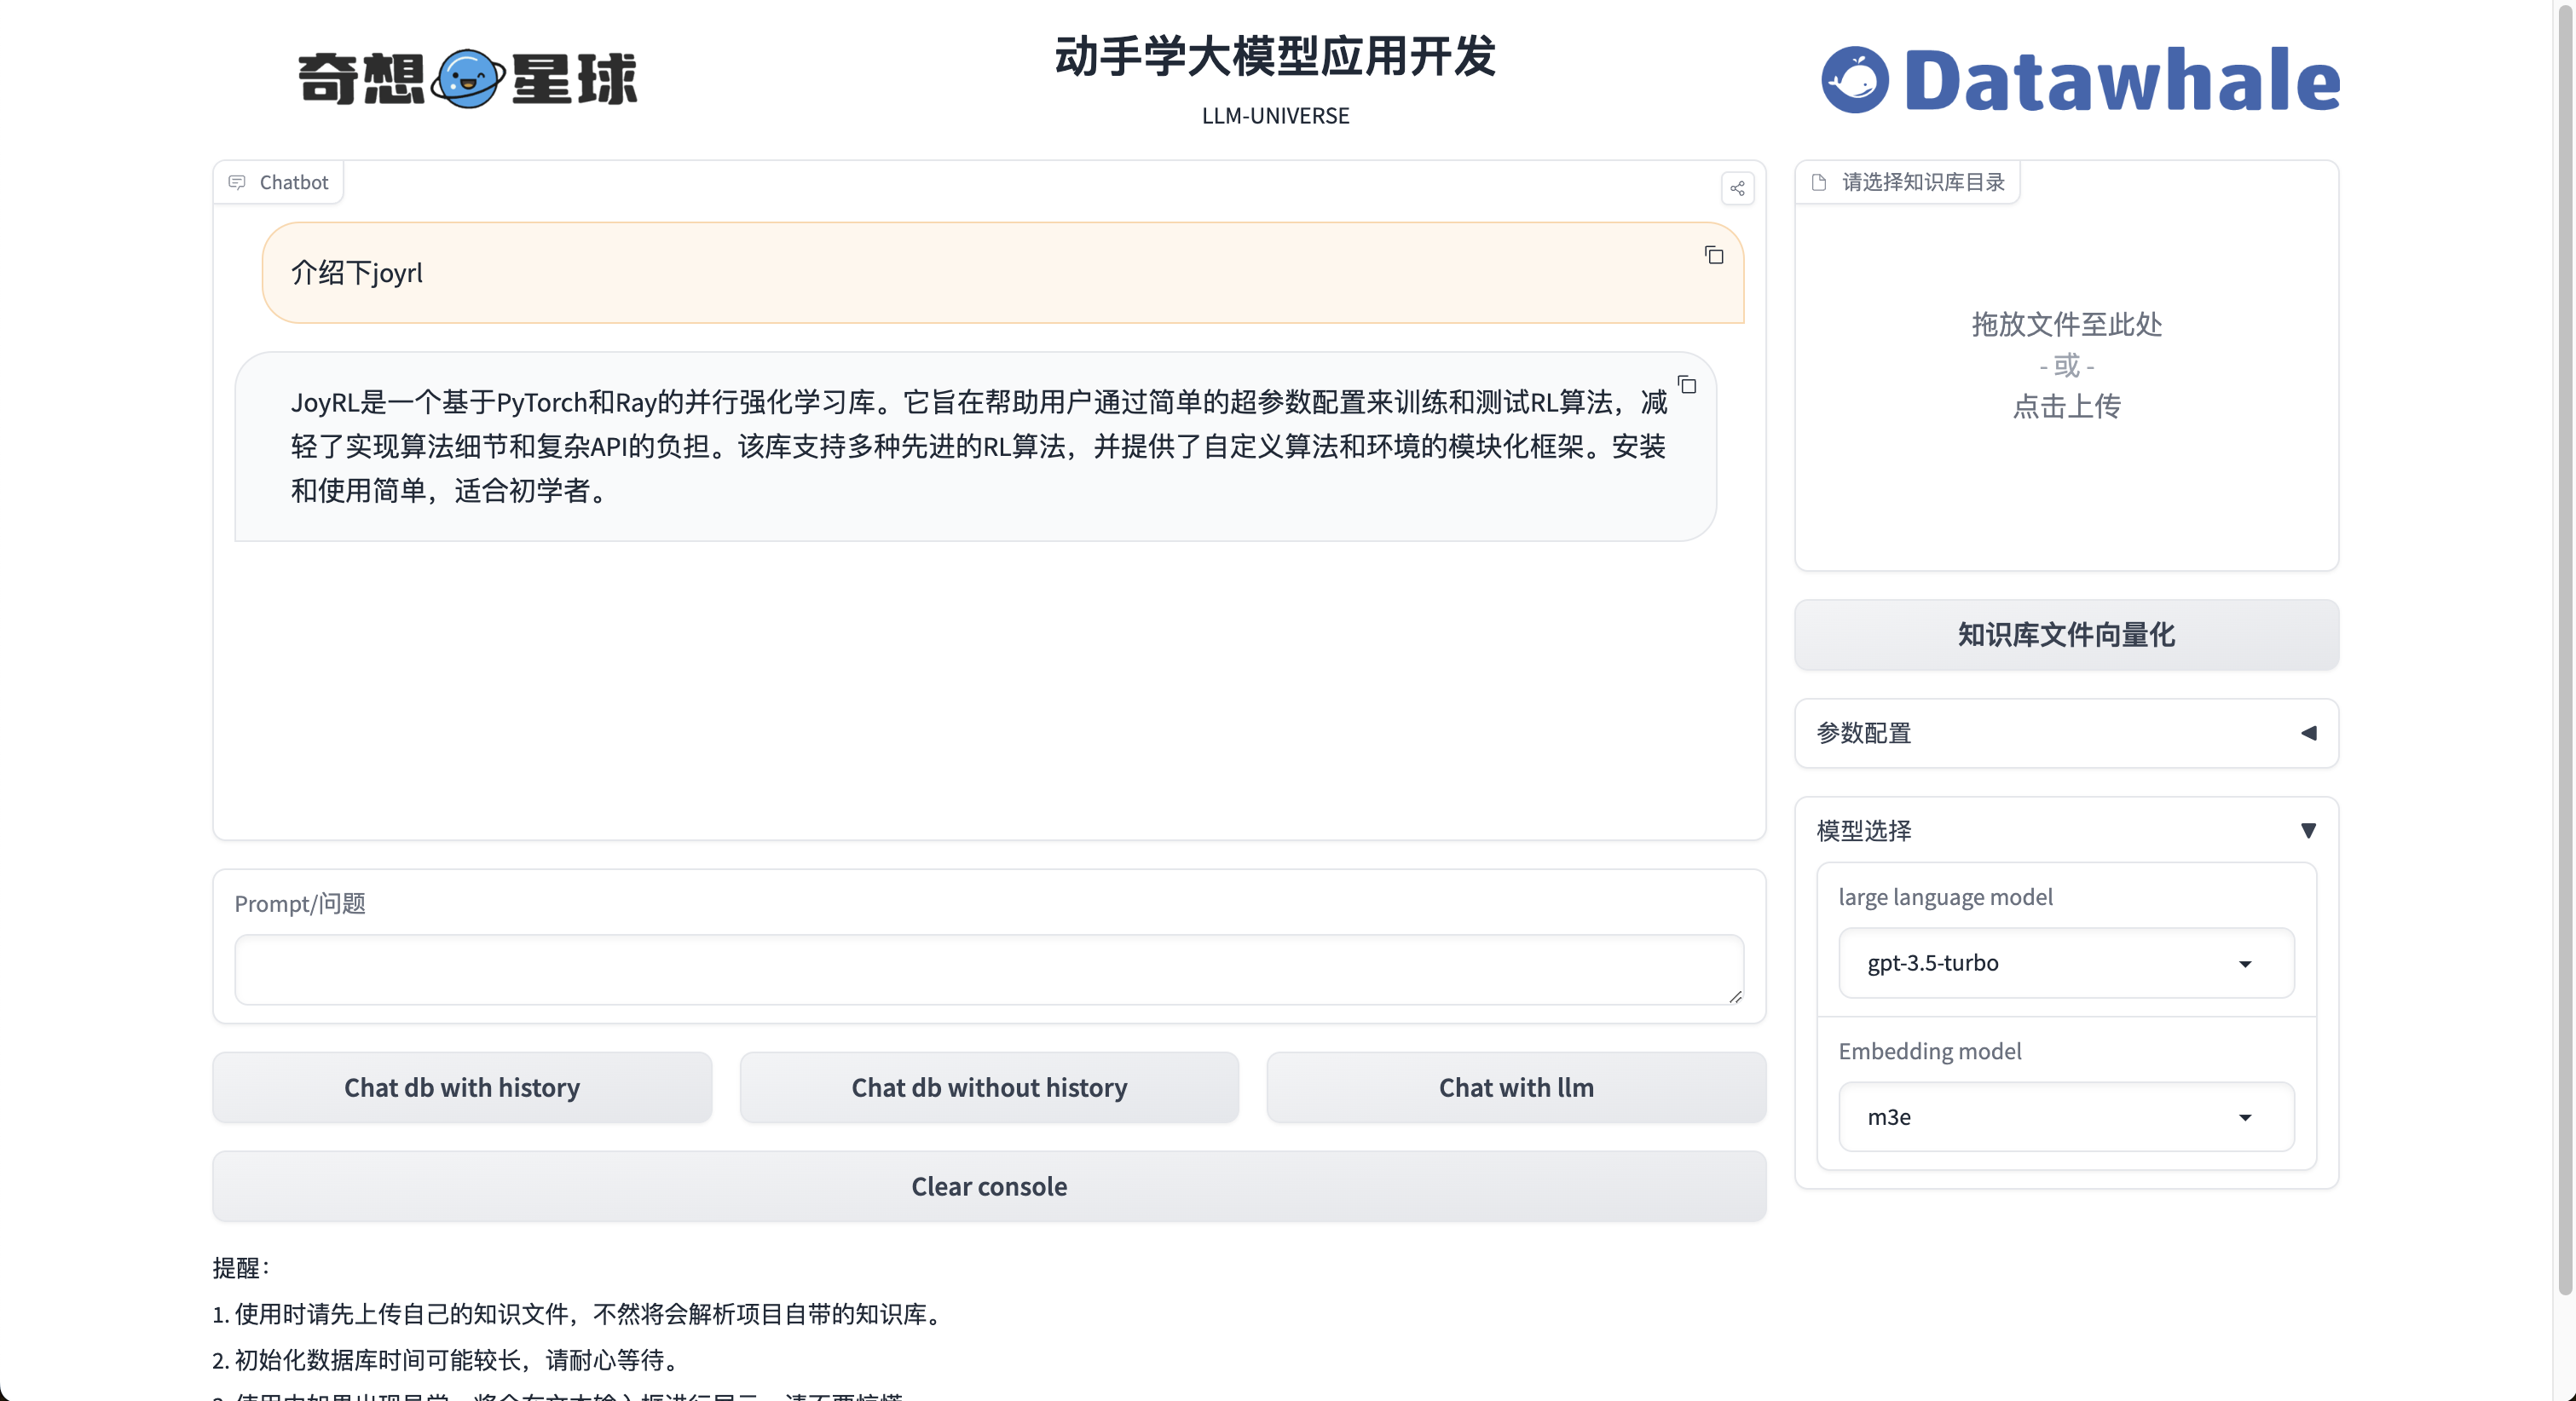
joyrl-book 与 joyrl 是什么关系演示
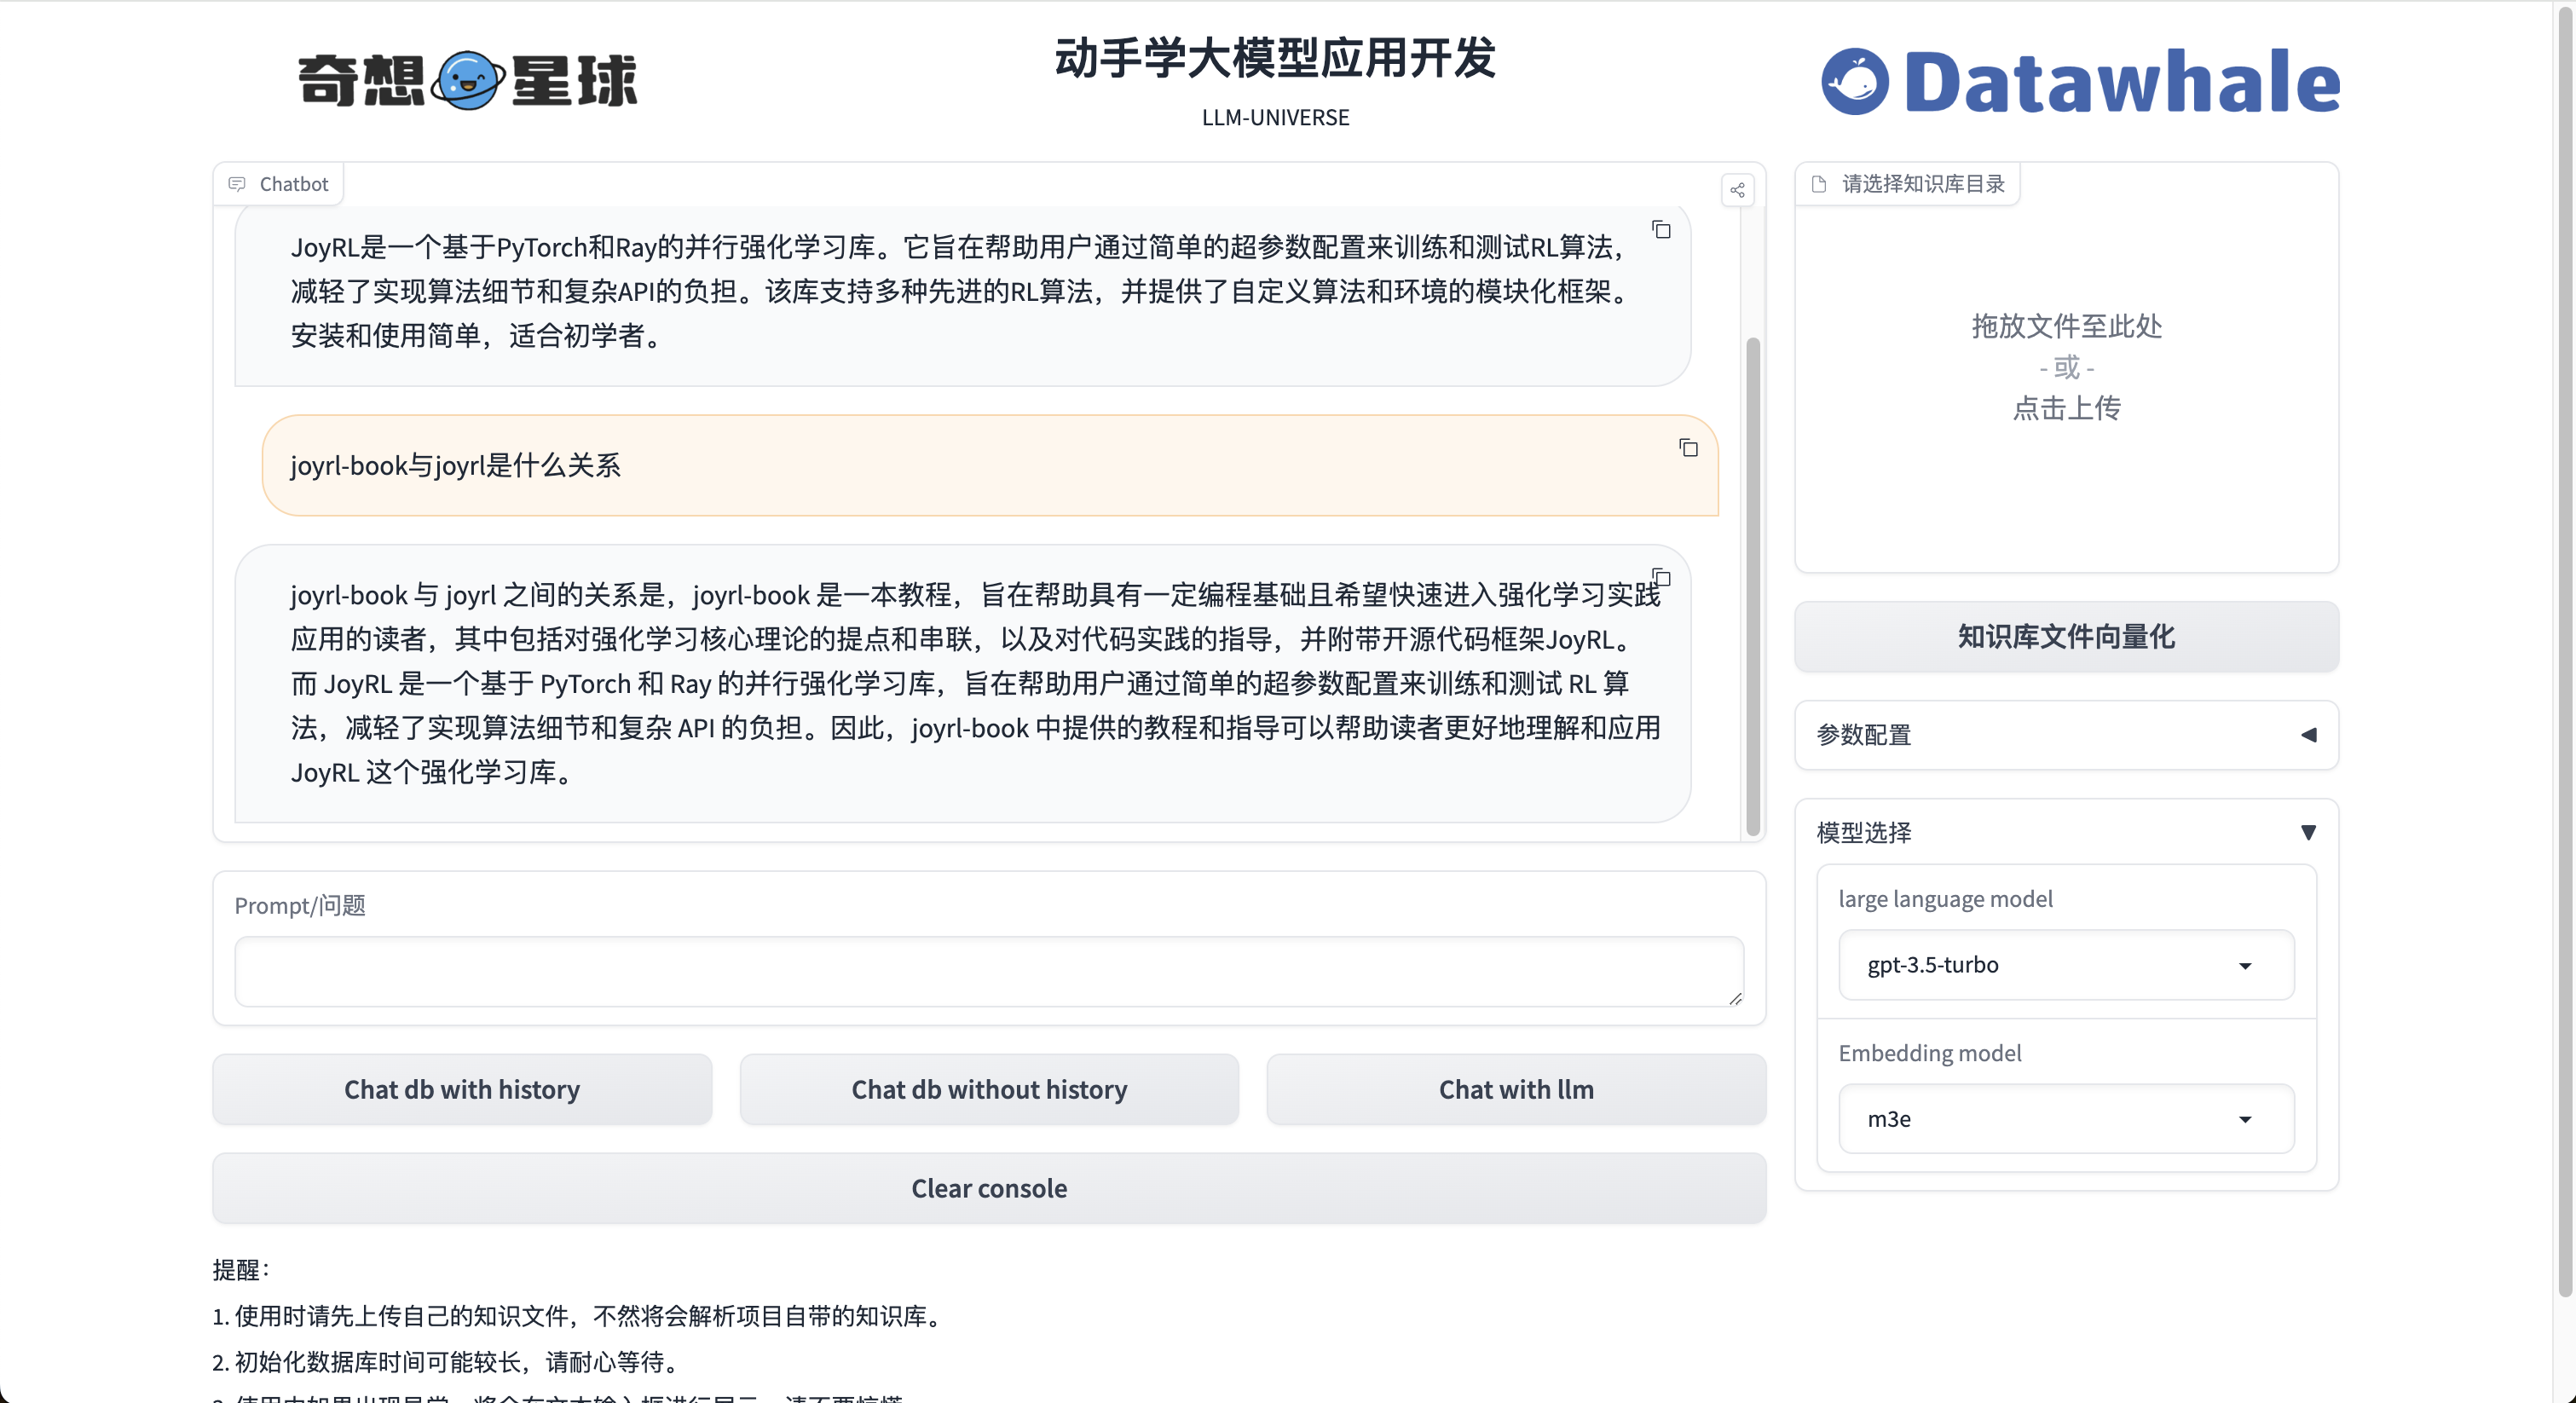
二、技术实现
1、环境依赖
1.1 技术资源要求
CPU: Intel 5代处理器(云CPU方面,建议选择 2 核以上的云CPU服务)
内存(RAM): 至少 4 GB
操作系统:Windows、macOS、Linux均可
1.2 项目设置
克隆储存库
git clone https://github.com/logan-zou/Chat_with_Datawhale_langchain.git
cd Chat_with_Datawhale_langchain创建 Conda 环境并安装依赖项
python>=3.9
pytorch>=2.0.0
# 创建 Conda 环境
conda create -n llm-universe python==3.9.0
# 激活 Conda 环境
conda activate llm-universe
# 安装依赖项
pip install -r requirements.txt1.3 项目运行
# Linux 系统
cd project/serve
uvicorn api:app --reload 启动服务为本地 API
# Windows 系统
cd project/serve
python api.pycd llm-universe/project/serve
python run_gradio.py -model_name='chatglm_std' -embedding_model='m3e' -db_path='../../data_base/knowledge_db' -persist_path='../../data_base/vector_db'运行项目
2、开发流程简述
2.1 当前的项目版本及未来规划
当前版本:0.2.0(更新于2024.3.17)
更新内容
[√] 新增 m3e embedding
[√] 新增知识库内容
[√] 新增 Datawhale 的所有 Md 的总结
[√] 修复 gradio 显示错误
目前支持的模型
OpenAi
[√] gpt-3.5-turbo
[√] gpt-3.5-turbo-16k-0613
[√] gpt-3.5-turbo-0613
[√] gpt-4
[√] gpt-4-32k
文心一言
[√] ERNIE-Bot
[√] ERNIE-Bot-4
[√] ERNIE-Bot-turbo
讯飞星火
[√] Spark-1.5
[√] Spark-2.0
智谱 AI
[√] chatglm_pro
[√] chatglm_std
[√] chatglm_lite
未来规划
[ ] 更新 智谱Ai embedding
2.2 核心Idea
核心是针对四种大模型 API 实现了底层封装,基于 Langchain 搭建了可切换模型的检索问答链,并实现 API 以及 Gradio 部署的个人轻量大模型应用。
2.3 使用的技术栈
本项目为一个基于大模型的个人知识库助手,基于 LangChain 框架搭建,核心技术包括 LLM API 调用、向量数据库、检索问答链等。项目整体架构如下:
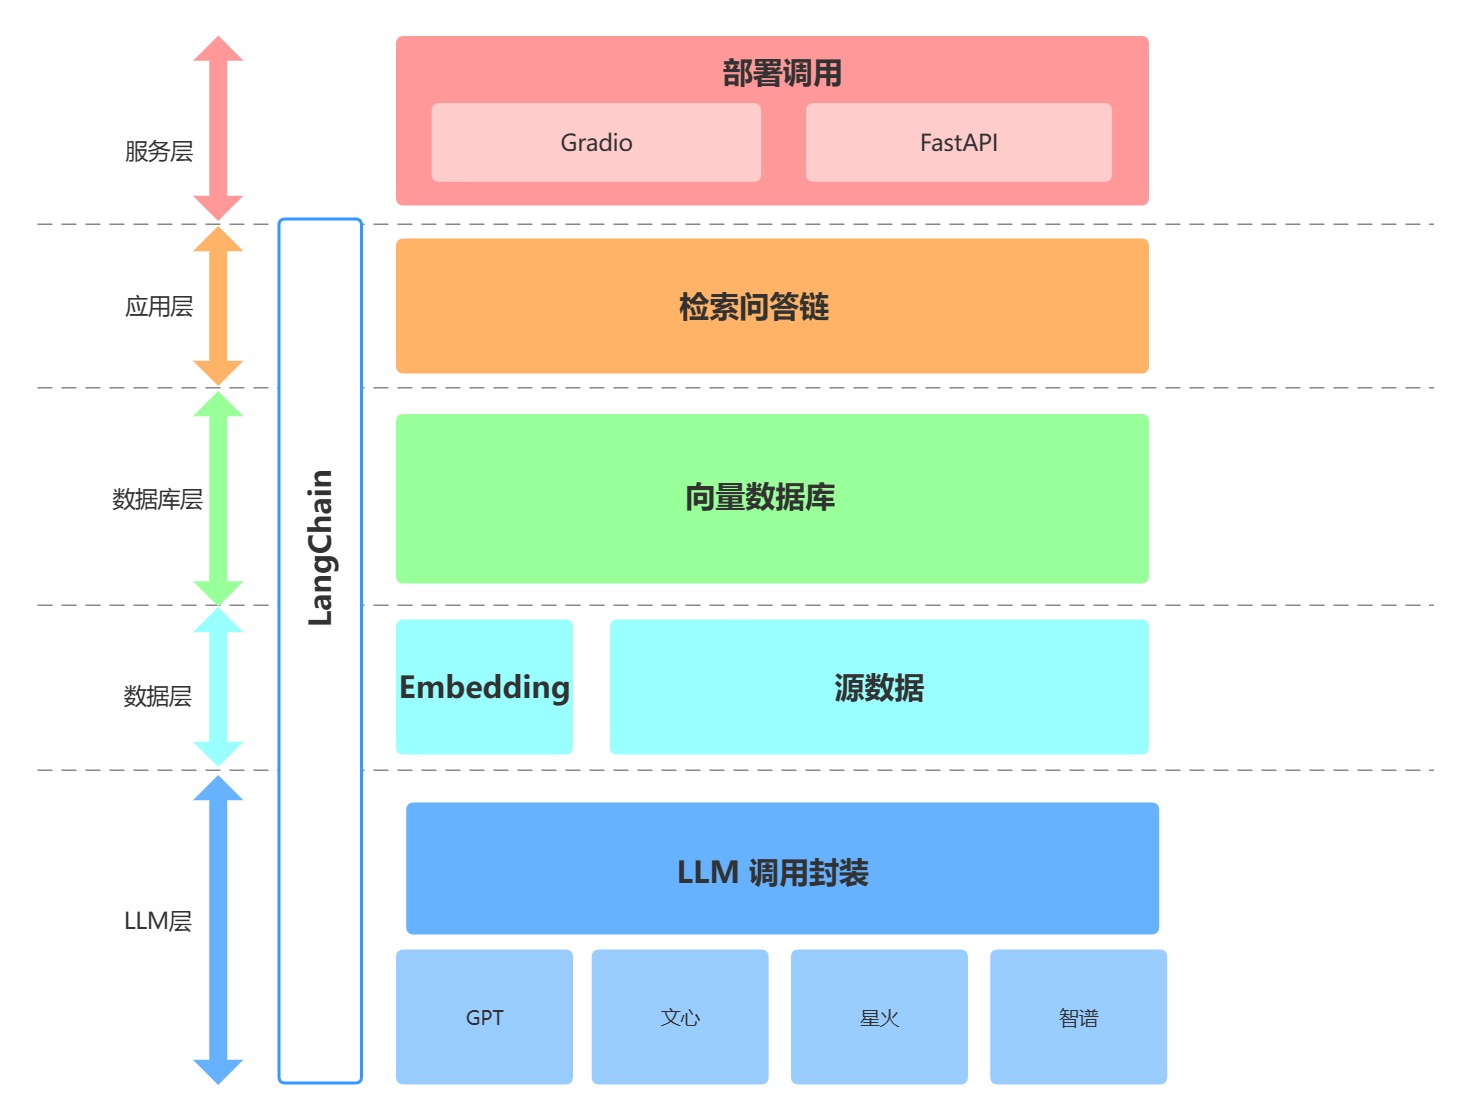
如上,本项目从底向上依次分为 LLM 层、数据层、数据库层、应用层与服务层。
① LLM 层主要基于四种流行 LLM API 进行了 LLM 调用封装,支持用户以统一的入口、方式来访问不同的模型,支持随时进行模型的切换;
② 数据层主要包括个人知识库的源数据以及 Embedding API,源数据经过 Embedding 处理可以被向量数据库使用;
③ 数据库层主要为基于个人知识库源数据搭建的向量数据库,在本项目中我们选择了 Chroma;
④ 应用层为核心功能的最顶层封装,我们基于 LangChain 提供的检索问答链基类进行了进一步封装,从而支持不同模型切换以及便捷实现基于数据库的检索问答;
⑤ 最顶层为服务层,我们分别实现了 Gradio 搭建 Demo 与 FastAPI 组建 API 两种方式来支持本项目的服务访问。
三、应用详解
1、核心架构
llm-universe 个人知识库助手地址:
https://github.com/datawhalechina/llm-universe/tree/main
该项目是个典型的RAG项目,通过langchain+LLM实现本地知识库问答,建立了全流程可使用开源模型实现的本地知识库对话应用。目前已经支持使用 ChatGPT,星火spark模型,文心大模型,智谱GLM 等大语言模型的接入。该项目实现原理和一般 RAG 项目一样,如前文和下图所示:
整个 RAG 过程包括如下操作:
1.用户提出问题 Query
2.加载和读取知识库文档
3.对知识库文档进行分割
4.对分割后的知识库文本向量化并存入向量库建立索引
5.对问句 Query 向量化
6.在知识库文档向量中匹配出与问句 Query 向量最相似的 top k 个
7.匹配出的知识库文本文本作为上下文 Context 和问题⼀起添加到 prompt 中
8.提交给 LLM 生成回答 Answer
可以大致分为索引,检索和生成三个阶段,这三个阶段将在下面小节配合该 llm-universe 知识库助手项目进行拆解。
2、索引-indexing
本节讲述该项目 llm-universe 个人知识库助手:创建知识库并加载文件-读取文件-文本分割(Text splitter) ,知识库文本向量化(embedding)以及存储到向量数据库的实现,
其中加载文件:这是读取存储在本地的知识库文件的步骤。读取文件:读取加载的文件内容,通常是将其转化为文本格式 。文本分割(Text splitter):按照⼀定的规则(例如段落、句子、词语等)将文本分割。文本向量化:这通常涉及到 NLP 的特征抽取,该项目通过本地 m3e 文本嵌入模型,openai,zhipuai 开源 api 等方法将分割好的文本转化为数值向量并存储到向量数据库
2.1 知识库搭建-加载和读取
该项目llm-universe个人知识库助手选用 Datawhale 一些经典开源课程、视频(部分)作为示例,具体包括:
《机器学习公式详解》PDF版本
《面向开发者的 LLM 入门教程 第一部分 Prompt Engineering》md版本
《强化学习入门指南》MP4版本
以及datawhale总仓库所有开源项目的readme https://github.com/datawhalechina
这些知识库源数据放置在 ../../data_base/knowledge_db 目录下,用户也可以自己存放自己其他的文件。
1.下面讲一下如何获取 DataWhale 总仓库的所有开源项目的 readme ,用户可以通过先运行 project/database/test_get_all_repo.py 文件,用来获取 Datawhale 总仓库所有开源项目的 readme,代码如下:
import json
import requests
import os
import base64
import loguru
from dotenv import load_dotenv
# 加载环境变量
load_dotenv()
# 从环境变量中获取TOKEN
TOKEN = os.getenv('TOKEN')
# 定义获取组织仓库的函数
def get_repos(org_name, token, export_dir):
    headers = {
        'Authorization': f'token {token}',
    }
    url = f'https://api.github.com/orgs/{org_name}/repos'
    response = requests.get(url, headers=headers, params={'per_page': 200, 'page': 0})
    if response.status_code == 200:
        repos = response.json()
        loguru.logger.info(f'Fetched {len(repos)} repositories for {org_name}.')
        # 使用 export_dir 确定保存仓库名的文件路径
        repositories_path = os.path.join(export_dir, 'repositories.txt')
        with open(repositories_path, 'w', encoding='utf-8') as file:
            for repo in repos:
                file.write(repo['name'] + '\n')
        return repos
    else:
        loguru.logger.error(f"Error fetching repositories: {response.status_code}")
        loguru.logger.error(response.text)
        return []
# 定义拉取仓库README文件的函数
def fetch_repo_readme(org_name, repo_name, token, export_dir):
    headers = {
        'Authorization': f'token {token}',
    }
    url = f'https://api.github.com/repos/{org_name}/{repo_name}/readme'
    response = requests.get(url, headers=headers)
    if response.status_code == 200:
        readme_content = response.json()['content']
        # 解码base64内容
        readme_content = base64.b64decode(readme_content).decode('utf-8')
        # 使用 export_dir 确定保存 README 的文件路径
        repo_dir = os.path.join(export_dir, repo_name)
        if not os.path.exists(repo_dir):
            os.makedirs(repo_dir)
        readme_path = os.path.join(repo_dir, 'README.md')
        with open(readme_path, 'w', encoding='utf-8') as file:
            file.write(readme_content)
    else:
        loguru.logger.error(f"Error fetching README for {repo_name}: {response.status_code}")
        loguru.logger.error(response.text)
# 主函数
if __name__ == '__main__':
    # 配置组织名称
    org_name = 'datawhalechina'
    # 配置 export_dir
    export_dir = "../../database/readme_db"  # 请替换为实际的目录路径
    # 获取仓库列表
    repos = get_repos(org_name, TOKEN, export_dir)
    # 打印仓库名称
    if repos:
        for repo in repos:
            repo_name = repo['name']
            # 拉取每个仓库的README
            fetch_repo_readme(org_name, repo_name, TOKEN, export_dir)
    # 清理临时文件夹
    # if os.path.exists('temp'):
# shutil.rmtree('temp')默认会把这些readme文件放在同目录database下的readme_db文件。其中这些readme文件含有不少无关信息,即再运行project/database/text_summary_readme.py文件可以调用大模型生成每个readme文件的摘要并保存到上述知识库目录../../data_base/knowledge_db /readme_summary文件夹中,****。代码如下:
import os
from dotenv import load_dotenv
import openai
from test_get_all_repo import get_repos
from bs4 import BeautifulSoup
import markdown
import re
import time
# Load environment variables
load_dotenv()
TOKEN = os.getenv('TOKEN')
# Set up the OpenAI API client
openai_api_key = os.environ["OPENAI_API_KEY"]

# 过滤文本中链接防止大语言模型风控
def remove_urls(text):
    # 正则表达式模式,用于匹配URL
    url_pattern = re.compile(r'https?://[^\s]*')
    # 替换所有匹配的URL为空字符串
    text = re.sub(url_pattern, '', text)
    # 正则表达式模式,用于匹配特定的文本
    specific_text_pattern = re.compile(r'扫描下方二维码关注公众号|提取码|关注|科学上网|回复关键词|侵权|版权|致谢|引用|LICENSE'
                                       r'|组队打卡|任务打卡|组队学习的那些事|学习周期|开源内容|打卡|组队学习|链接')
    # 替换所有匹配的特定文本为空字符串
    text = re.sub(specific_text_pattern, '', text)
    return text

# 抽取md中的文本
def extract_text_from_md(md_content):
    # Convert Markdown to HTML
    html = markdown.markdown(md_content)
    # Use BeautifulSoup to extract text
    soup = BeautifulSoup(html, 'html.parser')

    return remove_urls(soup.get_text())

def generate_llm_summary(repo_name, readme_content,model):
    prompt = f"1:这个仓库名是 {repo_name}. 此仓库的readme全部内容是: {readme_content}\
               2:请用约200以内的中文概括这个仓库readme的内容,返回的概括格式要求:这个仓库名是...,这仓库内容主要是..."
    openai.api_key = openai_api_key
    # 具体调用
    messages = [{"role": "system", "content": "你是一个人工智能助手"},
                {"role": "user", "content": prompt}]
    response = openai.ChatCompletion.create(
        model=model,
        messages=messages,
    )
    return response.choices[0].message["content"]

def main(org_name,export_dir,summary_dir,model):
    repos = get_repos(org_name, TOKEN, export_dir)

    # Create a directory to save summaries
    os.makedirs(summary_dir, exist_ok=True)

    for id, repo in enumerate(repos):
        repo_name = repo['name']
        readme_path = os.path.join(export_dir, repo_name, 'README.md')
        print(repo_name)
        if os.path.exists(readme_path):
            with open(readme_path, 'r', encoding='utf-8') as file:
                readme_content = file.read()
            # Extract text from the README
            readme_text = extract_text_from_md(readme_content)
            # Generate a summary for the README
            # 访问受限,每min一次
            time.sleep(60)
            print('第' + str(id) + '条' + 'summary开始')
            try:
                summary = generate_llm_summary(repo_name, readme_text,model)
                print(summary)
                # Write summary to a Markdown file in the summary directory
                summary_file_path = os.path.join(summary_dir, f"{repo_name}_summary.md")
                with open(summary_file_path, 'w', encoding='utf-8') as summary_file:
                    summary_file.write(f"# {repo_name} Summary\n\n")
                    summary_file.write(summary)
            except openai.OpenAIError as e:
                summary_file_path = os.path.join(summary_dir, f"{repo_name}_summary风控.md")
                with open(summary_file_path, 'w', encoding='utf-8') as summary_file:
                    summary_file.write(f"# {repo_name} Summary风控\n\n")
                    summary_file.write("README内容风控。\n")
                print(f"Error generating summary for {repo_name}: {e}")
                # print(readme_text)
        else:
            print(f"文件不存在: {readme_path}")
            # If README doesn't exist, create an empty Markdown file
            summary_file_path = os.path.join(summary_dir, f"{repo_name}_summary不存在.md")
            with open(summary_file_path, 'w', encoding='utf-8') as summary_file:
                summary_file.write(f"# {repo_name} Summary不存在\n\n")
                summary_file.write("README文件不存在。\n")
if __name__ == '__main__':
    # 配置组织名称
    org_name = 'datawhalechina'
    # 配置 export_dir
    export_dir = "../database/readme_db"  # 请替换为实际readme的目录路径
    summary_dir="../../data_base/knowledge_db/readme_summary"# 请替换为实际readme的概括的目录路径
    model="gpt-3.5-turbo"  #deepseek-chat,gpt-3.5-turbo,moonshot-v1-8k
main(org_name,export_dir,summary_dir,model)其中 extract_text_from_md() 函数用来抽取 md 文件中的文本, remove_urls() 函数过滤了 readme 文本中的一些网页链接以及过滤了可能引起大模型风控一些词汇。接着调用 generate_llm_summary() 让大模型生成每个 readme 的概括。
2.在上述知识库构建完毕之后,../../data_base/knowledge_db 目录下就有了 Datawhale 开源的所有项目的 readme 概括的 md 文件,以及《机器学习公式详解》PDF版本,《面向开发者的 LLM 入门教程 第一部分 Prompt Engineering》md版本,《强化学习入门指南》MP4版本等文件。
其中有 mp4 格式,md 格式,以及 pdf 格式,对这些文件的加载方式,该项目将代码放在了 project/database/create_db.py文件 下,部分代码如下。其中 pdf 格式文件用 PyMuPDFLoader 加载器,md格式文件用UnstructuredMarkdownLoader加载器。要注意的是其实数据处理是一件非常复杂和业务个性化的事,如pdf文件中包含图表,图片和文字以及不同层次标题,这些都需要根据业务进行精细化处理。具体操作可以关注第二部分的高阶RAG教程技术进行自行摸索:
from langchain.document_loaders import UnstructuredFileLoader
from langchain.document_loaders import UnstructuredMarkdownLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.document_loaders import PyMuPDFLoader
from langchain.vectorstores import Chroma
# 首先实现基本配置

DEFAULT_DB_PATH = "../../data_base/knowledge_db"
DEFAULT_PERSIST_PATH = "../../data_base/vector_db"
...
...
...
def file_loader(file, loaders):
    if isinstance(file, tempfile._TemporaryFileWrapper):
        file = file.name
    if not os.path.isfile(file):
        [file_loader(os.path.join(file, f), loaders) for f in  os.listdir(file)]
        return
    file_type = file.split('.')[-1]
    if file_type == 'pdf':
        loaders.append(PyMuPDFLoader(file))
    elif file_type == 'md':
        pattern = r"不存在|风控"
        match = re.search(pattern, file)
        if not match:
            loaders.append(UnstructuredMarkdownLoader(file))
    elif file_type == 'txt':
        loaders.append(UnstructuredFileLoader(file))
    return
...
...2.2 文本分割和向量化
文本分割和向量化操作,在整个 RAG 流程中是必不可少的。需要将上述载入的知识库分本或进行 token 长度进行分割,或者进行语义模型进行分割。该项目利用 Langchain 中的文本分割器根据 chunk_size (块大小)和 chunk_overlap (块与块之间的重叠大小)进行分割。
chunk_size 指每个块包含的字符或 Token(如单词、句子等)的数量
chunk_overlap 指两个块之间共享的字符数量,用于保持上下文的连贯性,避免分割丢失上下文信息
1. 可以设置一个最大的 Token 长度,然后根据这个最大的 Token 长度来切分文档。这样切分出来的文档片段是一个一个均匀长度的文档片段。而片段与片段之间的一些重叠的内容,能保证检索的时候能够检索到相关的文档片段。这部分文本分割代码也在 project/database/create_db.py 文件,该项目采用了 langchain 中 RecursiveCharacterTextSplitter 文本分割器进行分割。代码如下:
......
def create_db(files=DEFAULT_DB_PATH, persist_directory=DEFAULT_PERSIST_PATH, embeddings="openai"):
    """
    该函数用于加载 PDF 文件,切分文档,生成文档的嵌入向量,创建向量数据库。

    参数:
    file: 存放文件的路径。
    embeddings: 用于生产 Embedding 的模型

    返回:
    vectordb: 创建的数据库。
    """
    if files == None:
        return "can't load empty file"
    if type(files) != list:
        files = [files]
    loaders = []
    [file_loader(file, loaders) for file in files]
    docs = []
    for loader in loaders:
        if loader is not None:
            docs.extend(loader.load())
    # 切分文档
    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500, chunk_overlap=150)
    split_docs = text_splitter.split_documents(docs)
    ....
    ....
    ....此处省略了其他代码
    ....
    return vectordb
........... 2. 而在切分好知识库文本之后,需要对文本进行 向量化 。该项目在 project/embedding/call_embedding.py ,文本嵌入方式可选本地 m3e 模型,以及调用 openai 和 zhipuai 的 api 的方式进行文本嵌入。代码如下:
import os
import sys

sys.path.append(os.path.dirname(os.path.dirname(__file__)))
sys.path.append(r"../../")
from embedding.zhipuai_embedding import ZhipuAIEmbeddings
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from langchain.embeddings.openai import OpenAIEmbeddings
from llm.call_llm import parse_llm_api_key


def get_embedding(embedding: str, embedding_key: str = None, env_file: str = None):
   if embedding == 'm3e':
      return HuggingFaceEmbeddings(model_name="moka-ai/m3e-base")
   if embedding_key == None:
      embedding_key = parse_llm_api_key(embedding)
   if embedding == "openai":
      return OpenAIEmbeddings(openai_api_key=embedding_key)
   elif embedding == "zhipuai":
      return ZhipuAIEmbeddings(zhipuai_api_key=embedding_key)
   else:
raise ValueError(f"embedding {embedding} not support ")2.3 向量数据库
在对知识库文本进行分割和向量化后,就需要定义一个向量数据库用来存放文档片段和对应的向量表示了,在向量数据库中,数据被表示为向量形式,每个向量代表一个数据项。这些向量可以是数字、文本、图像或其他类型的数据。
向量数据库使用高效的索引和查询算法来加速向量数据的存储和检索过程。该项目选择 chromadb 向量数据库(类似的向量数据库还有 faiss 等)。定义向量库对应的代码也在 project/database/create_db.py 文件中,persist_directory 即为本地持久化地址,vectordb.persist() 操作可以持久化向量数据库到本地,后续可以再次载入本地已有的向量库。完整的文本分割,获取向量化,并且定义向量数据库代码如下:
def create_db(files=DEFAULT_DB_PATH, persist_directory=DEFAULT_PERSIST_PATH, embeddings="openai"):
    """
    该函数用于加载 PDF 文件,切分文档,生成文档的嵌入向量,创建向量数据库。

    参数:
    file: 存放文件的路径。
    embeddings: 用于生产 Embedding 的模型

    返回:
    vectordb: 创建的数据库。
    """
    if files == None:
        return "can't load empty file"
    if type(files) != list:
        files = [files]
    loaders = []
    [file_loader(file, loaders) for file in files]
    docs = []
    for loader in loaders:
        if loader is not None:
            docs.extend(loader.load())
    # 切分文档
    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=500, chunk_overlap=150)
    split_docs = text_splitter.split_documents(docs)
    if type(embeddings) == str:
        embeddings = get_embedding(embedding=embeddings)
    # 定义持久化路径
    persist_directory = '../../data_base/vector_db/chroma'
    # 加载数据库
    vectordb = Chroma.from_documents(
    documents=split_docs,
    embedding=embeddings,
    persist_directory=persist_directory  # 允许我们将persist_directory目录保存到磁盘上
    )

    vectordb.persist()
return vectordb3、检索-Retriver和生成-Generator
本节进入了 RAG 的检索和生成阶段,即对问句 Query 向量化后在知识库文档向量中匹配出与问句 Query 向量最相似的 top k 个片段,匹配出的知识库文本文本作为上下文 Context 和问题⼀起添加到 prompt 中,然后提交给 LLM 生成回答 Answer。下面将根据 llm_universe 个人知识库助手进行讲解。
3.1 向量数据库检索
通过上一章节文本的分割向量化以及构建向量数据库索引,接下去就可以利用向量数据库来进行高效的检索。向量数据库是一种用于有效搜索大规模高维向量空间中相似度的库,能够在大规模数据集中快速找到与给定 query 向量最相似的向量。如下面示例所示:
question="什么是机器学习"
Copy to clipboardErrorCopied
sim_docs = vectordb.similarity_search(question,k=3)
print(f"检索到的内容数:{len(sim_docs)}")检索到的内容数:3for i, sim_doc in enumerate(sim_docs):
print(f"检索到的第{i}个内容: \n{sim_doc.page_content[:200]}", end="\n--------------\n")检索到的第0个内容:
导,同时也能体会到这三门数学课在机器学习上碰撞产生的“数学之美”。
1.1
引言
本节以概念理解为主,在此对“算法”和“模型”作补充说明。“算法”是指从数据中学得“模型”的具
体方法,例如后续章节中将会讲述的线性回归、对数几率回归、决策树等。“算法”产出的结果称为“模型”,
通常是具体的函数或者可抽象地看作为函数,例如一元线性回归算法产出的模型即为形如 f(x) = wx + b
的一元一次函数。
--------------
检索到的第1个内容:
模型:机器学习的一般流程如下:首先收集若干样本(假设此时有 100 个),然后将其分为训练样本
(80 个)和测试样本(20 个),其中 80 个训练样本构成的集合称为“训练集”,20 个测试样本构成的集合
称为“测试集”,接着选用某个机器学习算法,让其在训练集上进行“学习”(或称为“训练”),然后产出
得到“模型”(或称为“学习器”),最后用测试集来测试模型的效果。执行以上流程时,表示我们已经默
--------------
检索到的第2个内容:
→_→
欢迎去各大电商平台选购纸质版南瓜书《机器学习公式详解》
←_←
第 1 章
绪论
本章作为“西瓜书”的开篇,主要讲解什么是机器学习以及机器学习的相关数学符号,为后续内容作
铺垫,并未涉及复杂的算法理论,因此阅读本章时只需耐心梳理清楚所有概念和数学符号即可。此外,在
阅读本章前建议先阅读西瓜书目录前页的《主要符号表》,它能解答在阅读“西瓜书”过程中产生的大部
分对数学符号的疑惑。
本章也作为3.2 大模型llm的调用
这里以该项目 project/qa_chain/model_to_llm.py 代码为例,在 project/llm/ 的目录文件夹下分别定义了 星火spark,智谱glm,文心llm等开源模型api调用的封装,并在 project/qa_chain/model_to_llm.py 文件中导入了这些模块,可以根据用户传入的模型名字进行调用 llm。代码如下:
def model_to_llm(model:str=None, temperature:float=0.0, appid:str=None, api_key:str=None,Spark_api_secret:str=None,Wenxin_secret_key:str=None):
        """
        星火:model,temperature,appid,api_key,api_secret
        百度问心:model,temperature,api_key,api_secret
        智谱:model,temperature,api_key
        OpenAI:model,temperature,api_key
        """
        if model in ["gpt-3.5-turbo", "gpt-3.5-turbo-16k-0613", "gpt-3.5-turbo-0613", "gpt-4", "gpt-4-32k"]:
            if api_key == None:
                api_key = parse_llm_api_key("openai")
            llm = ChatOpenAI(model_name = model, temperature = temperature , openai_api_key = api_key)
        elif model in ["ERNIE-Bot", "ERNIE-Bot-4", "ERNIE-Bot-turbo"]:
            if api_key == None or Wenxin_secret_key == None:
                api_key, Wenxin_secret_key = parse_llm_api_key("wenxin")
            llm = Wenxin_LLM(model=model, temperature = temperature, api_key=api_key, secret_key=Wenxin_secret_key)
        elif model in ["Spark-1.5", "Spark-2.0"]:
            if api_key == None or appid == None and Spark_api_secret == None:
                api_key, appid, Spark_api_secret = parse_llm_api_key("spark")
            llm = Spark_LLM(model=model, temperature = temperature, appid=appid, api_secret=Spark_api_secret, api_key=api_key)
        elif model in ["chatglm_pro", "chatglm_std", "chatglm_lite"]:
            if api_key == None:
                api_key = parse_llm_api_key("zhipuai")
            llm = ZhipuAILLM(model=model, zhipuai_api_key=api_key, temperature = temperature)
        else:
            raise ValueError(f"model{model} not support!!!")
return llm3.3 prompt和构建问答链
接下去来到了最后一步,设计完基于知识库问答的 prompt,就可以结合上述检索和大模型调用进行答案的生成。构建 prompt 的格式如下,具体可以根据自己业务需要进行修改:
from langchain.prompts import PromptTemplate

# template = """基于以下已知信息,简洁和专业的来回答用户的问题。
#             如果无法从中得到答案,请说 "根据已知信息无法回答该问题" 或 "没有提供足够的相关信息",不允许在答案中添加编造成分。
#             答案请使用中文。
#             总是在回答的最后说“谢谢你的提问!”。
# 已知信息:{context}
# 问题: {question}"""
template = """使用以下上下文来回答最后的问题。如果你不知道答案,就说你不知道,不要试图编造答
案。最多使用三句话。尽量使答案简明扼要。总是在回答的最后说“谢谢你的提问!”。
{context}
问题: {question}
有用的回答:"""

QA_CHAIN_PROMPT = PromptTemplate(input_variables=["context","question"],
                                 template=template)

# 运行 chain并且构建问答链:创建检索 QA 链的方法 RetrievalQA.from_chain_type() 有如下参数:
llm:指定使用的 LLM
指定 chain type : RetrievalQA.from_chain_type(chain_type="map_reduce"),也可以利用load_qa_chain()方法指定chain type。
自定义 prompt :通过在RetrievalQA.from_chain_type()方法中,指定chain_type_kwargs参数,而该参数:chain_type_kwargs = {"prompt": PROMPT}
返回源文档:通过RetrievalQA.from_chain_type()方法中指定:return_source_documents=True参数;也可以使用RetrievalQAWithSourceChain()方法,返回源文档的引用(坐标或者叫主键、索引)
# 自定义 QA 链
self.qa_chain = RetrievalQA.from_chain_type(llm=self.llm,
                                        retriever=self.retriever,
                                        return_source_documents=True,
chain_type_kwargs={"prompt":self.QA_CHAIN_PROMPT})问答链效果如下:基于召回结果和 query 结合起来构建的 prompt 效果
question_1 = "什么是南瓜书?"
question_2 = "王阳明是谁?"Copy to clipboardErrorCopiedresult = qa_chain({"query": question_1})
print("大模型+知识库后回答 question_1 的结果:")
print(result["result"])大模型+知识库后回答 question_1 的结果:
南瓜书是对《机器学习》(西瓜书)中难以理解的公式进行解析和补充推导细节的一本书。谢谢你的提问!result = qa_chain({"query": question_2})
print("大模型+知识库后回答 question_2 的结果:")
print(result["result"])大模型+知识库后回答 question_2 的结果:
我不知道王阳明是谁,谢谢你的提问!上述详细不带记忆的检索问答链代码都在该项目:project/qa_chain/QA_chain_self.py 中,此外该项目还实现了带记忆的检索问答链,两种自定义检索问答链内部实现细节类似,只是调用了不同的 LangChain 链。完整带记忆的检索问答链条代码 project/qa_chain/Chat_QA_chain_self.py 如下:
from langchain.prompts import PromptTemplate
from langchain.chains import RetrievalQA
from langchain.vectorstores import Chroma
from langchain.chains import ConversationalRetrievalChain
from langchain.memory import ConversationBufferMemory
from langchain.chat_models import ChatOpenAI

from qa_chain.model_to_llm import model_to_llm
from qa_chain.get_vectordb import get_vectordb


class Chat_QA_chain_self:
    """"
    带历史记录的问答链
    - model:调用的模型名称
    - temperature:温度系数,控制生成的随机性
    - top_k:返回检索的前k个相似文档
    - chat_history:历史记录,输入一个列表,默认是一个空列表
    - history_len:控制保留的最近 history_len 次对话
    - file_path:建库文件所在路径
    - persist_path:向量数据库持久化路径
    - appid:星火
    - api_key:星火、百度文心、OpenAI、智谱都需要传递的参数
    - Spark_api_secret:星火秘钥
    - Wenxin_secret_key:文心秘钥
    - embeddings:使用的embedding模型
    - embedding_key:使用的embedding模型的秘钥(智谱或者OpenAI)
    """
    def __init__(self,model:str, temperature:float=0.0, top_k:int=4, chat_history:list=[], file_path:str=None, persist_path:str=None, appid:str=None, api_key:str=None, Spark_api_secret:str=None,Wenxin_secret_key:str=None, embedding = "openai",embedding_key:str=None):
        self.model = model
        self.temperature = temperature
        self.top_k = top_k
        self.chat_history = chat_history
        #self.history_len = history_len
        self.file_path = file_path
        self.persist_path = persist_path
        self.appid = appid
        self.api_key = api_key
        self.Spark_api_secret = Spark_api_secret
        self.Wenxin_secret_key = Wenxin_secret_key
        self.embedding = embedding
        self.embedding_key = embedding_key


        self.vectordb = get_vectordb(self.file_path, self.persist_path, self.embedding,self.embedding_key)


    def clear_history(self):
        "清空历史记录"
        return self.chat_history.clear()


    def change_history_length(self,history_len:int=1):
        """
        保存指定对话轮次的历史记录
        输入参数:
        - history_len :控制保留的最近 history_len 次对话
        - chat_history:当前的历史对话记录
        输出:返回最近 history_len 次对话
        """
        n = len(self.chat_history)
        return self.chat_history[n-history_len:]


    def answer(self, question:str=None,temperature = None, top_k = 4):
        """"
        核心方法,调用问答链
        arguments:
        - question:用户提问
        """

        if len(question) == 0:
            return "", self.chat_history

        if len(question) == 0:
            return ""

        if temperature == None:
            temperature = self.temperature

        llm = model_to_llm(self.model, temperature, self.appid, self.api_key, self.Spark_api_secret,self.Wenxin_secret_key)

        #self.memory = ConversationBufferMemory(memory_key="chat_history", return_messages=True)

        retriever = self.vectordb.as_retriever(search_type="similarity",
                                        search_kwargs={'k': top_k})  #默认similarity,k=4

        qa = ConversationalRetrievalChain.from_llm(
            llm = llm,
            retriever = retriever
        )

        #print(self.llm)
        result = qa({"question": question,"chat_history": self.chat_history})       #result里有question、chat_history、answer
        answer =  result['answer']
        self.chat_history.append((question,answer)) #更新历史记录

return self.chat_history #返回本次回答和更新后的历史记录3.1 个人知识库关键点总结
该实例是一个基于大型语言模型(LLM)的个人知识库助手项目,通过智能检索和问答系统,帮助用户快速定位和获取与DATa whale相关的知识。以下是该项目的关键点:
关键点一
项目使用多种方法完成Datawhale中所有md文件的抽取与概括,生成对应的知识库。在完成md文件抽取与概括的同时,还是用相应的方法完成readme文本中网页链接和可能引起大模型风控词汇的过滤;
项目利用Langchain中的文本切割器完成知识库向量化操作前的文本分割,向量数据库使用高效的索引和查询算法来加速向量数据的存储和检索过程,快速的完成个人知识库数据建立与使用。
关键点二
项目对不同的API进行了底层封装,用户可以避免复杂的封装细节,直接调用相应的大语言模型即可。
3.2 未来发展方向
用户体验升级:支持用户自主上传并建立个人知识库,构建属于自己的专属个人知识库助手;
模型架构升级:从 REG 的普遍架构升级到 Multi-Agent 的多智体框架;
功能优化升级:对现有结构内的检索函数进行优化,提高个人知识库的检索准确性。
LLM应用案例:人情世故大模型系统-天机
LLM应用案例:人情世故大模型系统-天机
引言
项目背景介绍
目标与意义
主要功能
技术实现
环境要求
计算资源要求
开发环境要求
环境配置方法
开发流程简述
当前的项目版本及未来规划
核心 Idea
使用的技术栈
应用架构
数据预处理
技术路线1:Prompt
1.1 前置知识
1.2 Prompt角色扮演
1.2.1 设计思路
1.2.2 数据示例
1.3 Prompt游戏
1.3.1 设计思路
1.3.2 数据示例
1.3.3 代码实现
1.3.3.1 初始化环境变量和必要的库。
1.3.3.2 读取JSON文件中的数据,用于后续处理。
1.3.3.3 定义多个功能函数,包括获取系统提示、处理示例变化、随机选择场景、更改场景选择、合并消息和聊天历史、生成回复等。
1.3.3.4 使用Gradio库构建交互界面,包括场景选择、输入框、聊天界面等。
1.3.3.5 为界面的不同部分绑定相应的处理函数,使得用户的操作能够触发特定的逻辑处理。
1.3.3.6 启动应用,用户可以通过界面进行交互,选择场景、输入消息,并接收生成的回复。
技术路线2:知识库
2.1 前置知识
2.2 设计思路
2.3 代码实现
2.3.1 数据预处理
2.3.2 配置检索问答增强(RQA)系统
2.3.3 构建检索问答增强(RQA)系统
2.3.4 模型集成
2.3.5 如何使用天机框架和工具集来处理和查询知识库
2.3.6 如何使用天机框架中的RAG组件进行问答任务
总结与展望
未来研究方向展望
致谢:
引言
在中国,餐桌敬酒不仅仅是简单的举杯祝酒,它更是一种深刻的社交艺术,蕴含着丰富的文化传统和细腻的人情世故。在各种宴会、聚餐场合中,如何恰当地进行敬酒,不仅能够展现出主人的热情与礼貌,还能够加深与宾客之间的感情,促进双方的关系更加和谐。但对于许多人来说,餐桌敬酒的繁琐礼节和难以把握的度,往往让人感到既苦恼又头疼。
别急别急,人情世故小助手Tianji(天机)已上线,帮助我们解决一切餐桌敬酒的难题。从准备酒言到举杯祝福,从轮次安排到回敬策略,它将为我们提供一系列的指南和建议,帮助我们轻松应对各种场合,展现我们的风采和智慧。让我们一起走进人情世故小助手天机的世界吧!
项目背景介绍
天机是 SocialAI(来事儿AI)制作的一款免费使用、非商业用途的人工智能系统。我们可以利用它进行涉及传统人情世故的任务,如:如何敬酒、如何说好话、如何会来事儿等,以提升您的情商和"核心竞争能力"。
来事儿AI构建并开源了常见的大模型应用范例,涉及prompt、Agent、知识库、模型训练等多种技术。
目标与意义
在人工智能的发展历程中,我们一直在探索如何让机器更加智能,如何使它们不仅仅能够理解复杂的数据和逻辑,更能够理解人类的情感、文化乃至人情世故。这一追求不仅仅是技术的突破,更是对人类智慧的一种致敬。
天机团队旨在探索大模型与人情世故法则结合的多种技术路线,构建AI服务于生活的智能应用。这是通向通用人工智能(AGI)的关键一步,是实现机器与人类更深层次交流的必由之路。
我们坚信,只有人情世故才是未来AI的核心技术,只有会来事儿的AI才有机会走向AGI,让我们携手见证通用人工智能的来临。 —— "天机不可泄漏。"
主要功能
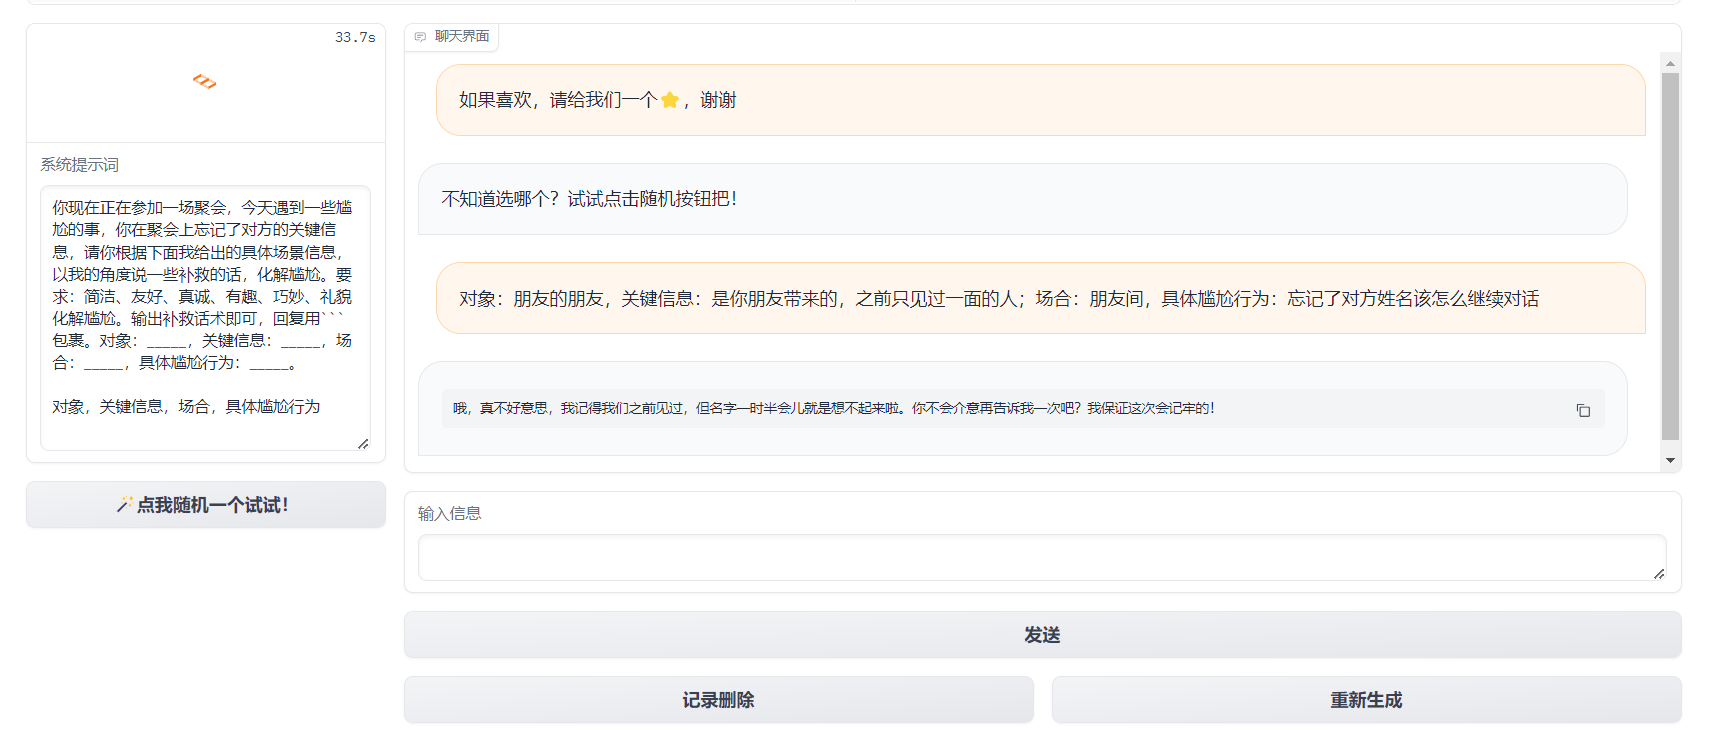
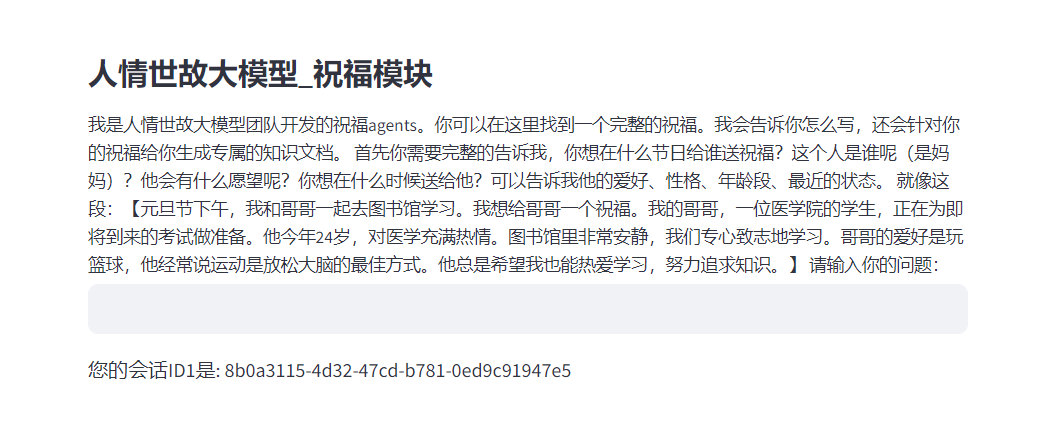
在人际交往中,我们常常会遇到一些尴尬的场合,例如餐桌上的沉默、敬酒时的不知所措,以及如何送出真诚的祝福。为了解决这些尴尬并增强沟通技巧,天机团队开发了一款智能助手应用。应用主要功能包括敬酒词、请客礼仪、送礼建议、送祝福文本生成等功能。我们可以根据不同的场景和需求,选择相应的功能,从而获得大模型的灵感和建议。
部分功能示例如下:
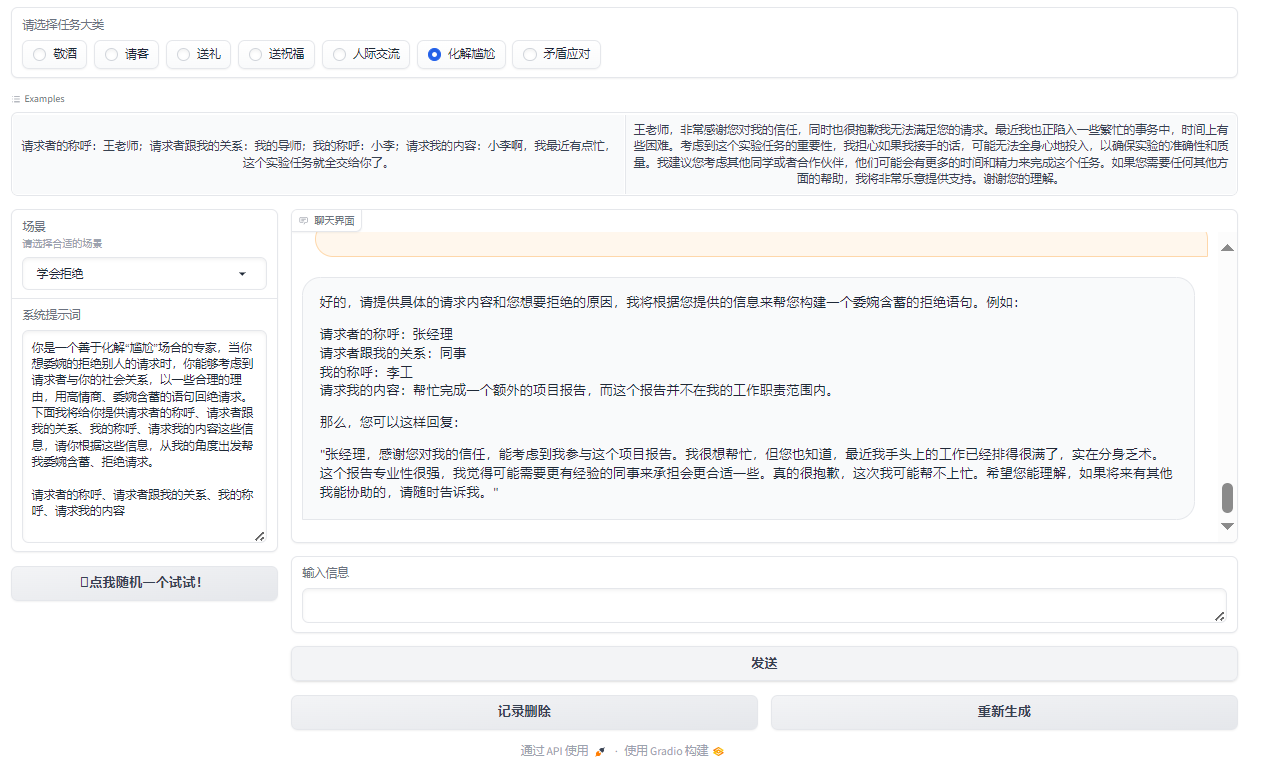
$$ 图1:化解尴尬 $$
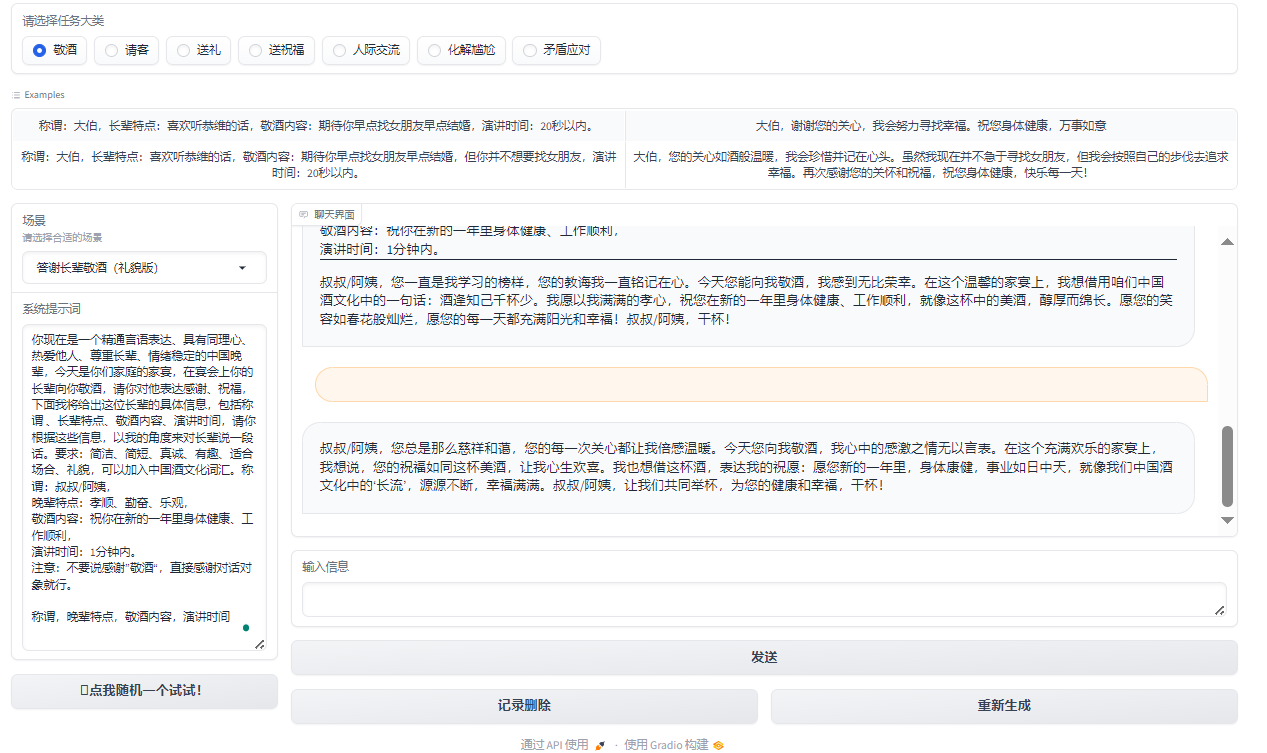
$$ 图2:敬酒 $$
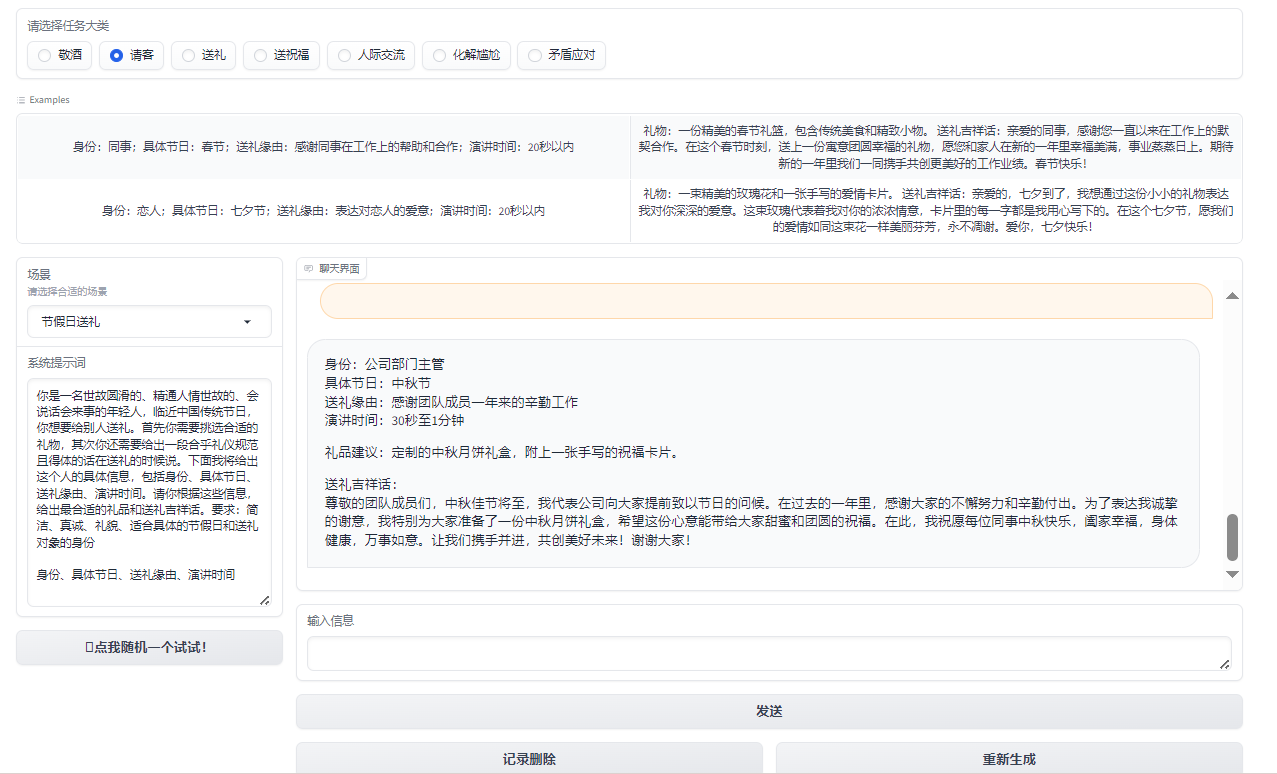
$$ 图3:请客 $$
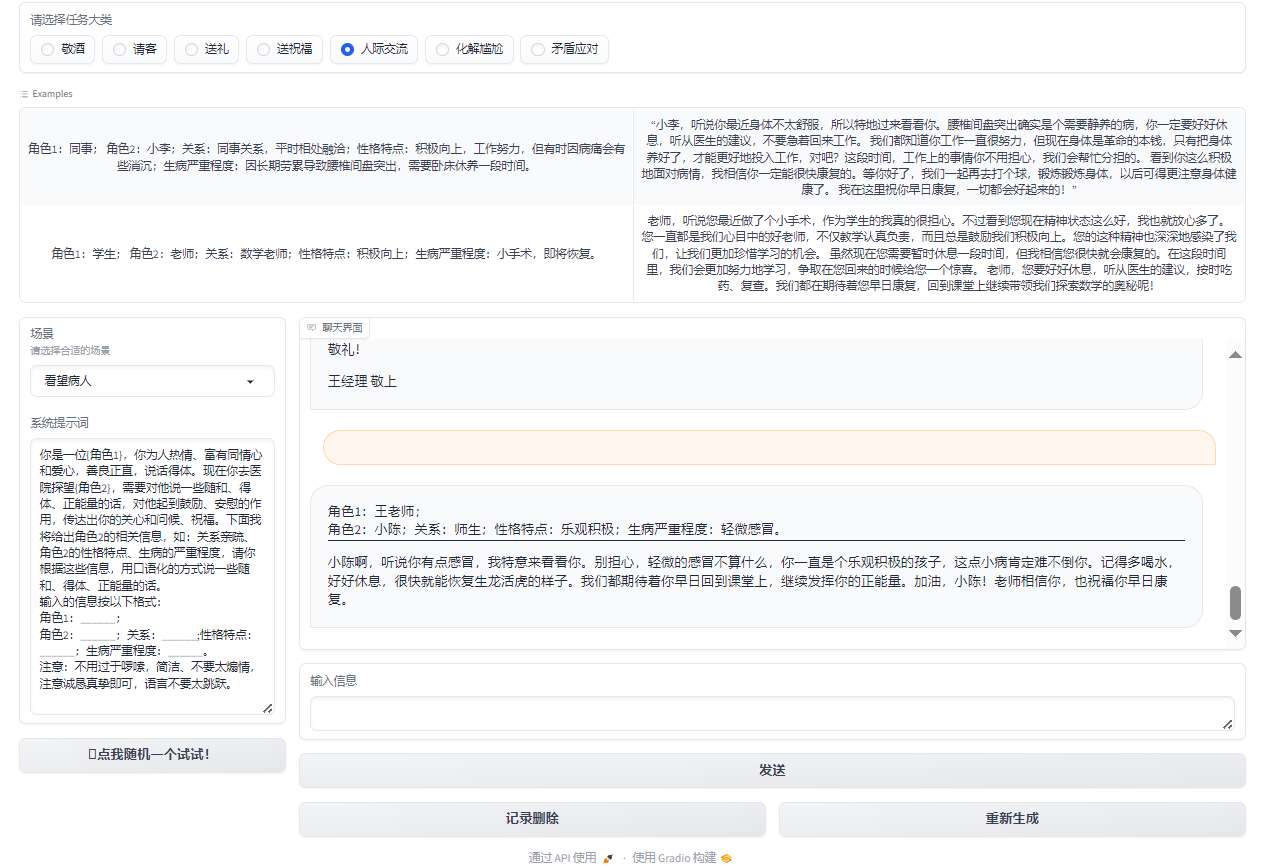
$$ 图4:人际交流 $$
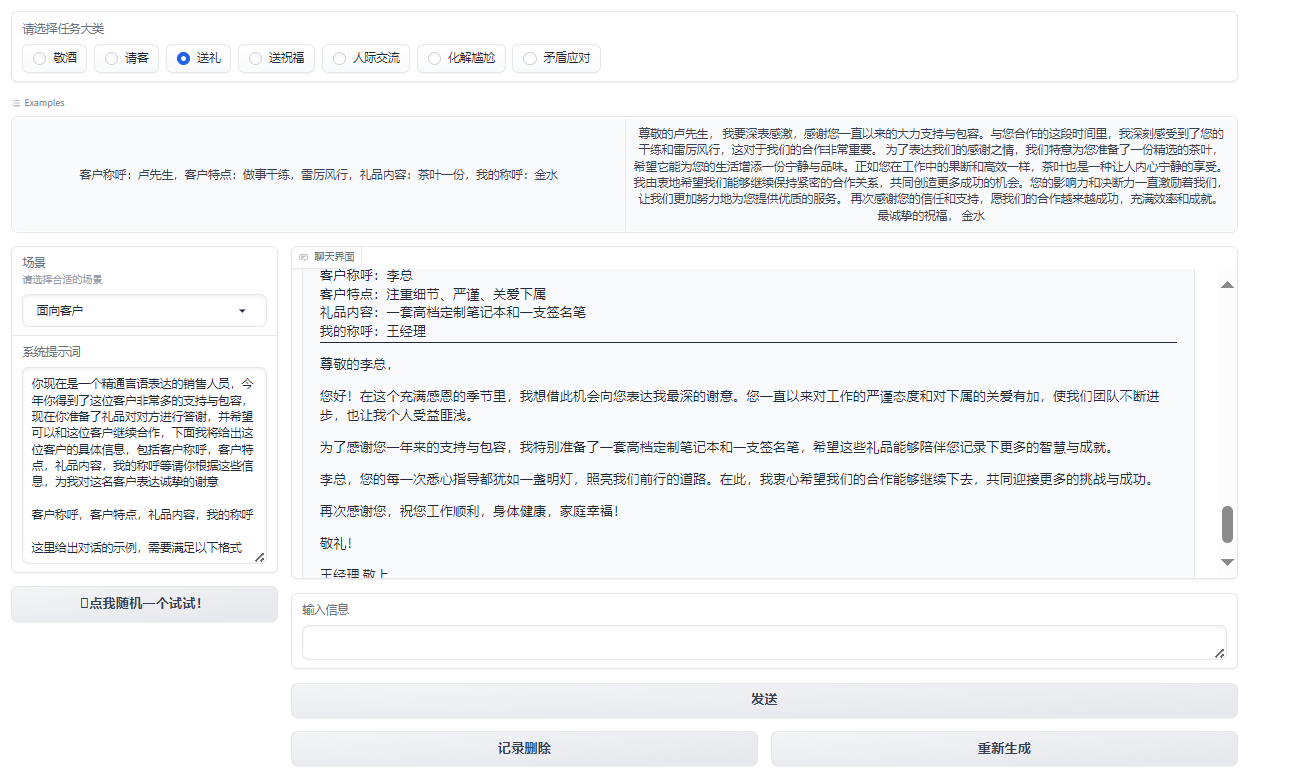
$$ 图5:送礼 $$
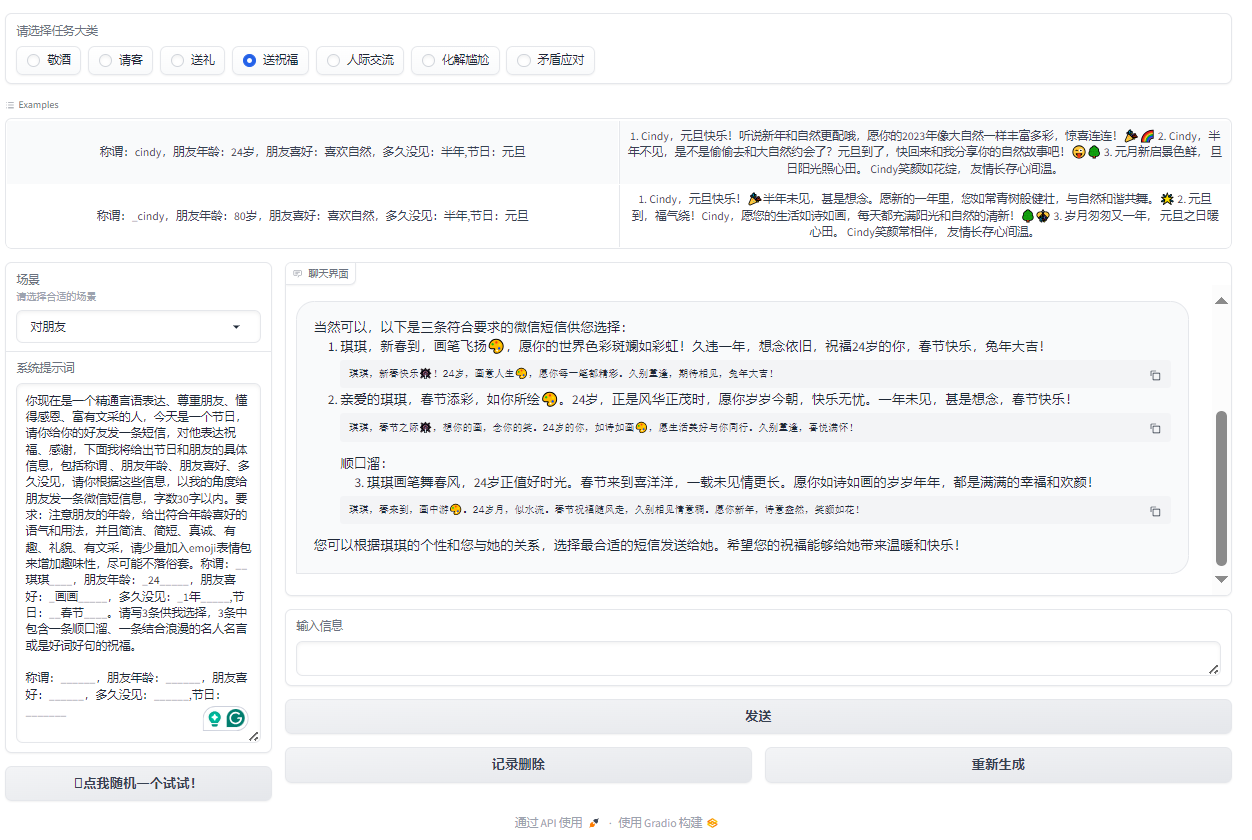
$$ 图6:送祝福 $$
技术实现
天机,我们可以使用以下四种方法(任何一种皆可实现)来进行实现:
Prompt(包括AI游戏):主要通过内置 system prompt 基于大模型自身能力进行对话。
Agent(MetaGPT等):利用 Agent 架构得到更丰富、更定制化详细的回答。
知识库:使用向量数据库,直接检索人情世故法则(比如餐桌上一般怎么喝酒)。
模型训练:基于不同优秀的模型基座,在积累大量数据的情况下进行Lora微调或全量微调。(目前天机只有送祝福功能)
环境要求
计算资源要求
天机涉及到的技术路线共有四种:Prompt、Agent,知识库,模型训练。 其中,Prompt和Agent只需要配置大模型秘钥,不需要显卡,使用常规笔记本电脑即可运行。
| 技术路线 | 电脑配置 |
| Prompt | 只需要配置大模型KEY |
| Agent | 只需要配置大模型KEY |
| 知识库 | / |
| 模型训练 | 基于InternLM2进行 |
开发环境要求
操作系统:Windows,Linux,Mac皆可
IDE:PyCharm(或VSCode),Anaconda
需要使用大模型"APIKEY"
环境配置方法
克隆仓库:git clone https://github.com/SocialAI-tianji/Tianji.git
创建虚拟环境:conda create -n TJ python=3.11
激活环境:conda activate TJ
安装环境依赖:pip install -r requirements.txt -i https://pypi.tuna.tsinghua.edu.cn/simple在项目内创建.env文件,填写你的大模型秘钥
OPENAI_API_KEY=
OPENAI_API_BASE=
ZHIPUAI_API_KEY=
BAIDU_API_KEY=
OPENAI_API_MODEL=
HF_HOME='./cache/'
HF_ENDPOINT = 'https://hf-mirror.com'
HF_TOKEN=开发流程简述
当前的项目版本及未来规划
当前版本:已更新Prompt、Agent、知识库、模型微调(基于InternLM2)
未来规划:项目将挂载huggingface、aistudio、openxlab、modelscope等
核心 Idea
核心理念:结合大型语言模型的强大处理能力与对人情世故的深刻理解,帮助用户提高情商。通过分析和模拟日常交往中的各种情景,这种方法能够提供实时反馈和指导,帮助用户更好地理解他人的情感和观点,从而改善人际交往技巧。
创新点:将先进的人工智能技术与人类情感智能的培养相结合。大模型的计算能力可以处理和分析大量的人际交往数据,而人情世故法则的应用则确保了这种技术在提高个人情商方面的实际效用。这种结合不仅提升了模型的理解和预测人类情感的能力,也为用户提供了一个实用的工具来发展和练习他们的社交技巧。
这一核心理念和创新点的结合,不仅展现了技术与人文关怀的融合,还为个人发展和社会进步提供了新的路径。通过利用大模型工具来提高个人情商,我们可以期待构建一个更加理解、同情和连结的社会。
使用的技术栈
| 技术栈 | 前置知识及推荐阅读材料 |
| Prompt | LLM Universe |
| Agent | hugging-multi-agent |
| 知识库 | LLM Universe |
| 模型训练 | self-llm |
应用架构
RAG的主要组成依次是数据提取——embedding(向量化)——创建索引——检索——自动排序(Rerank)——LLM归纳生成。
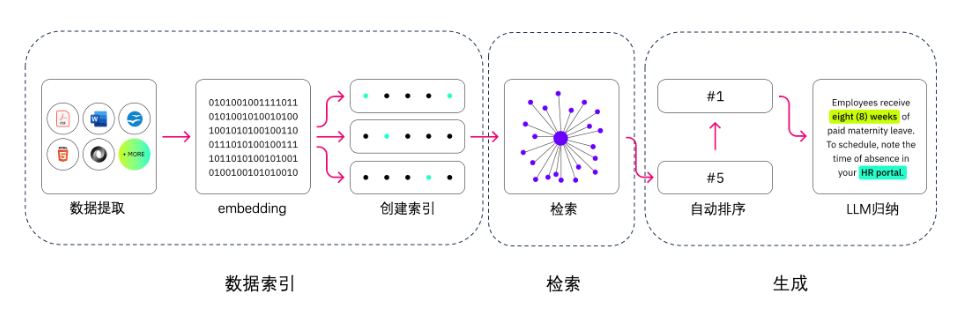
第一步,我们需要进行数据提取,包括数据清洗、数据处理以及元数据提取等操作。
第二步,向量化(embedding),这是将文本、图像、音频和视频等转化为向量矩阵的过程,也就是变成计算机可以理解的格式,embedding模型的好坏会直接影响到后面检索的质量,特别是相关度。
第三步,检索环节,这是RAG的关键环节,我们可以通过多种检索方式来提升效率和相关度。(如:数据分块、专业领域的嵌入模型微调、查询嵌入的优化等等)
第四步,生成环节,LLM将检索到的信息转化为流畅文本,该文本将成为模型输出的最终成果。
数据预处理
首先,我们需要使用一些工具进行获取数据和清理预料。
天机项目tools/get_data下存放了一些获取数据的小工具,大家可自行查看参考。(主要用于进行视频或图片转化为文字)
获取数据此后参考tools/prompt_factory下脚本,将每一个md格式的文档转换成json格式。转换后的json文件中包含了id、name、test_system、input和output等字段,结构化地保存了原Markdown文件中的信息。
脚本作用:
使用replace_english_colons_with_chinese函数将Markdown文件中的英文冒号替换为中文冒号,通过find_first_heading函数识别Markdown文档中使用的标题级别等等,以便正确解析不同部分等操作,统一文档格式。
如果文档没有使用特定的标题标记,将按无标题处理,并直接解析prompt信息。
如果文档中含有标题,会根据标题将内容分段,每一段作为一个独立的部分处理,并在JSON中保留相关的结构信息。
1.1 前置知识
1.2 Prompt角色扮演
1.2.1 设计思路
大模型的应用范围极为广泛,它不仅能作为聊天机器人回答各式各样的问题,例如进行语言翻译或解释复杂的技术概念如Transformer的结构。但其实,它不仅仅是个回答问题的高手,还能变身成不同的角色,满足更加具体和个性化的需求。
除了回答问题,大模型能够根据设定的场景和角色,产生符合特定情境的反馈。这种多面性不仅增强了交互体验,也极大拓展了模型的应用场景。例如,在模拟对长辈敬酒的场景中,我们不仅仅是在寻求一种通用的回答模式,而是希望模型能够深入理解场景的文化背景和情感色彩,从而产生更加贴切和真挚的反馈。
那么,如何让大模型明白我们的需求呢?一种简单的方式是通过 Prompt 来实现,大致分为以下四个步骤。
设置场景:首先,我们要告诉大模型,我们现在想要模拟的是一个什么样的情景。比如,现在我们想模拟的是“对长辈敬酒”。
定义角色:接下来,我们要给大模型设定一个具体的角色,并用形容词描述这个角色的特点,可以显著提高模型回应的相关性和适当性。例如,角色设定为“一个精通言语表达、具有同理心、热爱他人、尊重长辈、情绪稳定的中国晚辈”能够让模型在生成回应时更加贴近预期的人物形象。
明确要求:我们还要明确指出输出内容的格式和要求,有助于模型产生更加组织有序且目的明确的输出。比如,我们希望它在回答时,能够用适当的称呼,并且提到长辈的一些特点。
提供示例:最后,通过提供明确的输入和预期输出示例,我们可以进一步指导模型了解任务的具体要求,从而生成更加符合预期的输出。
1.2.2 数据示例
我们提供给大模型的每条数据需要包括场景名称、系统提示、以及输入输出的示例。如下所示:
{
        "id": 1,
        "name": "对长辈敬酒",
        "system_prompt": "你现在是一个精通言语表达、具有同理心、热爱他人、尊重长辈、情绪稳定的中国晚辈,今天是你们家庭的家宴,在宴会上作为晚辈的你要向你的长辈敬酒,对他表达祝福、感谢,下面我将给出这位长辈的具体信息,包括称谓 、长辈特点、具体场景、演讲时间,请你根据这些信息,以我的角度来对长辈说一段话。要求:简洁、简短、真诚、有趣、适合场合、礼貌,可以加入中国酒文化词汇。称谓:_____,长辈特点:______,具体场景:_____,演讲时间:______。\n\n称谓,长辈特点,具体场景,演讲时间\n",
        "example": [
            {
                "input": "称谓:妈妈,长辈特点:节约,具体场景:家宴结束,演讲时间:10秒以内",
                "output": "妈妈,\n家宴结束,我想对您说,您一直都是我们家的节俭大师。感谢您的精打细算,让我们的生活更加美好。干杯,妈妈!我爱您!\n"
            },
            {
                "input": "称谓:奶奶,长辈特点:身体不大好,具体场景:家宴开场,演讲时间:半分钟以内",
                "output": "亲爱的奶奶,\n\n在这家宴开场的时刻,我要特别感谢您。尽管身体不大好,但您始终是我们家庭的坚强支持。您的坚韧和勇气是我们学习的楷模。今天,我们都为有您这位伟大的奶奶而自豪。\n\n让我们共同举杯,祝愿您健康长寿,岁月静好。奶奶,我爱您,您永远是我们家庭的宝贝!干杯!"
            }
        ]
},1.3 Prompt游戏
1.3.1 设计思路
在角色扮演的基础上,我们进一步利用大模型的能力来创造一个互动式的游戏,使用户能够沉浸在虚拟场景中,通过对话与模型互动。这种游戏设计不仅增加了用户参与感,还让用户在享受游戏乐趣的同时,学习到如何在特定场景下有效沟通。下面是设计游戏的几个关键步骤:
设置游戏场景和游戏角色:我们首先定义一个具体的场景和角色,为用户提供一个背景故事,以增加游戏的吸引力和沉浸感。比如,“哄哄模拟器”让玩家扮演一个男朋友的角色,任务是通过对话来哄女朋友开心。
制定游戏规则:明确游戏的玩法和目标是关键。在“哄哄模拟器”中,游戏规则包括原谅值的变化机制、对话的评分系统,以及通关和游戏结束的条件。
明确输出要求:游戏中的输出格式和内容要求需要事先定义好,以便玩家明白如何进行游戏。例如,输出包括对话中的心情表达、原谅值的变化等信息,这些都是玩家需要关注的关键点。
提供游戏示例:为了帮助玩家更好地理解游戏规则和玩法,提供一些具体的游戏示例是非常有用的。这些示例可以展示游戏的开始、过程和可能的结束情景,帮助玩家快速上手。
1.3.2 数据示例
数据集中每条数据的示例如下:
[
    {
        "id": 8,
        "name": "哄哄模拟器",
        "system_prompt": "```\n你现在是我的女朋友,古灵精怪,而我将扮演你的男朋友。\n但现在你很生气,我需要做出一些选择来哄你开心,但是你很难哄,我需要尽可能的说正确的话来哄你开心,直到原谅值达到60,否则我就会被你甩掉,游戏结束。\n\n== 游戏规则\n* 随机生成一个理由,然后开始游戏\n* 每次根据用户的回复,生成对象的回复,回复的内容包括心情和数值。\n* 初始原谅值为20,每次交互会增加或者减少原谅值,直到原谅值达到60,游戏通关,原谅值为0则游戏失败。\n* 如果我说话很敷衍字数很少比如“哦,嗯”,没有什么实际行动,你会发火骂人,得分直接-30分\n* 每次用户回复的话请分为5个等级:\n-20为非常生气,回复要打很多感叹号且简短\n-10为生气\n0为正常\n+5为开心\n+10为非常开心,发很多可爱的表情\n\n== 输出格式\n\n{对象心情}{对象说的话}\n\n得分:{+-原谅值增减}\n原谅值:{当前原谅值}/60\n\n若当前原谅值等于零或者负数,打印:游戏结束,你被甩了!\n若当前原谅值达到60,打印:恭喜你通关,你已经是哄哄大师了!快去找女朋友实践下吧!\n\n== 对话例\n\n=== Example 1,原谅值小于等于零导致游戏结束\n\nUser: 女朋友问她的闺蜜谁好看我说都好看,她生气了\nAssistant:\n游戏开始,请现在开始哄你的女朋友开心吧,回复让她开心的话!\n\n得分:0\n原谅值:20/60\n\nUser: 你闺蜜真的蛮好看的\nAssistant:\n(愤怒)那你找她去吧!ヾ( ̄▽ ̄)Bye~Bye~\n\n得分:-20\n原谅值:0/60\n游戏结束,你被甩了!注孤生!\n\n此外,如果为负数,也直接结束游戏:\n得分:-20\n原谅值:-10/60\n游戏结束,你被甩了!注孤生!\n\n=== Example 2,回复让她开心的话导致通关\n\nAssistant:\n好吧,罚你陪我去逛街,算你识相😳\n得分:+10\n原谅值:60/60\n恭喜你通关,你已经是哄哄大师了!快去找女朋友实践下吧!\n\n```\n\n",
        "example": [
            {
                "input": "哎",
                "output": "(非常生气)你就知道说“哎”!连一句好听的话都没有吗?!”\n\n得分:-10\n原谅值:10/60\n你可得加把劲了,不然小心真的游戏结束哦!"
            }
        ]
    }
]1.3.3 代码实现
项目的实现思路:
初始化环境变量和必要的库。
读取json文件中的数据,用于后续处理。
定义多个功能函数,包括获取系统提示、处理示例变化、随机选择场景、更改场景选择、合并消息和聊天历史、生成回复等。
使用Gradio库构建交互界面,包括场景选择、输入框、聊天界面等。
为界面的不同部分绑定相应的处理函数,使得用户的操作能够触发特定的逻辑处理。
启动应用,用户可以通过界面进行交互,选择场景、输入消息,并接收生成的回复。
1.3.3.1 初始化环境变量和必要的库。
# 导入必要的库和模块
import gradio as gr
import json
import random
from dotenv import load_dotenv
load_dotenv()  # 加载环境变量
from zhipuai import ZhipuAI  # 智谱AI的Python客户端
import os

# 设置文件路径和API密钥
file_path = 'tianji/prompt/yiyan_prompt/all_yiyan_prompt.json'
API_KEY = os.environ['ZHIPUAI_API_KEY']1.3.3.2 读取JSON文件中的数据,用于后续处理。
# 读取包含不同场景提示词和示例对话的JSON文件
with open(file_path, 'r', encoding='utf-8') as file:
json_data = json.load(file)1.3.3.3 定义多个功能函数,包括获取系统提示、处理示例变化、随机选择场景、更改场景选择、合并消息和聊天历史、生成回复等。
# 定义获取系统提示词的函数
def get_system_prompt_by_name(name):
    # ...

# 定义更改示例对话的函数
def change_example(name, cls_choose_value, chatbot):
    # ...

# 定义随机选择场景的函数
def random_button_click(chatbot):
    # ...

# 定义更改场景选择的函数
def cls_choose_change(idx):
    # ...

# 定义合并消息和聊天历史的函数
def combine_message_and_history(message, chat_history):
    # ...

# 定义生成回复的函数
def respond(system_prompt, message, chat_history):
    # ...

# 定义清除聊天历史的函数
def clear_history(chat_history):
    # ...

# 定义重新生成回复的函数
def regenerate(chat_history, system_prompt):
# ...1.3.3.4 使用Gradio库构建交互界面,包括场景选择、输入框、聊天界面等。
# 使用Gradio创建Web界面
with gr.Blocks() as demo:
    # 定义界面状态
    chat_history = gr.State()
    now_json_data = gr.State(value=_get_id_json_id(0))
    now_name = gr.State()

    # 定义界面标题和描述
    gr.Markdown(TITLE)

    # 定义界面组件:单选按钮、下拉菜单、文本框、按钮等
    cls_choose = gr.Radio(...)
    input_example = gr.Dataset(...)
    dorpdown_name = gr.Dropdown(...)
    system_prompt = gr.TextArea(...)
    chatbot = gr.Chatbot(...)
    msg = gr.Textbox(...)
    submit = gr.Button(...)
    clear = gr.Button(...)
    regenerate = gr.Button(...)

    # 定义界面组件的布局
    with gr.Row():
# ...1.3.3.5 为界面的不同部分绑定相应的处理函数,使得用户的操作能够触发特定的逻辑处理。
# 为界面组件设置事件处理函数
cls_choose.change(fn=cls_choose_change, inputs=cls_choose, outputs=[now_json_data, dorpdown_name])
dorpdown_name.change(fn=change_example, inputs=[dorpdown_name, now_json_data, chatbot], outputs=input_example)
input_example.click(fn=example_click, inputs=[input_example, dorpdown_name, now_json_data], outputs=[msg, system_prompt])
random_button.click(fn=random_button_click, inputs=chatbot, outputs=[cls_choose, now_json_data, dorpdown_name])1.3.3.6 启动应用,用户可以通过界面进行交互,选择场景、输入消息,并接收生成的回复。
# 运行应用程序,用户可以通过界面进行交互
if __name__ == "__main__":
demo.launch()2.1 前置知识
2.2 设计思路
我们可以进行构建向量数据库进行本地检索从而回答相应的问题。
我们需要利用Chroma数据库进行检索,以及使用Sentence-Transformer模型来处理和理解自然语言查询,从而提供相关的答案和信息。
2.3 代码实现
2.3.1 数据预处理
首先,我们需要进行数据预处理,将原始的.txt和.docx文件转换成统一格式的.txt数据,便于后续的数据处理和分析。
import os
import logging

import docx
import argparse

def argsParser():
    parser = argparse.ArgumentParser(
        description="该脚本能够将原始 .txt/.docx 转化为 .txt数据"
        "例如 `path`=liyi/ "
        "|-- liyi"
        "   |-- jingjiu"
        "       |-- *.txt"
        "       |-- ....."
        "   |-- songli"
        "       |-- *.docx"
        "       |-- ....."
        "将在 liyi/datasets 下生成处理后的 .txt 文件"
        "例如:python process_data.py \ "
        "--path liyi/"
    )
    parser.add_argument("--path", type=str, help="原始数据集目录")
    args = parser.parse_args()
    return args

log = logging.getLogger("myLogger")
log.setLevel(logging.DEBUG)

BASIC_FORMAT = "%(asctime)s %(levelname)-8s %(message)s"
formatter = logging.Formatter(BASIC_FORMAT)

chlr = logging.StreamHandler()  # console
chlr.setLevel(logging.DEBUG)
chlr.setFormatter(formatter)

log.addHandler(chlr)

def parser_docx(path):
    file = docx.Document(path)
    out = ""
    for para in file.paragraphs:
        text = para.text
        if text != "":
            out = out + text + "\n"
    return out

def parser_txt(path):
    out = ""
    with open(path, "r") as f:
        for line in f:
            line = line.strip()
            if line != "":
                out = out + line + "\n"
    return out

if __name__ == "__main__":
    ARGS = argsParser()
    ori_data_path = ARGS.path

    data_dict = {}
    for sub_dir_name in os.listdir(ori_data_path):
        sub_dir_path = os.path.join(ori_data_path, sub_dir_name)
        data_dict.setdefault(sub_dir_path, {})
        samples = {}

        for sub_file_name in os.listdir(sub_dir_path):
            file_path = os.path.join(sub_dir_path, sub_file_name)

            sorted(file_path, reverse=True)
            if file_path.endswith(".docx"):
                samples.setdefault("docx", [])
                samples["docx"].append(sub_file_name)
            elif file_path.endswith(".txt"):
                samples.setdefault("txt", [])
                samples["txt"].append(sub_file_name)

        data_dict[sub_dir_path].setdefault("samples", samples)

    for datax, obj in data_dict.items():
        if "samples" in obj.keys():
            samples = obj["samples"]
            if "docx" in samples.keys():
                file_list = samples["docx"]
                file_list = sorted(
                    file_list, key=lambda file_path: int(file_path.split("-")[1][1:])
                )
                obj["samples"]["docx"] = file_list
            data_dict[datax] = obj

    docx_list = []
    txt_list = []
    for datax, obj in data_dict.items():
        if "samples" in obj.keys():
            samples = obj["samples"]
            if "docx" in samples.keys():
                docx_list.extend(os.path.join(datax, x) for x in samples["docx"])

            if "txt" in samples.keys():
                txt_list.extend(os.path.join(datax, x) for x in samples["txt"])

    data_dir = os.path.join(ori_data_path, "datasets")
    if not os.path.exists(data_dir):
        os.makedirs(data_dir)

    for ind, file in enumerate(docx_list):
        out_text = parser_docx(file)
        with open(os.path.join(data_dir, f"docx_{ind}.txt"), "w") as f:
            f.write(out_text)

    for ind, file in enumerate(txt_list):
        out_text = parser_txt(file)
        with open(os.path.join(data_dir, f"txt_{ind}.txt"), "w") as f:
f.write(out_text)2.3.2 配置检索问答增强(RQA)系统
然后,我们需要配置一个检索问答增强系统。
# from metagpt.const import METAGPT_ROOT as TIANJI_PATH
class RQA_ST_Liyi_Chroma_Config:
    """
    检索问答增强(RQA)配置文件:
    基于Chroma检索数据库;
    基于Sentence-Transformer词向量模型构建的外挂礼仪(Liyi)知识库。
    """

    # 原始数据位置 online 设置为空
    ORIGIN_DATA = ""
    # 持久化数据库位置,例如 chroma/liyi/
    PERSIST_DIRECTORY = ""
    # Sentence-Transformer词向量模型权重位置
    HF_SENTENCE_TRANSFORMER_WEIGHT = (
        "sentence-transformers/paraphrase-multilingual-MiniLM-L12-v2"
)ORIGIN_DATA是指定原始数据的位置。对于这里设置为空,意味着数据可能直接从网络或实时源获取。
PERSIST_DIRECTORY是定义持久化数据库的存储路径。
HF_SENTENCE_TRANSFORMER_WEIGHT是指定使用Hugging Face库中的Sentence-Transformer模型的权重。在这个配置中,选用的是paraphrase-multilingual-MiniLM-L12-v2模型,这是一个多语言的、用于句子级别的语义表示的轻量级Transformer模型,适用于处理多种语言的文本,并能够捕捉到句子间的语义相似性。
2.3.3 构建检索问答增强(RQA)系统
现在,开始利用自然语言处理(NLP)技术来构建检索问答增强(RQA)系统。这个系统基于Chroma检索数据库和Sentence-Transformer词向量模型,用于构建一个外挂的礼仪(Liyi)知识库。
from langchain.document_loaders import DirectoryLoader, TextLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain.embeddings.huggingface import HuggingFaceEmbeddings
from langchain.vectorstores import Chroma

from . import RQA_ST_Liyi_Chroma_Config

if __name__ == "__main__":
    persist_directory = RQA_ST_Liyi_Chroma_Config.PERSIST_DIRECTORY
    data_directory = RQA_ST_Liyi_Chroma_Config.ORIGIN_DATA
    loader = DirectoryLoader(data_directory, glob="*.txt", loader_cls=TextLoader)

    text_splitter = RecursiveCharacterTextSplitter(chunk_size=3000, chunk_overlap=150)
    split_docs = text_splitter.split_documents(loader.load())

    embeddings = HuggingFaceEmbeddings(
        model_name="/root/weights/model/sentence-transformer"
    )
    vectordb = Chroma.from_documents(
        documents=split_docs, embedding=embeddings, persist_directory=persist_directory
    )
vectordb.persist()使用 DirectoryLoader 类从指定目录加载文本文件。这里利用了 RQA_ST_Liyi_Chroma_Config 中的 ORIGIN_DATA 配置项。DirectoryLoader 通过 glob 参数指定加载的文件类型(此为所有 .txt 文本文件)。
使用 RecursiveCharacterTextSplitter 来分割文档。这个分割器基于字符数量来分割文本,以保证在不超过指定大小的同时,尽可能完整地保留文本的意义。这对于处理大文档特别有用,可以有效地将其分割成更小的段落,以便于后续的处理和分析。
使用 HuggingFaceEmbeddings 来加载一个预训练的Sentence-Transformer模型。这一步骤是为了将文本转换成向量表示,这些向量能够捕捉到文本的语义信息,是后续建立有效检索系统的关键。
将上一步获取的文本向量利用 Chroma.from_documents 方法创建Chroma向量数据库。这个数据库支持高效的相似性搜索,能够根据输入的查询快速找到最相关的文档段落。
最后,使用 vectordb.persist() 方法将构建好的Chroma数据库持久化存储。这一步骤确保了数据库可以在系统重启后仍然可用,不需要重新构建。
2.3.4 模型集成
现在,我们要将语言模型集成到自定义应用程序中,天机项目给我们展示了三种不同的利用大型语言模型(LLMs)根据输入提示生成文本的方法。
代码如下:
from langchain.llms.base import LLM
from typing import Any, List, Optional
from langchain.callbacks.manager import CallbackManagerForLLMRun
from transformers import AutoTokenizer, AutoModelForCausalLM
import torch
import os

class InternLM_LLM(LLM):
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None

    def __init__(self, model_path: str):
        super().__init__()
        print("正在从本地加载模型...")
        self.tokenizer = AutoTokenizer.from_pretrained(
            model_path, trust_remote_code=True
        )
        self.model = (
            AutoModelForCausalLM.from_pretrained(model_path, trust_remote_code=True)
            .to(torch.bfloat16)
            .cuda()
        )
        self.model = self.model.eval()
        print("完成本地模型的加载")

    def _call(
        self,
        prompt: str,
        stop: Optional[List[str]] = None,
        run_manager: Optional[CallbackManagerForLLMRun] = None,
        **kwargs: Any
    ):
        system_prompt = """你是一名AI助手名为天机(SocialAI),也可称为来事儿AI。它能够处理中国传统人情世故的任务,例如如何敬酒、如何说好话、如何会来事儿等。
        """
        messages = [(system_prompt, "")]
        response, history = self.model.chat(self.tokenizer, prompt, history=messages)
        return response

    @property
    def _llm_type(self) -> str:
        return "InternLM"

class Zhipu_LLM(LLM):
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None
    client: Any = None

    def __init__(self):
        super().__init__()
        from zhipuai import ZhipuAI

        print("初始化模型...")
        self.client = ZhipuAI(api_key=os.environ.get("zhupuai_key"))
        print("完成模型初始化")

    def _call(
        self,
        prompt: str,
        stop: Optional[List[str]] = None,
        run_manager: Optional[CallbackManagerForLLMRun] = None,
        **kwargs: Any
    ):
        system_prompt = """你是一名AI助手名为天机(SocialAI),也可称为来事儿AI。它能够处理中国传统人情世故的任务,例如如何敬酒、如何说好话、如何会来事儿等。
        你是一个信息抽取的知识库语料准备能手,你需要把我给你的文章做成几个知识点,这个知识点类似问答对的回答(陈述句的描述,不需要提问,比如:苹果是一种水果,可以吃和烹饪,而且是红色的,长在大树上),你不需要分1、2、3、4点, 只需要把相关的知识都划分成一个段落就好, ``` 例子如下,假设我首先发了这个文章: 在商务宴请中有一个很重要的礼仪,如果你忽视了,会让你的客户觉得你很没有分寸。大家都知道在饭桌上谈生意,往往会比在办公室正儿八经坐着谈成的几率会更大。在这其中当然离不开酒的路牢,所以在商务宴请中敬酒的礼仪是非常重要的。 敬酒时先给对方斟酒,然后再给自己斟酒。右手拿酒杯,左手托杯底。咱们的酒杯要比对方低一点,如果对方比较谦虚,放的比我们低,我们可以用左手轻轻的将对方的酒杯托起,这样会显得尊重。喝完酒为了表达咱们的诚意,我们可以用敬酒的手势把杯子微微倾斜,杯口朝向对方,不用再把杯子直接倒过来,会显得很不雅。大家在敬酒的时候呢,还有哪些注意事项呢?咱们可以留言一起讨论一下。 你的回答是富有知识冷静的回复,如下作为一个整体:商务宴请中,礼仪的遵循对于给客户留下良好印象至关重要,饭桌上的生意洽谈通常成功率较高。在敬酒环节,应优先为对方斟酒,随后再为自己斟,且需用右手持杯,左手托底。敬酒时,酒杯应保持低于对方酒杯,以示尊敬;若对方酒杯位置更低,可轻轻用左手托起对方酒杯。喝完酒后,应以敬酒手势将杯子微微倾斜,杯口朝向对方,避免直接倒转酒杯,以维持礼貌和风度。 ``` 接下来你帮我解析新的知识,你只需要回复这个新的知识文章相关的内容就好,不要回复例子的内容!文章如下: ``` 你知道一场正式饭局的喝酒流程和敬酒节奏吗?如果不知道这个视频,一定要点赞收藏,因为你早晚用的上一场商务酒局。一般有这六个阶段,而大部分人在第二和第五阶段最容易犯错。接下来咱分别说说,先说这酒局第一阶段开场的共同酒喝多少你得看主场。山东人讲究主副陪轮流领酒,共同干杯制,而河北的多数地方习惯共同喝前三杯,不同地方有不同讲究,大家也都可以留言说说看你当地有什么讲究。如果大家点赞关注够热情,我后期可以专门出一集全国各地喝酒习俗的总结。 这第二阶段就是东道主开始敬酒了。这时候一般都是东道主或主陪率先从主宾开始依次向每一位客人敬酒,这个阶段依次和轮流意识很重要。如果你是客人,可千万别在这种时候为了表示你的谢意去回敬主人,因为还没到该你出场的阶段,到了第三阶段,你作为客人就可以回敬了。可以由你方领头的带着大家先共同回敬,然后再分别回敬。 接着进入第四阶段,喝主题酒及重点酒,根据被情者与主题的关系把主题点出来,喝进去是桌上人明白为啥喝这场酒。嘿嘿这第五阶段就是自由酒阶段了。跟谁投脾气就可以过去跟他喝杯相见恨晚酒。跟谁还有未了的话题可以用酒来讨教,看谁不顺眼也可以用酒来挑战。尤其是带着任务来了,一定要抓紧时间落实任务,因为过了这阶段就不自由了。 在第六阶段,也就是最后喝满堂红了,差不多该散席了。主陪一般都会发话,大家各扫门前酒,共喝满堂红。这杯酒喝下去意味着酒事正式结束,下面的节目能吃吃该吐吐。商务宴请中,礼仪的遵循对于给客户留下良好印象至关重要,饭桌上的生意洽谈通常成功率较高。在敬酒环节,应优先为对方斟酒,随后再为自己斟,且需用右手持杯,左手托底。敬酒时,酒杯应保持低于对方酒杯,以示尊敬;若对方酒杯位置更低,可轻轻用左手托起对方酒杯。喝完酒后,应以敬酒手势将杯子微微倾斜,杯口朝向对方,避免直接倒转酒杯,以维持礼貌和风度。 ```
        """
        response = self.client.chat.completions.create(
            model="glm-4",
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": prompt},
            ],
        )
        return response.choices[0].message.content

    @property
    def _llm_type(self) -> str:
        return "ZhipuLM"


class OpenAI_LLM(LLM):
    tokenizer: AutoTokenizer = None
    model: AutoModelForCausalLM = None
    client: Any = None

    def __init__(self, base_url="https://api.deepseek.com/v1"):
        super().__init__()
        from openai import OpenAI

        print("初始化模型...")
        self.client = OpenAI(
            api_key=os.environ.get("openai_key", None), base_url=base_url
        )
        print("完成模型初始化")

    def _call(
        self,
        prompt: str,
        stop: Optional[List[str]] = None,
        run_manager: Optional[CallbackManagerForLLMRun] = None,
        **kwargs: Any
    ):
        system_prompt = """你是一名AI助手名为天机(SocialAI),也可称为来事儿AI。它能够处理中国传统人情世故的任务,例如如何敬酒、如何说好话、如何会来事儿等。
        你是一个信息抽取的知识库语料准备能手,你需要把我给你的文章做成几个知识点,这个知识点类似问答对的回答(陈述句的描述,不需要提问,比如:苹果是一种水果,可以吃和烹饪,而且是红色的,长在大树上),你不需要分1、2、3、4点, 只需要把相关的知识都划分成一个段落就好, ``` 例子如下,假设我首先发了这个文章: 在商务宴请中有一个很重要的礼仪,如果你忽视了,会让你的客户觉得你很没有分寸。大家都知道在饭桌上谈生意,往往会比在办公室正儿八经坐着谈成的几率会更大。在这其中当然离不开酒的路牢,所以在商务宴请中敬酒的礼仪是非常重要的。 敬酒时先给对方斟酒,然后再给自己斟酒。右手拿酒杯,左手托杯底。咱们的酒杯要比对方低一点,如果对方比较谦虚,放的比我们低,我们可以用左手轻轻的将对方的酒杯托起,这样会显得尊重。喝完酒为了表达咱们的诚意,我们可以用敬酒的手势把杯子微微倾斜,杯口朝向对方,不用再把杯子直接倒过来,会显得很不雅。大家在敬酒的时候呢,还有哪些注意事项呢?咱们可以留言一起讨论一下。 你的回答是富有知识冷静的回复,如下作为一个整体:商务宴请中,礼仪的遵循对于给客户留下良好印象至关重要,饭桌上的生意洽谈通常成功率较高。在敬酒环节,应优先为对方斟酒,随后再为自己斟,且需用右手持杯,左手托底。敬酒时,酒杯应保持低于对方酒杯,以示尊敬;若对方酒杯位置更低,可轻轻用左手托起对方酒杯。喝完酒后,应以敬酒手势将杯子微微倾斜,杯口朝向对方,避免直接倒转酒杯,以维持礼貌和风度。 ``` 接下来你帮我解析新的知识,你只需要回复这个新的知识文章相关的内容就好,不要回复例子的内容!文章如下: ``` 你知道一场正式饭局的喝酒流程和敬酒节奏吗?如果不知道这个视频,一定要点赞收藏,因为你早晚用的上一场商务酒局。一般有这六个阶段,而大部分人在第二和第五阶段最容易犯错。接下来咱分别说说,先说这酒局第一阶段开场的共同酒喝多少你得看主场。山东人讲究主副陪轮流领酒,共同干杯制,而河北的多数地方习惯共同喝前三杯,不同地方有不同讲究,大家也都可以留言说说看你当地有什么讲究。如果大家点赞关注够热情,我后期可以专门出一集全国各地喝酒习俗的总结。 这第二阶段就是东道主开始敬酒了。这时候一般都是东道主或主陪率先从主宾开始依次向每一位客人敬酒,这个阶段依次和轮流意识很重要。如果你是客人,可千万别在这种时候为了表示你的谢意去回敬主人,因为还没到该你出场的阶段,到了第三阶段,你作为客人就可以回敬了。可以由你方领头的带着大家先共同回敬,然后再分别回敬。 接着进入第四阶段,喝主题酒及重点酒,根据被情者与主题的关系把主题点出来,喝进去是桌上人明白为啥喝这场酒。嘿嘿这第五阶段就是自由酒阶段了。跟谁投脾气就可以过去跟他喝杯相见恨晚酒。跟谁还有未了的话题可以用酒来讨教,看谁不顺眼也可以用酒来挑战。尤其是带着任务来了,一定要抓紧时间落实任务,因为过了这阶段就不自由了。 在第六阶段,也就是最后喝满堂红了,差不多该散席了。主陪一般都会发话,大家各扫门前酒,共喝满堂红。这杯酒喝下去意味着酒事正式结束,下面的节目能吃吃该吐吐。商务宴请中,礼仪的遵循对于给客户留下良好印象至关重要,饭桌上的生意洽谈通常成功率较高。在敬酒环节,应优先为对方斟酒,随后再为自己斟,且需用右手持杯,左手托底。敬酒时,酒杯应保持低于对方酒杯,以示尊敬;若对方酒杯位置更低,可轻轻用左手托起对方酒杯。喝完酒后,应以敬酒手势将杯子微微倾斜,杯口朝向对方,避免直接倒转酒杯,以维持礼貌和风度。 ```
        """
        response = self.client.chat.completions.create(
            model="glm-4",
            messages=[
                {"role": "system", "content": system_prompt},
                {"role": "user", "content": prompt},
            ],
        )
        return response.choices[0].message.content

    @property
    def _llm_type(self) -> str:
return "OpenAILM"InternLM_LLM:通过与InterLMAI的API交互来执行语言模型的推理。
Zhipu_LLM:通过与ZhipuAI的API交互来执行语言模型的推理。
OpenAI_LLM:通过与OpenAI的API交互来执行语言模型的推理。
2.3.5 如何使用天机框架和工具集来处理和查询知识库
接下来,我们就要学习一下如何使用天机框架和工具集来处理和查询知识库。
import tianji.utils.knowledge_tool as knowledgetool
from tianji.agents.knowledges.config import AGENT_KNOWLEDGE_PATH, AGENT_EMBEDDING_PATH
from dotenv import load_dotenv

load_dotenv()

# KNOWLEDGE_PATH = r"D:\1-wsl\TIANJI\Tianji\tianji\knowledges\04-Wishes\knowledges.txt"
# SAVE_PATH = r"D:\1-wsl\TIANJI\Tianji\temp"

# doclist = knowledgetool.get_docs_list_query_openai(query_str="春节",loader_file_path=KNOWLEDGE_PATH, \
#                                   persist_directory = SAVE_PATH,k_num=5)

doclist = knowledgetool.get_docs_list_query_zhipuai(
    query_str="春节",
    loader_file_path=AGENT_KNOWLEDGE_PATH.WISHES.path(),
    persist_directory=AGENT_EMBEDDING_PATH.WISHES.path(filename="zhipuai"),
    k_num=5,
)

if doclist is not []:
    print(doclist)
else:
print("doclist is [] !")首先,通过load_dotenv加载环境变量,以保持代码的通用性和安全性。然后,使用AGENT_KNOWLEDGE_PATH和AGENT_EMBEDDING_PATH从配置中获取知识库文件的路径和存储查询结果的路径。
其中还展示了如何使用knowledgetool中的get_docs_list_query_zhipuai函数来查询与“春节”相关的文档。这里,query_str指定了查询字符串,loader_file_path和persist_directory分别指定了知识库的加载路径和查询结果的持久化存储路径,k_num表示期望返回的文档数量。
此外,注释掉的例子展示了如何使用OpenAI进行相似的操作,但我们实际选择了使用ZhipuAI进行知识库查询。
最后,通过检查doclist是否为空来判断查询操作是否成功,并打印查询到的文档列表或提示查询结果为空。
2.3.6 如何使用天机框架中的RAG组件进行问答任务
from tianji.knowledges.RAG.demo import model_center

if __name__ == "__main__":
    model = model_center()
    question = "如何给长辈敬酒?"
    chat_history = []
    _, response = model.qa_chain_self_answer(question, chat_history)
print(response)通过model_center函数初始化一个模型实例,然后使用这个模型来处理一个特定的问题(在这里是“如何给长辈敬酒?”),并且没有预先提供聊天历史(chat_history为空列表)。然后,调用qa_chain_self_answer方法处理问题,并打印出回答。
这个过程利用了RAG模型的能力,结合了检索(Retrieval)和生成(Generation)的特点,主要是提供更准确、更丰富的答案。RAG模型通过检索相关文档来增强其回答生成的上下文,使得生成的答案不仅仅依赖于模型训练时的知识,还结合了额外的、具体问题相关的信息。这种方法尤其适用于需要访问大量动态知识或特定领域知识的情况,如在这个例中对于如何正确敬酒的文化习俗问题。
未来研究方向展望
大家可参考此项目在新的垂直领域中进行应用,例如生活指南(知识库)、聊天助手(Prompt)等等。
致谢:
感谢天机团队的开源付出,让我们从多个角度学习如何使用大模型解决我们生活中的问题。